前端第一次学 Kubernetes:一条链看懂 Deployment、Pod、Kubelet 和 containerd
不默认懂容器。从 Node.js 代码怎样变成进程开始,逐步看懂 Image、Container、Pod、Node、Deployment 和 Service。
文章目录
前端开发第一次接触 Kubernetes,往往不是因为要去做运维。
更常见的情况是:项目突然要部署到 K8s,CI/CD 里开始出现 Deployment 和 Service,线上排查问题时又会看到 Pod、Node、Kubelet 和 containerd。
现在还有 AI。你说一句“帮我写一份 Kubernetes Deployment”,几秒钟后 YAML 就出来了。kubectl apply 一跑,服务可能真的能启动。
但到了 Pod 一直 Pending、容器反复 CrashLoopBackOff,或者 Service 始终访问不通时,只会改 YAML 就不够了。你得知道,这份声明最后是怎样变成某台机器上真正运行的进程的。
这篇文章不默认你懂容器,也不从 Kubernetes 的官方定义起步。我们就从前端开发最熟悉的代码和 Node.js 进程开始,只追一条链:一个 Node.js 服务,到底怎样在 Kubernetes 里跑起来?
先把 Kubernetes 拿掉:代码怎样变成正在运行的进程
假设我们有一个 Node.js API。它现在只是一组源码文件,不会自己变成对外提供服务的进程。
按传统部署方式,我们要先准备一台物理机或虚拟机,在上面安装正确版本的 Node.js,复制代码,执行 npm install,配置环境变量,最后用 node server.js 或类似命令启动进程。进程运行时,真正消耗的是这台机器的 CPU 和内存。
只部署一次时,这套做法没什么难理解的。但机器一多,环境差异就会出现:这台是 Node.js 20,那台还在用 Node.js 18;这台少了一个系统库,那台的配置又被人手动改过。
容器解决的,正是“每到一台机器都重新准备运行环境”的问题。
你可以先把 镜像(Image) 理解成一份可分发的运行模板。它不只包含业务代码,还会带上运行代码所需的 Node.js、系统库和安装好的依赖。这样,我们先构建一次镜像,再把同一份镜像发到不同机器上运行。
镜像本身不会执行代码。只有当 Docker 或其他容器工具用这份镜像启动进程时,才产生一个 容器(Container)。
所以,容器不是代码压缩包,也不是一台小型虚拟机。它首先是一个正在运行的进程,只是操作系统给它隔出了自己的文件系统、网络视图和资源边界。在常见的 Linux 容器中,它与同一台机器上的其他容器共享宿主机内核,并不会为每个容器再启动一套完整操作系统。
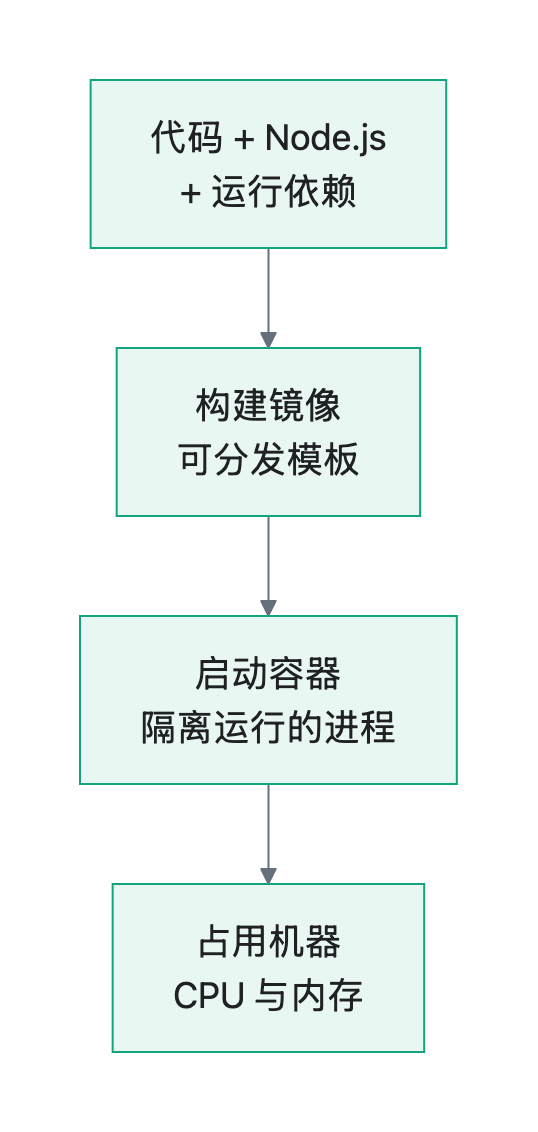
用一句话压缩就是:镜像是运行前的静态模板,容器是镜像启动后的隔离进程,机器则提供真正的 CPU 和内存。
到这里还没有 Kubernetes。你的 Node.js、Java 或 Go 服务,最后仍然是某台机器上的容器进程。
镜像不会自己变成进程。机器上必须有一个程序接收“用这份镜像启动容器”的请求,再负责停止容器、删除容器和查询运行状态。
这个程序就是 Container Runtime,容器运行时。初学时,可以先把它理解成“机器上真正管容器的程序”。在 Kubernetes 集群里,containerd 和 CRI-O 都是常见选择。
这里最好别再把 Docker 和 Container Runtime 当成同一个概念。Docker 是一整套容器工具与产品;Kubernetes 需要的,是一个能通过标准接口管理容器的运行时。
容器多起来以后,才轮到 Kubernetes 出场
如果只有一台机器、一个容器,手动执行一次 docker run 也能工作。真正的麻烦出现在规模变大以后:同一个 API 需要 3 个副本,公司有几十台机器,某个容器挂了要补上,发布新版本还不能一次全停。
这时需要的不是另一种容器,而是一个能在多台机器之间统一安排和管理容器的系统。Kubernetes 做的就是这件事。
不过,Kubernetes 不直接把一个裸 Container 当成最小管理单元。它安排和运行的最小计算单元是 Pod。
一个 Pod 可以包含一个或多个容器。大部分业务 Pod 只有一个主容器;只有当多个容器必须紧密协作时,才会把它们放进同一个 Pod。
同一 Pod 里的容器共享网络命名空间,使用同一个 Pod IP,可以通过 localhost 互相访问。它们也可以通过配置挂载同一个 Volume。所以 Pod 不是“容器文件夹”,而是一组需要共同运行的容器所在的边界。
无论 Pod 里有几个容器,它都必须落到某台真实机器上。Kubernetes 把加入集群、用来承载这些 Pod 的机器叫作 Node。一个 Node 上可以运行很多 Pod。
为了让 Pod 真正在 Node 上跑起来,每个 Node 上还有两个关键角色:
- Kubelet:运行在 Node 上的 Agent。它获取分配给这台 Node 的 PodSpec,并确保其中描述的容器正在运行且健康。
- Container Runtime:真正管理容器执行与生命周期的组件,例如 containerd。
两者通过 CRI(Container Runtime Interface,容器运行时接口) 通信。CRI 是一套 gRPC 接口规范,不是一个会自己启动容器的程序。
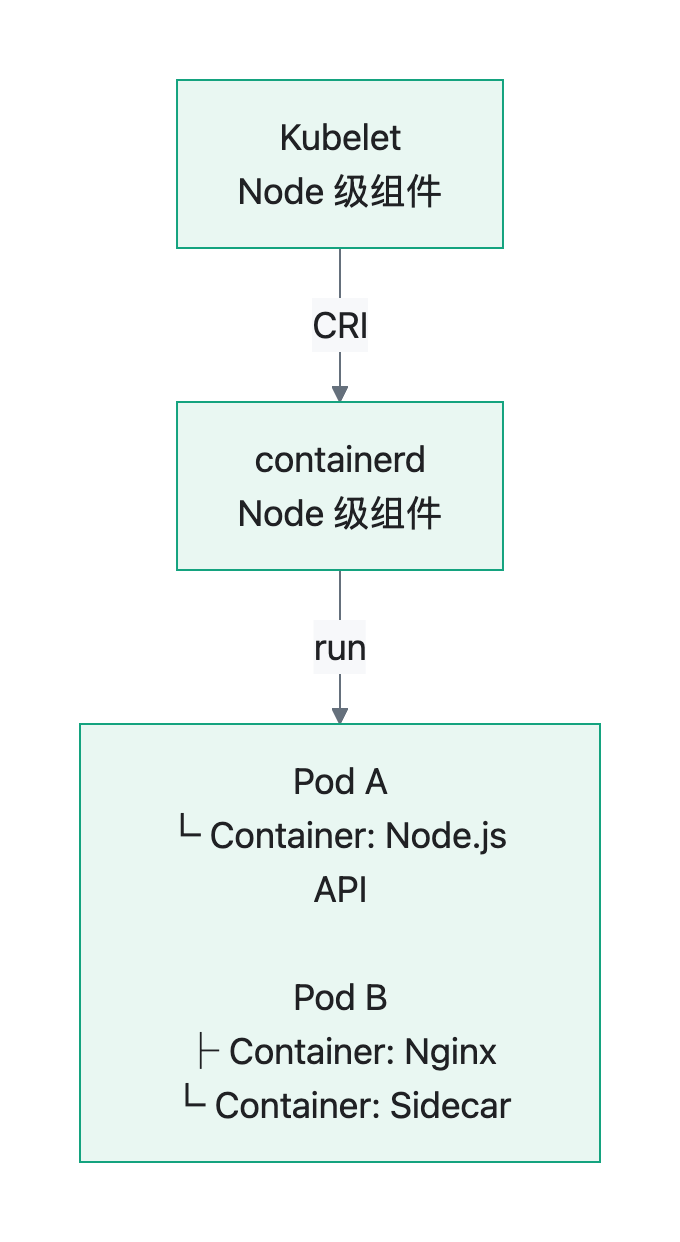
这张图里最容易看错的关系是:Kubelet 和 containerd 属于 Node,不在 Pod 里。
现在,一台 Node 已经具备了启动 Pod 的能力。但它还不知道应该启动几个 Pod,也不知道哪一个 Pod 应该由自己负责。要回答这两个问题,得回到我们平时写的 Deployment。
我们写的是 Deployment,真正被调度的是 Pod
假设 Node.js API 需要 3 个副本。你可以直接创建 3 个 Pod,但这样就得自己记住它们的数量,在 Pod 被删除后手动补上,发布新版本时再一个个替换。
因此,日常部署无状态服务时,我们通常不直接维护裸 Pod,而是创建 Deployment。Deployment 负责表达副本数和更新策略,它再通过 ReplicaSet 管理具体的 Pod。
- Deployment 管理声明式更新,包括滚动更新和回滚等能力。
- Deployment 通常创建并管理 ReplicaSet。
- ReplicaSet 通过 Pod 模板创建或删除 Pod,使运行中的副本数接近你声明的数量。
假设目标是 3 个 Pod,某个 Pod 被删除后,ReplicaSet Controller 会看到当前副本数只有 2,再创建一个新 Pod。它不是把原来那个 Pod “修活”,而是用新对象恢复期望数量。
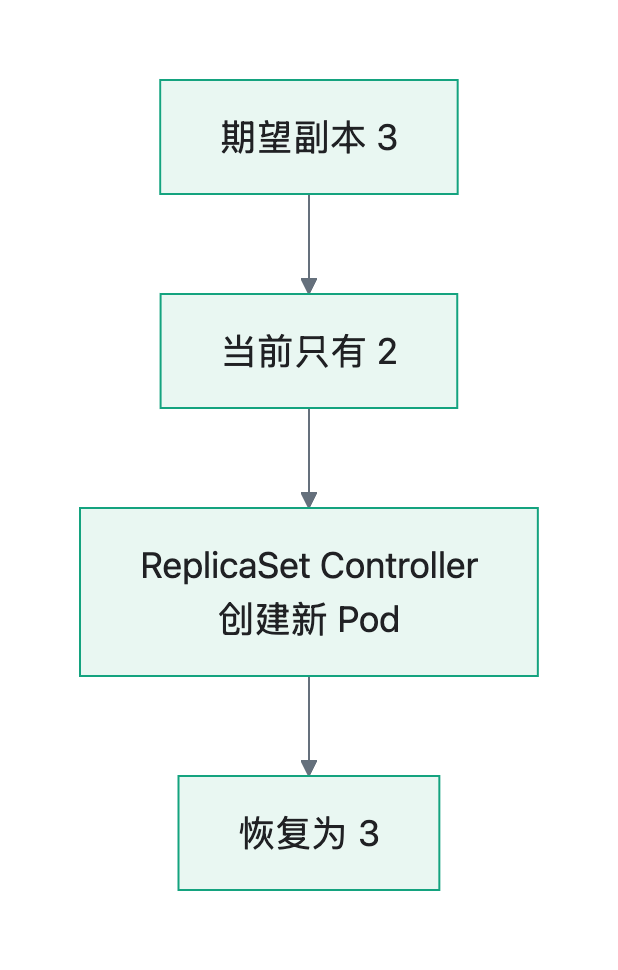
所以我们写 Deployment,日常排查却常常要落到 Pod 和 Container:Deployment 表达“我想要什么”,Pod 和 Container 则更接近“现在真的发生了什么”。
Pod 由谁创建,又会被放到哪台 Node
Deployment 已经声明了“我要 3 个 Pod”,Node 也已经具备启动 Pod 的能力。现在还差一个协调者:它要创建这些 Pod,再决定每个 Pod 去哪台 Node。
这个协调者就是 Control Plane,也就是集群的控制中枢。其中,API Server 接收 Kubernetes API 请求;一组 Controller 持续对比期望状态和当前状态;Scheduler 则为还没有分配 Node 的 Pod 选择合适机器。
现在再把 replicas: 3 的 Deployment 从头到尾走一遍:
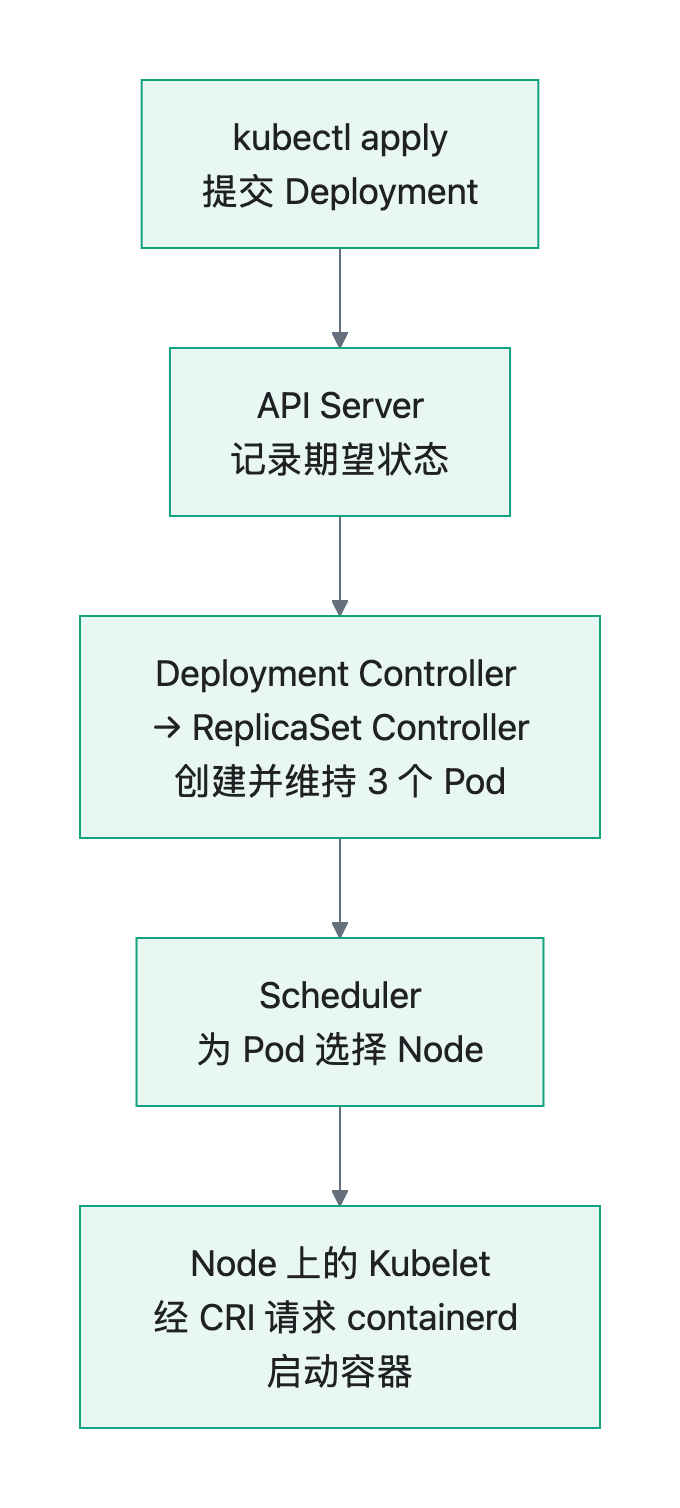
这条链里同时有两种关系。资源管理关系是:
Deployment → ReplicaSet → Pod → Container
真正把 Pod 落到机器并启动容器的执行链路是:
Control Plane 创建与调度 Pod → Kubelet 执行本机期望状态 → containerd 启动容器
Deployment 本身不会钻进 Node 启动进程,Scheduler 也不会创建容器。每个角色只处理自己那一段,才把一份声明逐步变成了正在运行的进程。
Service 不保住 Pod,它保住访问入口
到这一步,3 个 Pod 已经跑起来了。但是每个 Pod 都有自己的 IP,而且 Pod 是短暂的:它可能被删除、重建,新 Pod 的名字和 IP 也会变。调用方不应该去追踪每一个 Pod IP。
假设这 3 个 Pod 现在的 IP 分别是 10.0.1.11、10.0.1.12 和 10.0.1.13。如果调用方把这些地址写死,只要某个 Pod 重建,原来的地址就可能失效。
Service 就是放在这些 Pod 前面的固定入口。比如集群里的其他服务只需要访问 my-api,不用记住后面每个 Pod 的 IP。
那么,Service 怎么知道哪些 Pod 属于 my-api?Deployment 创建 Pod 时,会给它们加上 app: my-api 标签;Service 里的 Label Selector 也写着 app: my-api。两边匹配上之后,这些 Pod 就成了 Service 的后端。
Kubernetes 还会用 EndpointSlice 保存一份“当前可用 Pod 名单”,里面记录这些 Pod 现在的 IP。Pod 被替换后,这份名单也会跟着更新。
当请求到达 Service 时,kube-proxy 或集群使用的网络插件,会根据这份名单把请求转发给其中一个 Pod。
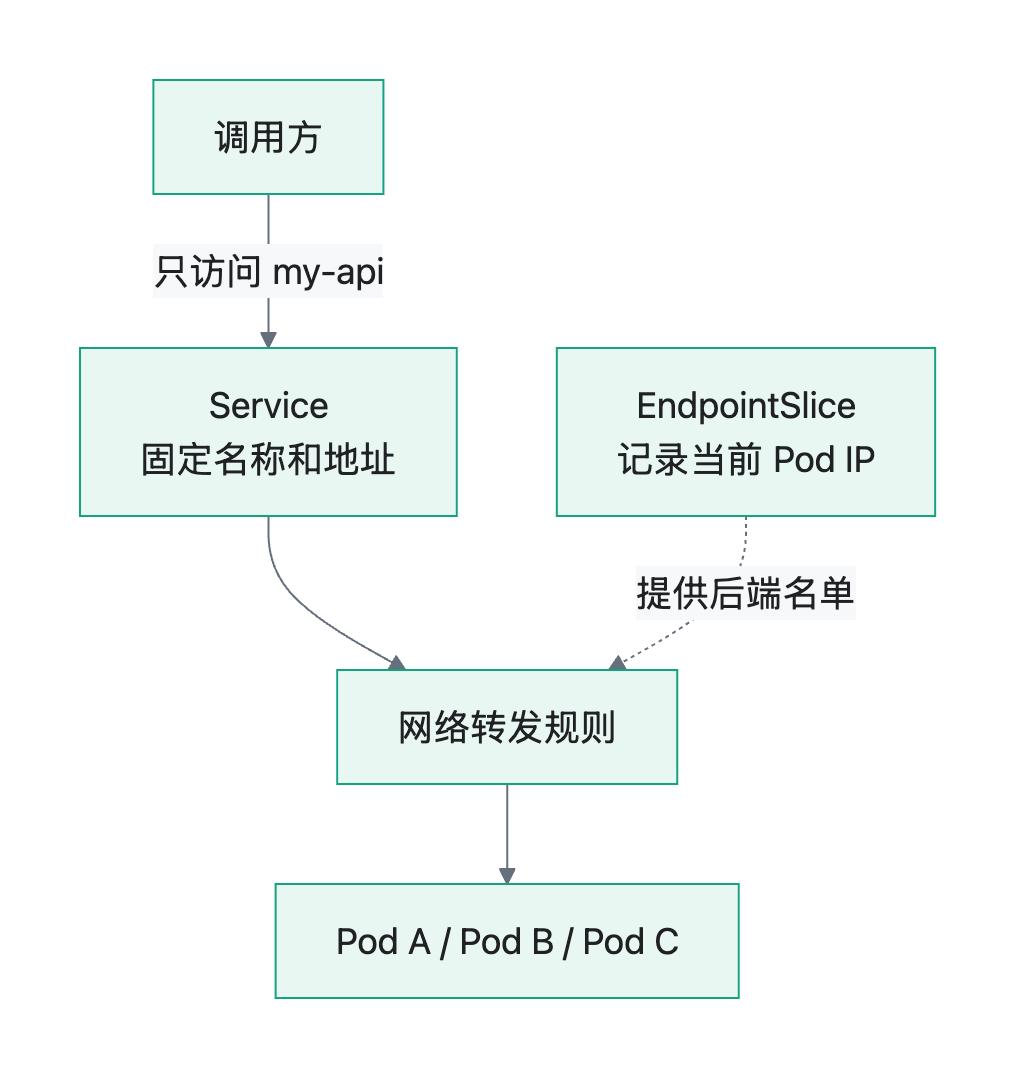
可以把这段压缩成一句话:Service 提供固定入口,EndpointSlice 记录入口后面现在有哪些 Pod,网络组件负责把请求真正送过去。
这和 ReplicaSet 解决的不是同一个问题:ReplicaSet 负责维持 Pod 副本数,Service 则让调用方不用关心后面的 Pod 怎样替换。
另外,Service 不等于公网入口。默认的 ClusterIP 只在集群内可达。要把 HTTP/HTTPS 服务暴露到集群外,通常还会使用 LoadBalancer 类型的 Service、Ingress 或 Gateway API,具体取决于集群环境。
回到 Deployment YAML,每个字段都有了落点
我们已经从代码一路追到了机器上的容器,也知道 Service 怎样找到会变化的 Pod。现在回头看最开始的 YAML,它声明的其实就是这些关系:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: my-api
spec:
  replicas: 3
  selector:
    matchLabels:
      app: my-api
  template:
    metadata:
      labels:
        app: my-api
    spec:
      containers:
        - name: api
          image: my-api:1.0
          ports:
            - containerPort: 3000
它表达的是:用 my-api:1.0 镜像运行容器;每个 Pod 按这份模板创建;让 3 个符合 app: my-api 标签的 Pod 持续存在。
如果还要让集群内的其他服务访问它,可以增加一份 Service:
apiVersion: v1
kind: Service
metadata:
  name: my-api
spec:
  selector:
    app: my-api
  ports:
    - port: 80
      targetPort: 3000
这里最关键的连接不是文件顺序,而是 Service.spec.selector 与 Pod 上的 app: my-api 标签相互匹配。port: 80 是调用方访问 Service 的端口,targetPort: 3000 是请求最终到达 Pod 容器的端口。
不要只相信 apply 成功,用这几步验证链路
kubectl apply 返回成功,只能说明 API Server 接受了这份声明,不能证明容器已经健康,也不能证明 Service 已经有可用后端。
先看 Deployment 是否达到期望副本数:
kubectl get deployment my-api
kubectl rollout status deployment/my-api
再沿着管理关系往下看 ReplicaSet 和 Pod:
kubectl get rs
kubectl get pods -l app=my-api -o wide
如果 Pod 一直 Pending,先看事件,确认调度为什么没有完成:
kubectl describe pod <pod-name>
如果 Pod 已经被调度,但容器不断重启,再看容器日志与上一次退出信息:
kubectl logs <pod-name> -c api
kubectl logs <pod-name> -c api --previous
如果 Pod 正常,Service 却访问不通,先确认 Selector 是否真的选中了后端:
kubectl get service my-api
kubectl get endpointslice -l kubernetes.io/service-name=my-api
这组命令对应的并不是一份万能排障清单,而是前面的心智模型:先看期望状态,再看 Pod 被放到了哪里、容器有没有跑起来,最后看稳定入口是否指向了正确后端。
最后把整条链合起来
如果前面的名词有点多,可以分三层记。
第一层是程序怎样跑起来:
代码 + 运行时 + 依赖 → 镜像 → 容器进程 → 机器的 CPU 和内存
第二层是 Kubernetes 的资源管理关系:
Deployment → ReplicaSet → Pod → Container
第三层是真正把 Pod 变成容器进程的执行链路:
Control Plane → 为 Pod 选择 Node → Kubelet → CRI → Container Runtime → Container
Service 则站在另一侧,为会变化的 Pod 提供稳定的网络入口。
这套模型有意省略了 etcd、CNI、CSI、DNS、探针、资源限制和安全策略等细节,也没有覆盖有状态工作负载。它不是完整的 Kubernetes 架构图,但足以帮前端开发回答一个最常见的问题:一份 Deployment YAML 提交以后,究竟是谁创建了 Pod,谁选择了机器,谁启动了容器,流量又怎样找到它。
下一次 AI 再生成一份 YAML 时,不妨别急着直接 apply。先顺着这三层问一遍:镜像启动后会运行什么进程?Deployment 声明了什么期望状态?Pod 会怎样被创建和调度?Service 的 Selector 又会选中谁?能回答这些问题,才算真的开始会用 Kubernetes。
参考资料
-
Kubernetes Documentation, Cluster Architecture
https://kubernetes.io/docs/concepts/architecture/ -
Kubernetes Documentation, Container Runtime Interface (CRI)
https://kubernetes.io/docs/concepts/containers/cri/ -
Kubernetes Documentation, Workloads
https://kubernetes.io/docs/concepts/workloads/ -
Kubernetes Documentation, Pods
https://kubernetes.io/docs/concepts/workloads/pods/ -
Kubernetes Documentation, Deployments
https://kubernetes.io/docs/concepts/workloads/controllers/deployment/ -
Kubernetes Documentation, ReplicaSet
https://kubernetes.io/docs/concepts/workloads/controllers/replicaset/ -
Kubernetes Documentation, Service
https://kubernetes.io/docs/concepts/services-networking/service/ -
Kubernetes Documentation, Services, Load Balancing, and Networking
https://kubernetes.io/docs/concepts/services-networking/