一文带你了解 data agent
结合 Data Agent 实践,讨论数据分析需求、数据准备与同步、指标定义、查询效率,以及产品落地时最难解决的问题。
文章目录
如果用一句话来描述agent,我喜欢这样说:llm models + tools + resource。
换成 data agent,则是:llm models + tools + data ,即把 resource 换成 data 。
我近一年的工作跟 data agent 有一些关系,作为沉淀,我准备用这篇文章来给大家讲解讲解,以下是我准备展开的模块:
- 为什么会有 data agent ?
- data agent 需要什么 ?
- 如何让 data agent 找对数据 ?
- data agent 的执行效率如何保证 ?
- data agent 最难的点是什么 ?
- data agent 还有机会吗 ?
为什么会有 data agent
data agent 是解决问题的工具,它的出现对应着实际的业务痛点。
以跨境电商为例,卖家日常有很多工作要做:
- 捞数据并整理
- 指标计算
- 报表输出
- 经营情况分析
- 竞品分析
- 增长潜力
- 广告分析
- 。。。
这些工作日常普遍,且比较繁琐,如果结合 AI 来完成,一个比较好的实现形式就是 data agent ———— 围绕 “跨境电商” 的各种平台数据封装 tools 给 llm models 调用。
data agent 需要什么
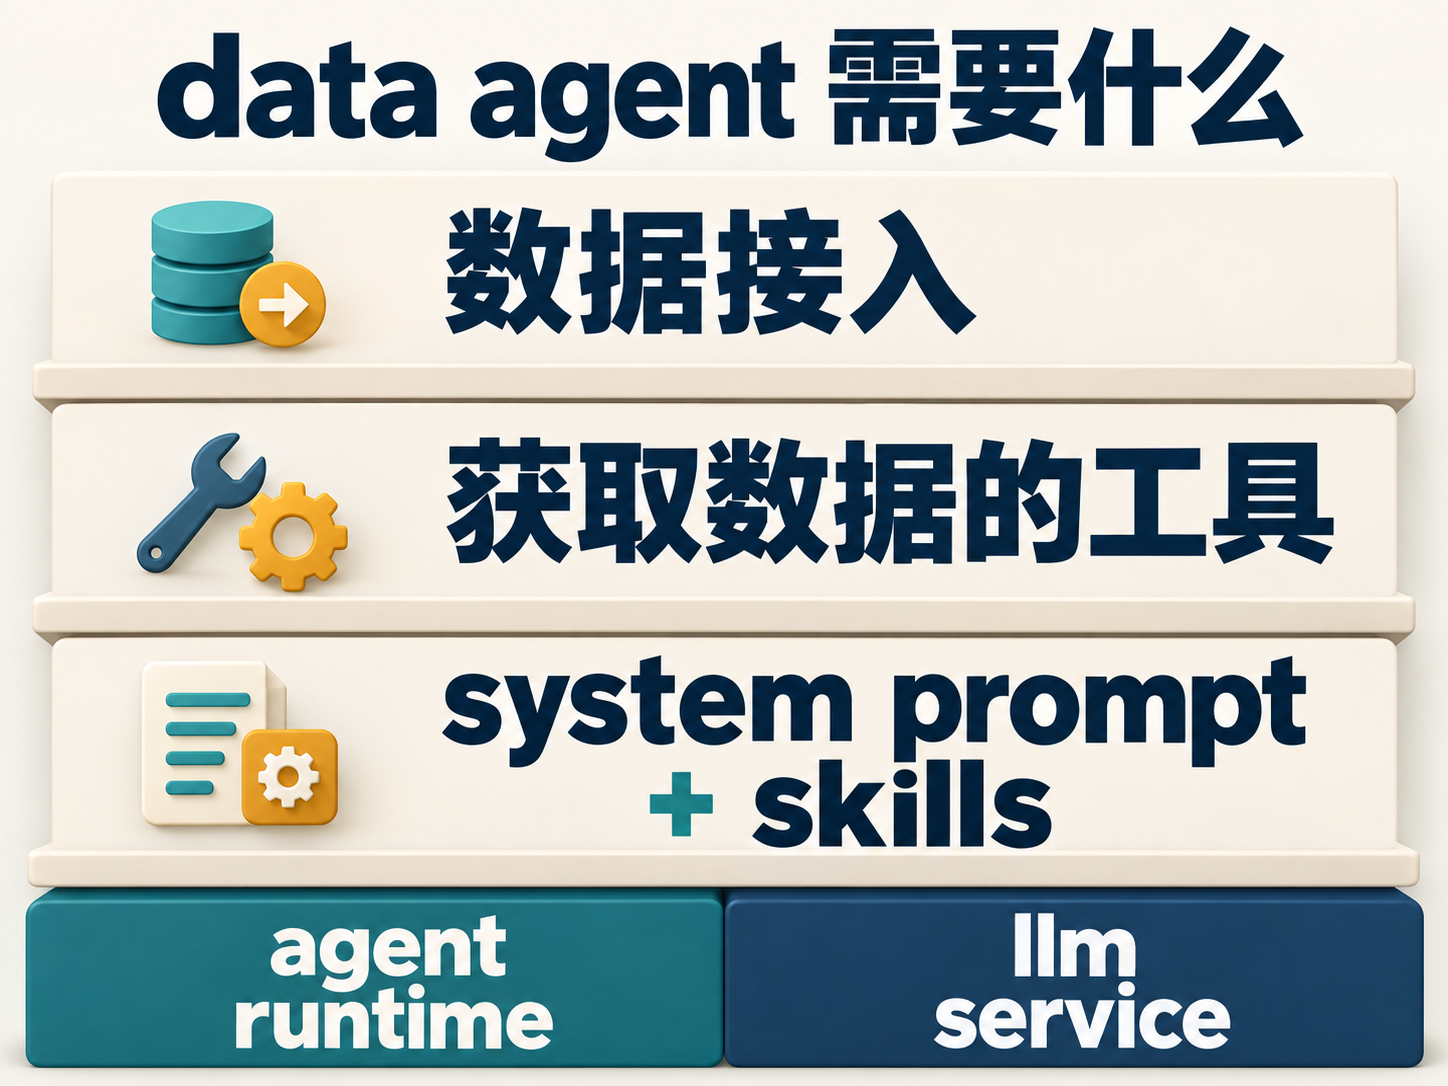
既然围绕数据,那就需要:
- 一套数据接入流程,比如平台数据授权流程。
- 一套获取数据的工具
- 一些前置的 system prompt、skills
其次就是必备的 agent runtime、llm service
如何让 data agent 找对数据
各大平台都有暴露的 api ,agent 可以通过调用这些api来获取各种数据并进行分析,但默认情况下 agent 不太清楚api返回的到底是什么数据,虽然可以通过文档来查看,但文档真的准确吗?文档全吗?存在没有文档的情况吗?
每个平台对待文档的态度参差不齐,有些完备,有些缺损,有些没有。在这种情况下,agent很难精准提取数据并给出正确结果。
为此,字典映射自然而然出现了。它需要我们维护一套数据字段映射,基于这份映射,agent能知道要去找哪个字段。
也就是说我们需要维护多个平台的多套api字段映射,api稍微一迭代,就会产生字典维护成本,进而影响agent提取数据。
有什么方法可以规避呢?可以提高可维护性呢?
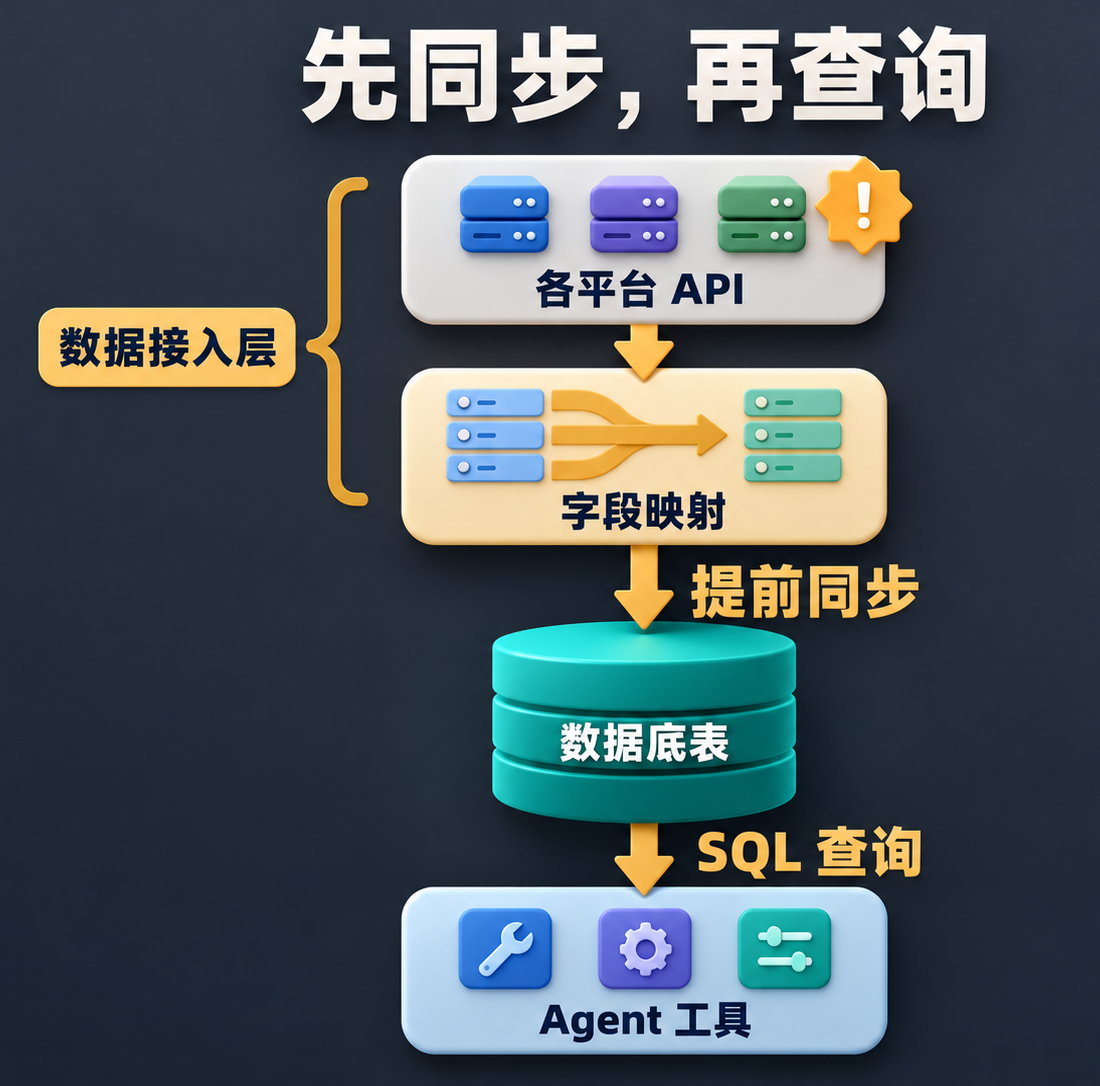
有的,我们可以参考 fivetran 这个产品的设计,把各平台的数据导入到一层底表中,再基于这层更加稳定的底表设计数据字典,供 agent 使用。后续即使 API 有所变更,也可以优先调整 API 字段到基础表字段的映射,尽量保持上层数据字典和工具稳定。
这并没有消除映射维护,而是把 API 变化的影响集中在数据接入层,减少上层跟着修改的工作量。
因为也涉及到agent任务执行效率,所以我重点会挪到下一个模块来讲解。
data agent 的执行效率如何保证
在说执行效率之前,我们要拆分出执行效率的瓶颈点:
- API带来的耗时:有些数据涉及到分页查询,也有些涉及到报表下载,这部分场景的api调用耗时非常高。
- Tool带来的耗时:工具描述、参数描述不清时,agent容易调用出错,导致反复调用试错,浪费很多时间。
数据底表管理
数据底表不仅能减少数据字典的维护工作,也能减少任务执行时等待 API 返回数据的时间。把数据提前同步到底表后,agent 就可以直接通过 SQL 查询,避免每次执行任务都重新分页取数或下载报表。
提前给一个效果感知:纯API下,agent任务的耗时可能长达10-30分钟,甚至更长,而一次sql调用,可能只要一两秒,甚至更少,任务耗时可以压缩到5分钟以内。
具体怎么做呢?这里给一个大致的逻辑链路串联:
- 基于API结果拆分底表结构
- 基于底表结构设计数据字典
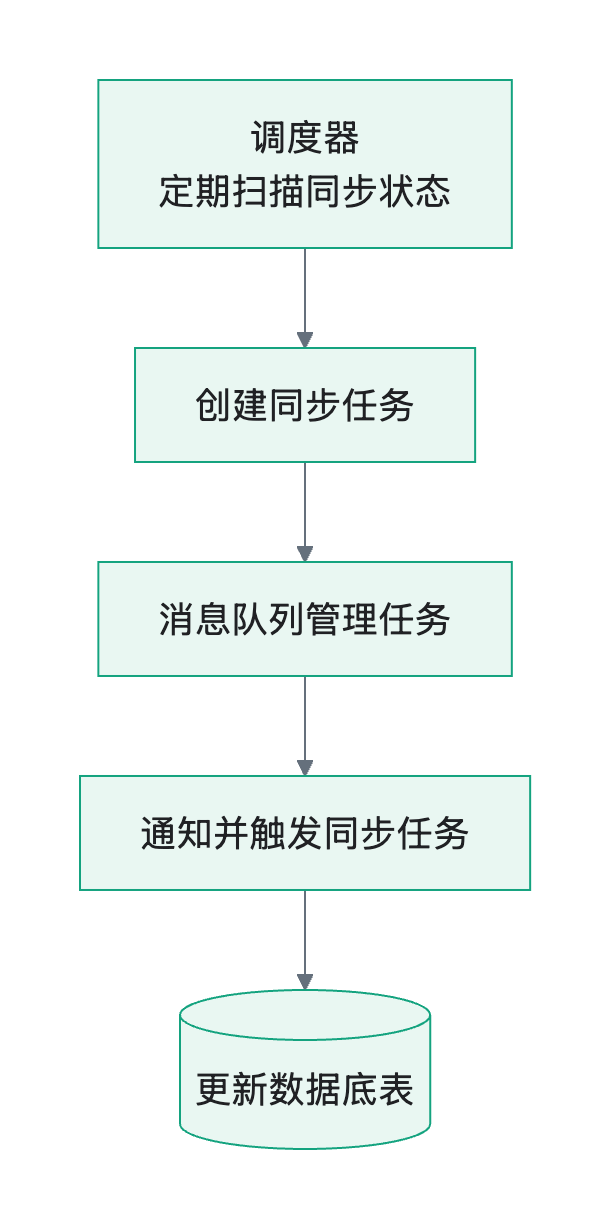
- 通过一个调度器来定期扫描数据同步状态,并创建同步任务
- 同步任务由一个消息队列来管理
- 通过消息队列来通知并触发同步任务
- 不同平台、不同账号授权后,要维护不同的数据库schema
- 重新封装基于数据底表的工具
- 有哪些平台
- 平台下有哪些可同步账号
- 对应平台有哪些表
- table对应的数据字典有哪些
- 已有的数据同步状态(已更新了哪些数据)
Tool 信息优化
针对前面说的tool调错,导致反复试错调用,浪费较多时间。相对工程量少一些,大致的优化动作分为三块:
- tool描述、参数校准
- tool错误给到agent友好的描述
- 前置某些 tool 为核心 tool ,以减少agent对tool的探索
其他
不同的 agent harness 都会涉及到记忆,记忆分为短期记忆、长期记忆,记忆召回准确,也能让agent少走很多弯路。
以及一些skill的沉淀,比如hermes主打的就是自进化,能够在合适的时机尝试去沉淀skill,通过这些skill,agent的执行效率、准确率都能得到提高。
data agent 最难的点是什么
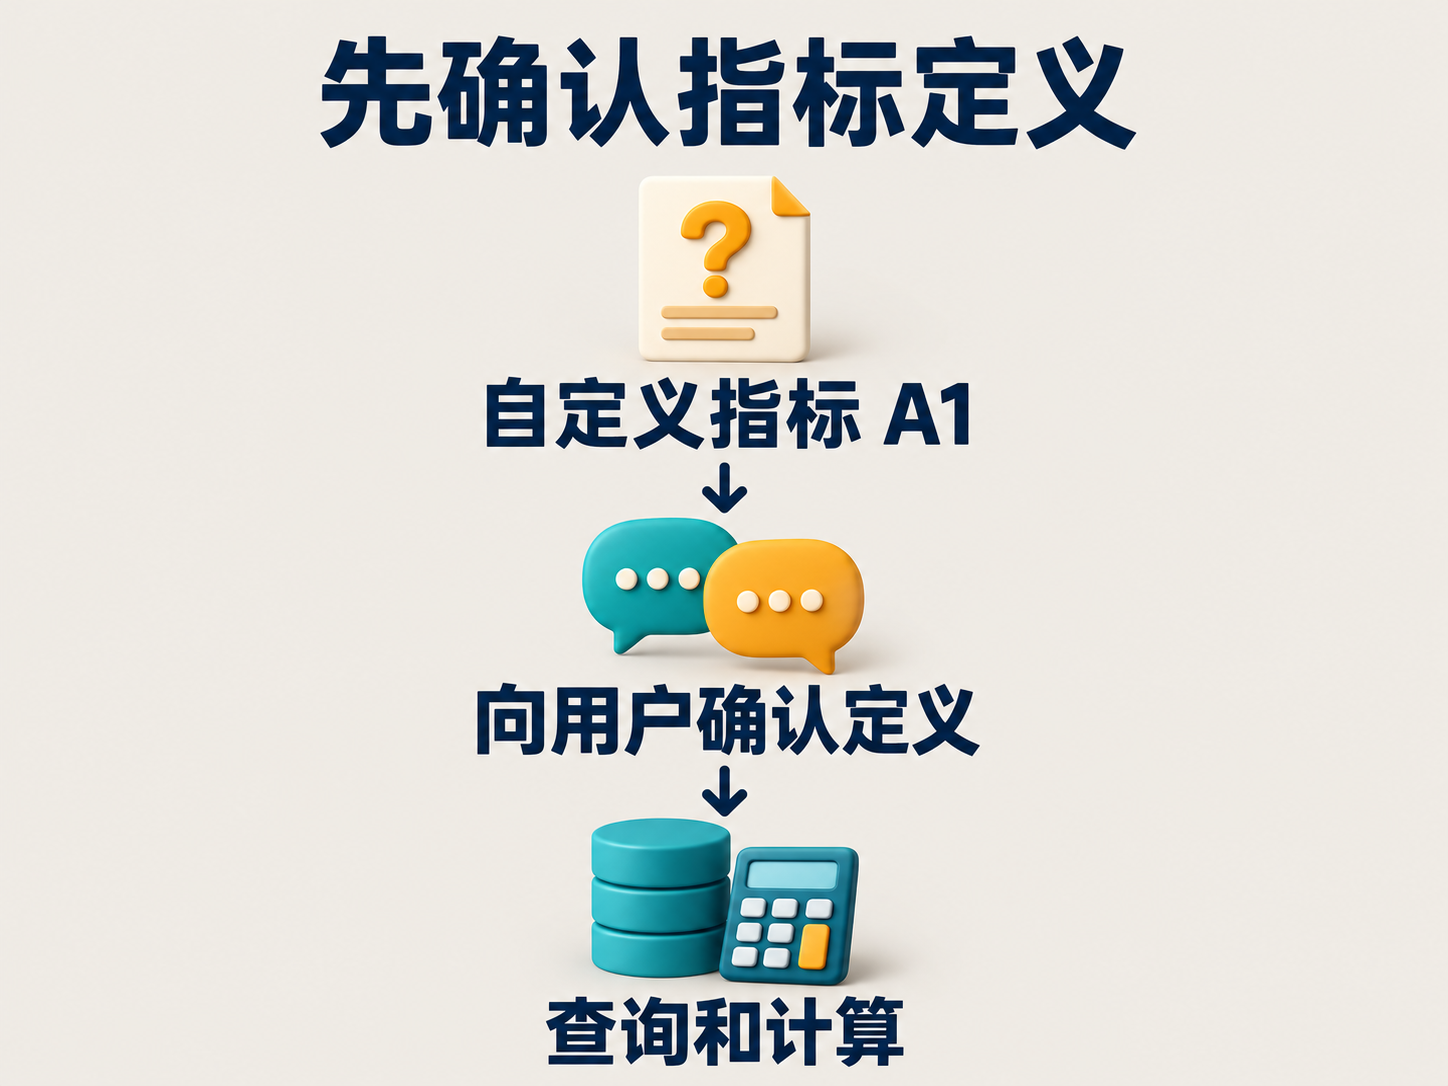
我觉得是未知。不同场景,不同的人,他们可能有自己独有的工作方式。简单举一个例子:用户 A 有一个自定义指标 A1,agent 默认不知道它的定义,所以不清楚该查哪些数据、怎样计算。agent 可能会向用户确认,也可能自主推断,但推断存在出错的风险。对于这类自定义指标,更稳妥的做法是先向用户确认定义,再查询和计算。
我们永远不知道用户会问什么问题,也不知道agent会怎么反应。我们只能尝试去信任agent,尝试教育用户自主教导agent如何理解。
data agent 还有机会吗
说实话,我不太清楚。假如我把上面这层【底表、数据字典、同步机制、工具封装】剥离开来,提供给各种agent,是否也能解决问题呢?
data agent如果要有优势,就是做到极致的垂类,提炼大部分用户的知识,能够基于与用户的对话,识别并沉淀合适的知识。
最终还是要对比效果,效果相差不大,其实也没有做的必要了。
最后
其他类型的agent其实也是类似,要思考做垂类是否能拉开较大差距。
最后,我还想补充几点:
- 能固化的动作尽量固化
- 不轻易让 agent 执行商品上下架等业务操作,除非执行流程非常固定,且有明确的操作范围