Dembrandt 解读:AI 写前端,缺的不是 Prompt,而是一份可执行的设计约束
Dembrandt 能把网页中散落的颜色、字号、间距和交互状态提取成 Design Tokens,再交给 AI 编码工具和 CI 使用。但它生成的是可检查草稿,不是自动正确的设计系统。
文章目录
导语
如果你用过 Cursor、Claude Code 或其他 AI 编码工具写前端,可能见过一种很典型的结果:
页面能跑,按钮能点,布局也没有明显错误,但一看就不像你的产品。
主色差了一点,标题大了一点,卡片圆角又是另一套,间距看似整齐,放回旧页面里却格格不入。
我们往往会继续修 Prompt:
更高级一点。
更像我们现在的官网。
保持品牌风格。
问题是,“品牌风格”对模型来说并不是一份可执行的输入。它需要更具体的东西:主色到底是什么,标题有哪些字号,页面遵循怎样的间距节奏,按钮在默认、悬停、聚焦和禁用时分别是什么状态。
Dembrandt 做的,就是尝试把这些散落在真实网页中的视觉事实,整理成人和 Agent 都能读取的结构化约束。
先给结论:
Dembrandt 最有价值的地方,不是帮 AI “抄一个网站”,而是给 AI 前端工作流补上一层可观察、可传递、可比较的设计上下文。但它能观察到什么,不等于什么就应该成为你的设计系统。
一、先弄懂 Design Token:它不是一张颜色表
Dembrandt 的核心对象是 Design Token(设计令牌)。
你可以先把它理解成:用有意义的名字,保存一个可复用的设计决定。
例如,下面两行都能表示同一种颜色:
color: #2563eb;
color: var(--color-action-primary);
第一行只告诉你“这里是蓝色”。
第二行还表达了用途:这是主要操作的颜色。当品牌色调整时,与这个设计决定有关的按钮、链接和焦点状态就可以共同变化。
除了颜色,Token 还可以表示:
- 字体、字号、字重和行高;
- 页面的间距刻度;
- 边框、圆角和阴影;
- 动画时长和缓动曲线;
- 按钮、输入框等组件的不同状态。
它的价值不在于“把 CSS 换个地方存”,而在于让设计工具、代码库、文档和 Agent 有机会使用同一套可交换语言。
Design Tokens Community Group 在 2025 年发布了第一个稳定格式版本 2025.10。这份规范的目标是定义 Token 在工具之间交换时的文件格式。需要注意,它由 W3C 社区组维护,但官方明确说明:它并不是 W3C Standard,也不在 W3C Standards Track 上。
这个区分很重要。Dembrandt 官网中的“W3C DTCG tokens”,更准确的意思是“支持 DTCG 维护的标准化格式”,不应被误解为已经通过 W3C 正式推荐。
二、Dembrandt 实际做了什么
官网给出的入口很简单:
npm i -g dembrandt
dembrandt example.com
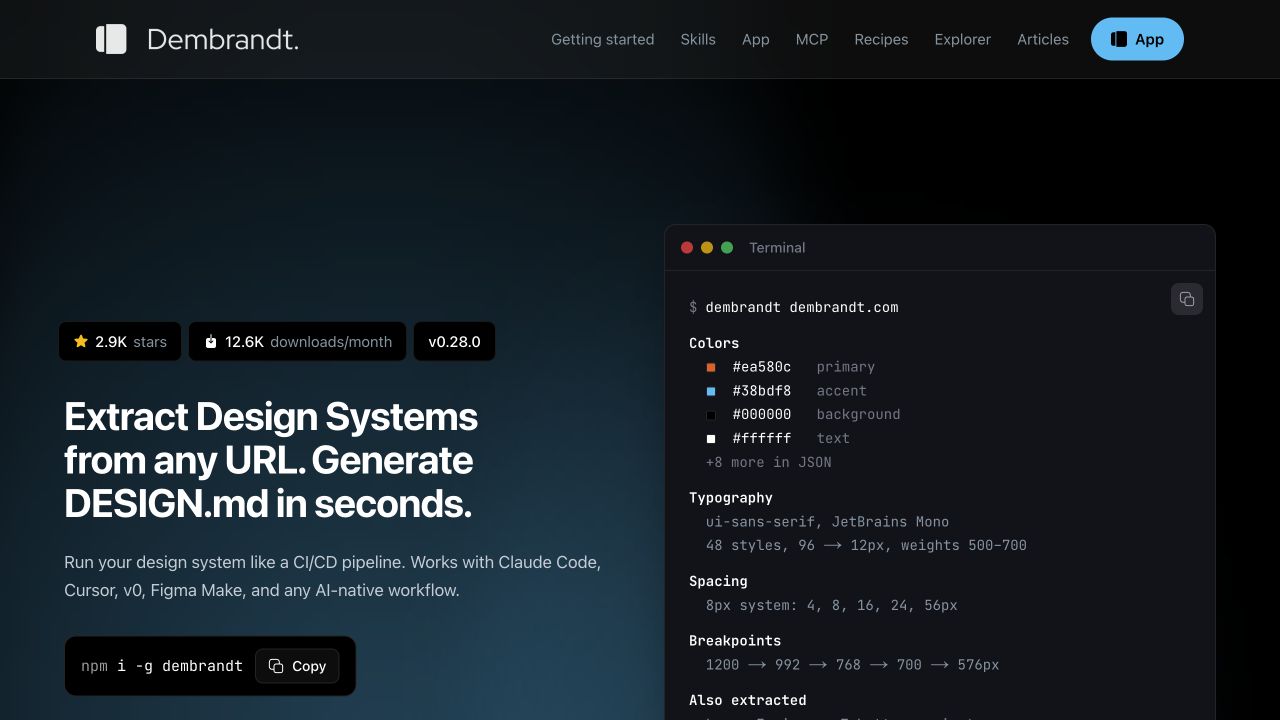
从官网、README 和发布记录能够确认,它不是直接下载一份 CSS 文件后做正则匹配。它会用 Playwright 启动真实浏览器,等待页面渲染,读取 DOM 中实际生效的计算样式与 CSS 变量,再对颜色、排版、间距、阴影、组件和动效等结果进行归纳。
这里有一个很实际的优势。
如果一个网站使用了 React、CSS-in-JS、Tailwind 或多层样式覆盖,只看源文件未必能知道用户最后看到什么。计算样式回答的是:浏览器现在真正画出了什么。
提取完成后,这些结果可以进入几种不同的交付物:
| 输出 | 主要读者 | 适合做什么 |
|---|---|---|
DESIGN.md |
人和 AI 编码 Agent | 让工具快速理解视觉约束与使用语境 |
| DTCG JSON | 设计系统工具与脚本 | 校验、转换和跨工具传递 Token |
| Raw JSON | 自定义程序 | 做差异比较、自动化分析与存档 |
Tailwind v4 @theme |
前端开发者 | 把观察到的值快速带入样式工流 |
| Brand Guide PDF | 客户和项目相关人 | 生成一份可共享的品牌参考文档 |
它还提供了 MCP 服务和一组 Agent Skills。这让工作流不必停在“人运行命令,再把结果复制给 AI”,Agent 可以在需要时主动发起提取,再读取返回的 Token。
不过,“能读到规则”和“能做出好设计”仍然是两件事。Dembrandt 自己也把提取工具与 UX Skills 分开:前者提供实际数据,后者提供信息架构、层级、可访问性和组件状态等判断方法。
三、它为什么适合放进 AI 前端工作流
假设你接手了一个已经上线多年的 SaaS 产品,现在要让编码 Agent 新增一个“账单设置”页面。
团队没有完整的 Figma 组件库,旧文档也已经过期,但线上产品中已经有成熟的列表、表单和按钮。
没有结构化约束时,Agent 大概只能靠三种输入:
- 你用自然语言描述“尽量和旧页面一致”;
- 给它几张截图;
- 让它自己在代码库里搜索可能相关的 CSS。
这三种方法都能帮上忙,但它们给出的是片段。
Dembrandt 提供的是第四种输入:先从一个或多个真实页面提取观察结果,得到 DESIGN.md 和 Token 文件,再让 Agent 把它们与现有组件代码一起使用。
一条更完整的链路可以是:
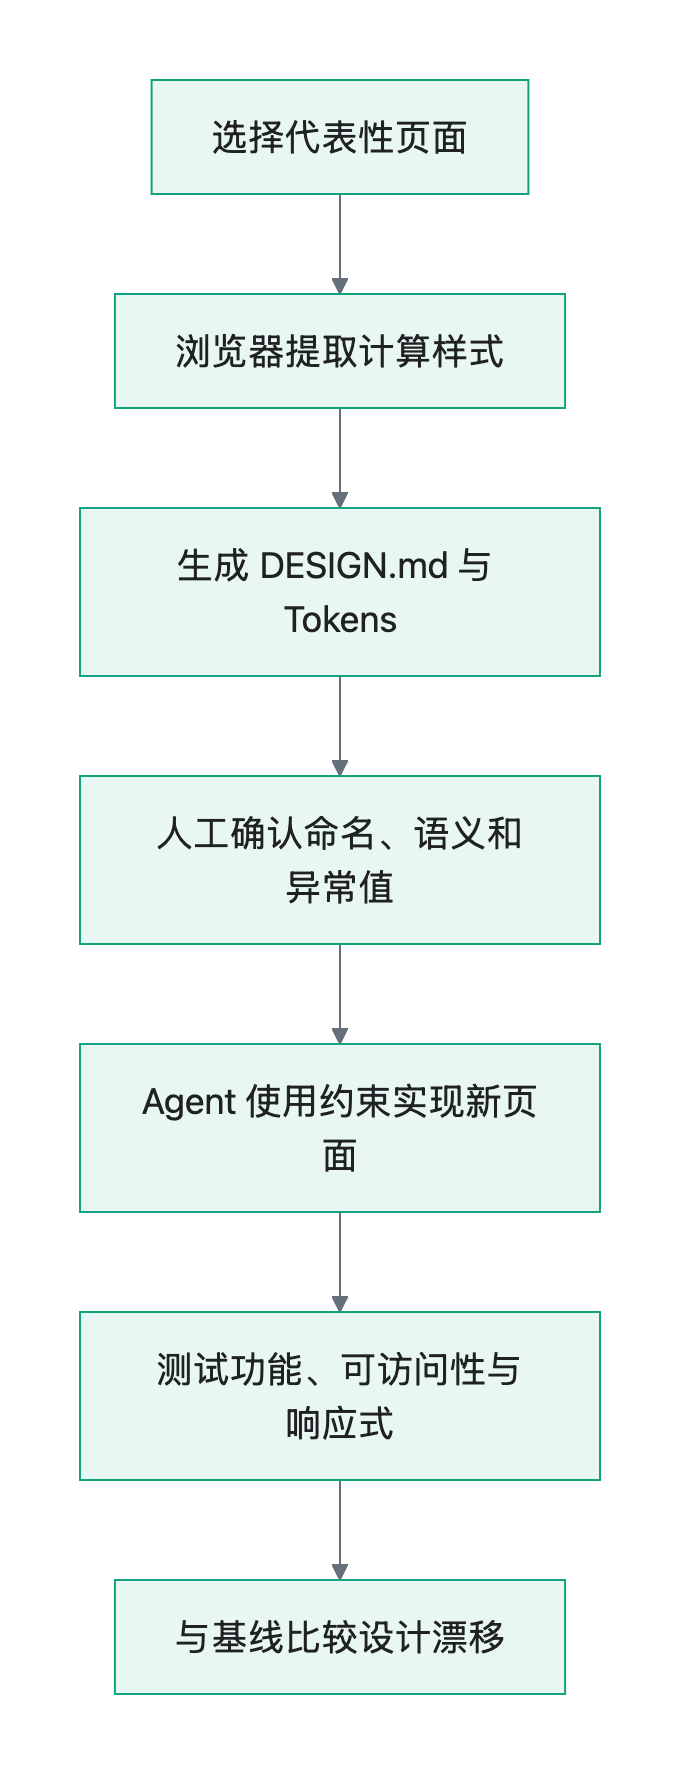
这条链路的价值在于,设计上下文不再是一段用完就丢的 Prompt。
它可以成为代码库中的文件,可以被审阅,可以跟着版本变化,也可以在发布后重新提取并比较。
四、真正有意思的不是“提取”,而是“反复比较”
只运行一次提取,Dembrandt 更像一个高级版网页检查器。
当它进入发布流程后,价值才开始放大。
官方提供了 --compare 能力:保存一次提取作为基线,之后每次发布重新提取,比较颜色、排版、间距、圆角和阴影等变化。差异超过阈值时,CLI 可以用非零状态码让 CI 失败。
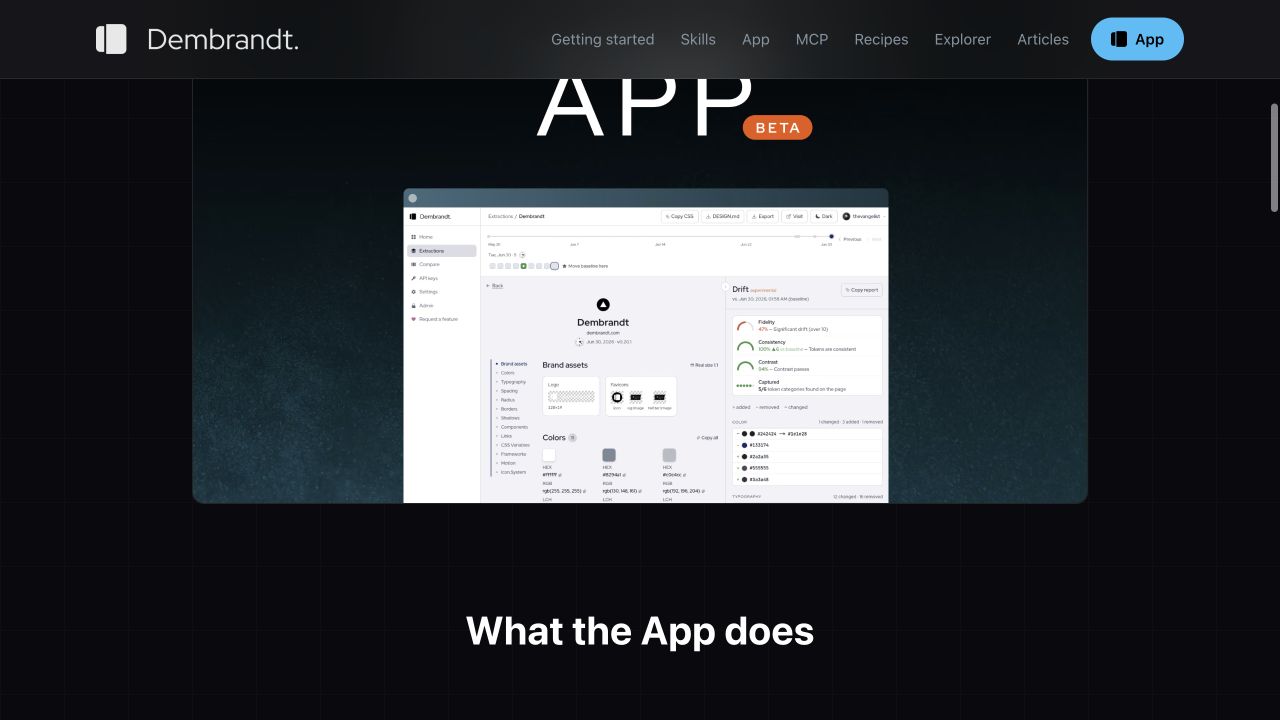
这会把一个原本很主观的问题:
这次改动看起来好像有点不对。
转成一个更可检查的问题:
这次发布新增了两个颜色,
删除了一个间距值,
并让按钮圆角偏离了已确认的基线。
这是故意修改,还是意外回归?
我认为这才是 Dembrandt 对 Agent Development 最有启发的地方。
Agent 生成界面时,我们容易把“已经给了它一份设计文档”当作任务终点。但真正稳定的系统还需要另一半:执行以后,检查结果是否仍在允许边界内。
从这个角度看,Dembrandt 把设计系统从“给人看的静态参考”,变成了更像 lint 规则和回归测试的东西。
五、它不是自动生成设计系统的魔法
如果只看“从任意 URL 提取设计系统”这句话,很容易高估它。
1. 观察到的值,不等于正确的设计决定
一个旧网站里可能同时存在三种几乎一样的蓝色、两套间距规则和几个历史遗留组件。
Dembrandt 可以告诉你它们存在,并尝试判断哪些更像主要值。但它不知道哪个是团队准备删除的旧值,也不知道某个破格样式是品牌表达还是实现错误。
所以自动提取的后一步,必须是人工确认:哪些值要保留,它们应该叫什么,以后允许怎样变化。
2. 它看不到的页面状态,就无法凭空提取
官方 README 列出了明确限制:Canvas 和 WebGL 中的内容没有普通 DOM 可供读取;JavaScript 很重的页面可能需要更长渲染时间;动态加载内容可能被遗漏;暗色模式和移动端需要单独指定。
一次桌面端首页提取,不能代表整个产品。
需要登录、通过特定操作才出现的状态,以及网站未展示的错误和空状态,都需要另外解决。
3. 数值一致,不等于体验一致
即使颜色、字号和圆角都用对了,页面仍然可能很难用。
信息优先级、任务流程、字段命名、错误恢复、键盘操作和移动端布局,都不能靠复制 Token 自动得到正确答案。
这也是为什么“提取”与“设计”要分开。前者尽量回答页面中已经有什么,后者还需要判断用户要完成什么、哪些信息更重要、什么状态必须被覆盖。
4. 输出必须被当成草稿,而不是真理
Dembrandt v0.28.0 新增了导出 Tailwind v4 @theme 文件的能力。官方在发布说明里特意强调,它只写入观察到的值,不自动补全色阶和派生状态,输出是“需要检查的草稿,不是真相源”。
这句话其实应该扩展到所有自动提取结果。
六、哪些人值得用,哪些人可以先不用
Dembrandt 最适合的,不是“想让 AI 帮我抄一个好看网站”的场景,而是下面这些任务:
- 团队有已上线产品,但设计文档不全或明显滞后;
- 需要让 AI 编码工具新增页面,同时尽量贴合现有视觉语言;
- 需要对多个历史页面做设计清点,先看清重复值和漂移情况;
- 已经有一套设计基线,想把视觉回归检查接入 CI;
- 需要在品牌审计或设计研究中,快速获得一份可追溯的初步资料。
反过来,如果你的产品刚开始,还没有形成值得保留的视觉语言,那么先做好用户任务、信息架构和核心组件,往往比提取 Token 更重要。
如果团队本来就有完整的设计系统仓库、正在维护的 Token 文件和成熟组件库,那么源仓库仍然应该是主要事实源。Dembrandt 更适合用来检查“代码最后渲染出来的结果”是否偏离,而不是反过来覆盖正式规范。
另外,提取第三方网站的公开样式,不等于获得了复制对方品牌、Logo 和界面的授权。官方 README 也要求用户遵守 robots.txt、网站条款与版权限制,优先对自有站点或已获授权的页面使用。
结语:把“像我们”变成可检查的输入
AI 编码工具越来越善于快速写出一个能跑的界面。
但“能跑”与“属于这个产品”之间,还差着一层约束:颜色、排版、间距、组件状态、响应式规则和无障碍要求。
Dembrandt 没有替我们完成设计。
它更像是做了一件很朴素、但越来越重要的事:先用浏览器把已经存在的视觉事实测量出来,再把它们交给 Agent、脚本和 CI 继续使用。
对 AI 前端工作流来说,这比反复对模型说“更像我们的风格”可靠得多。
如果你准备在自己的项目中尝试,我建议从最小范围开始:
- 只选一个你拥有或有权分析的代表性页面;
- 提取后人工确认主色、排版和间距刻度;
- 让 Agent 只实现一个小功能页;
- 用桌面端、移动端和键盘操作检查结果;
- 保存基线,再看下一次发布能不能稳定复用。
能从一次成功走到可重复、可检查,才是这个工具真正值得放进工程流程的理由。
参考资料
- Dembrandt 官网:https://www.dembrandt.com/
- Dembrandt Getting Started:https://www.dembrandt.com/getting-started
- Dembrandt Skills:https://www.dembrandt.com/skills
- Dembrandt 开源仓库与 README:https://github.com/dembrandt/dembrandt
- Dembrandt Releases:https://github.com/dembrandt/dembrandt/releases
- Design Tokens Format Module 2025.10:https://www.designtokens.org/TR/2025.10/format/
- Design Tokens Community Group FAQ:https://www.designtokens.org/faq/