DeepSeek Harness 架构拆解:为什么它要把一切做成插件
DeepSeek Harness 不只是一个 AI 编程助手。它把模型适配、工具、会话日志、Agent Loop、沙箱和子 Agent 都做成插件。本文拆解这些能力怎样组合成一个可运行、可替换的 Agent。
文章目录
- 导语
- 一、Harness 到底是什么:不是模型外面套一层 Prompt
- 二、“一切皆插件”解决的不是扩展数量,而是替换成本
- 三、Host 与 Agent Preset:共享底座和单次会话不能混在一起
- Host 平面:负责所有会话共享的基础设施
- Agent Preset 平面:决定这次会话“是什么 Agent”
- 四、一次执行为什么要写成事件日志
- 五、Agent Loop 很薄,能力从 seam 接进来
- 六、四种 Preset,其实是四个 Harness 实验
- 1. 标准模式:完整的编码 Agent
- 2. PTC 模式:把多次工具调用编译成一段程序
- 3. 极简模式:只留下持久 Bash 和编辑器
- 4. 创造模式:让 Agent 修改自己运行的 Harness
- 七、权限不是一句“请小心”,而是两个独立旋钮
- 八、它最值得 Agent 开发者学习的三个判断
- 判断一:同一个模型,应该允许拥有不同的 Harness
- 判断二:可观测性要从事实日志开始
- 判断三:插件化的最终目标是可替换,而不是可安装
- 九、现在不该被忽略的限制
- 结语
- 参考资料
导语
DeepSeek 刚刚开源了一个新项目:DeepSeek Harness,命令行名称是 dsh。
如果只看界面和使用方式,它很像又一个 AI 编程助手:选一个代码目录,配置模型,然后让 Agent 读文件、改代码、运行命令、搜索网页、拆分任务。
但这个项目真正有意思的地方,不在于它又提供了多少工具,而在于它试图回答一个更底层的问题:
当 Agent 的模型、工具、记忆、沙箱、审批、子 Agent 和交互界面越来越多时,怎样让这些能力可以独立替换、重新组合,并且在运行时安全地装上和卸下?
DeepSeek Harness 给出的答案是:一切皆插件。
模型适配器是插件,工具注册表是插件,会话日志是插件,Agent Loop 是插件,连 Web UI、权限策略和上下文压缩也由插件组成。系统没有一个必须不断打补丁的“神圣核心”,新的行为应该挂到已经定义好的服务或事件接口上。
这篇文章不会把仓库里的几百个 package 逐个念一遍。我们会沿着一个具体任务,拆解四个真正值得关注的设计:
- 为什么 DeepSeek 把 Harness 做成一棵插件树;
- 一次 Agent 执行怎样变成可以回放的事件日志;
- “能力 seam”怎样把工具、沙箱和子 Agent 从主循环里拆出去;
- 标准、PTC、极简与创造四种模式,分别在验证什么。
先给结论:DeepSeek Harness 目前还不是一个适合直接押注生产环境的稳定框架,但它把 Agent 工程正在发生的变化展示得很清楚——模型只是执行者,真正决定系统边界的,是模型外面的工作流架构。
一、Harness 到底是什么:不是模型外面套一层 Prompt
先假设我们给一个代码 Agent 下达任务:
给订单列表增加 CSV 导出功能,
保持现有权限规则不变,
修改后运行测试并说明风险。
模型看到的只是一段自然语言,但真正完成任务需要一整套外部能力:
- 找到项目目录和仓库说明;
- 搜索订单页面、接口和权限代码;
- 修改前端与后端文件;
- 运行测试或启动开发服务器;
- 记录每次工具调用和结果;
- 在危险命令前请求用户确认;
- 上下文太长时压缩历史;
- 必要时把测试或调研交给子 Agent;
- 最后把过程与结果呈现在界面上。
把这些环节组织起来的运行系统,就是 Agent Harness。
它不只是系统提示词,也不等于工具调用 SDK。更准确地说,Harness 决定了:模型能看到什么、能调用什么、调用前经过哪些检查、结果如何保存、失败以后怎样继续,以及用户在哪些位置能够介入。
过去我们常用一句话概括 Agent:
模型 + 工具 + 循环
DeepSeek Harness 展示的是更完整的版本。下面这张图把一次执行中五个责任主体串了起来:
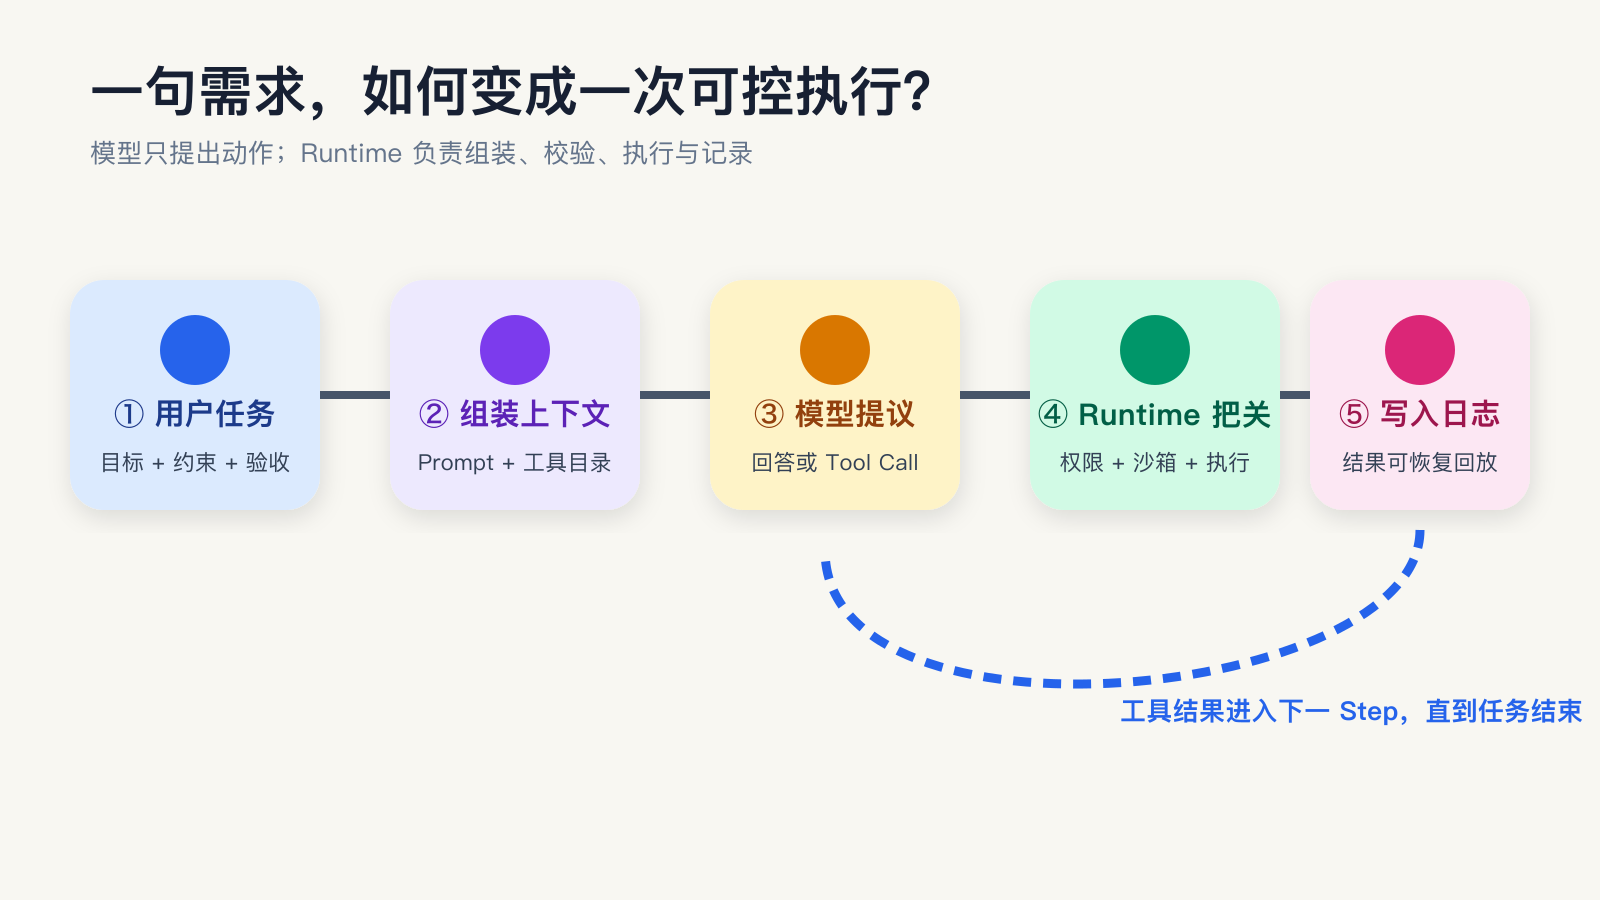
这里每一层都可能变化。如果把它们写死在一个巨大的 Agent Loop 里,增加一个模型、替换一种沙箱或改变会话存储,都可能影响整个系统。
DeepSeek 选择先把这些变化点拆开。
二、“一切皆插件”解决的不是扩展数量,而是替换成本
DeepSeek Harness 构建在 Cordis 之上。官方把 Cordis 描述成支持“时空可组合性”的元框架。
这个词听起来很学术,放到 Agent 工程里可以拆成两个更具体的问题:
- 空间上的组合:一个插件依赖什么服务,系统能否在正确的上下文里把它们接起来;
- 时间上的组合:插件卸载以后,它注册的服务、事件监听和副作用能否一起撤销。
例如,我们想把本地文件系统换成远程沙箱。
在传统实现里,Shell、文件编辑、持久终端和 LSP 可能各自写了一套“远程模式”。迁移时要同时修改多条链路。
DeepSeek Harness 则把文件系统、子进程和沙箱抽成能力接口。只要相关消费者都通过同一个接口取能力,替换提供方以后,Bash、PTY、文件访问和 LSP 就能进入同一个新的执行环境,而不必各写一套产品分支。
这就是插件架构最实际的价值:
不是让插件市场看起来更热闹,而是把“我要改哪一块”限制在清晰的边界里。
官方架构里,一次运行不是加载一张平铺的插件清单,而是从多层配置组合出一棵插件树:
- 最底层的
dsh-base提供模型适配、工具注册、持久化、沙箱、审批、设置、凭据和遥测; webprofile 在上面增加浏览器应用;headlessprofile 增加一次性自动化运行器,不启动服务器;- 用户的 patch 和命令行 overlay 可以继续替换某个配置行,或插入新的插件。
运行下面的命令,开发者可以看到自己机器最终启动的真实配置:
dsh --profile web --dump-config
这点很重要。一个可扩展系统最怕“文档说一套,运行时其实是另一套”。DeepSeek Harness 至少在设计上把最终组合结果变成了可检查的对象。
三、Host 与 Agent Preset:共享底座和单次会话不能混在一起
要理解这套插件树,需要先区分两个平面。
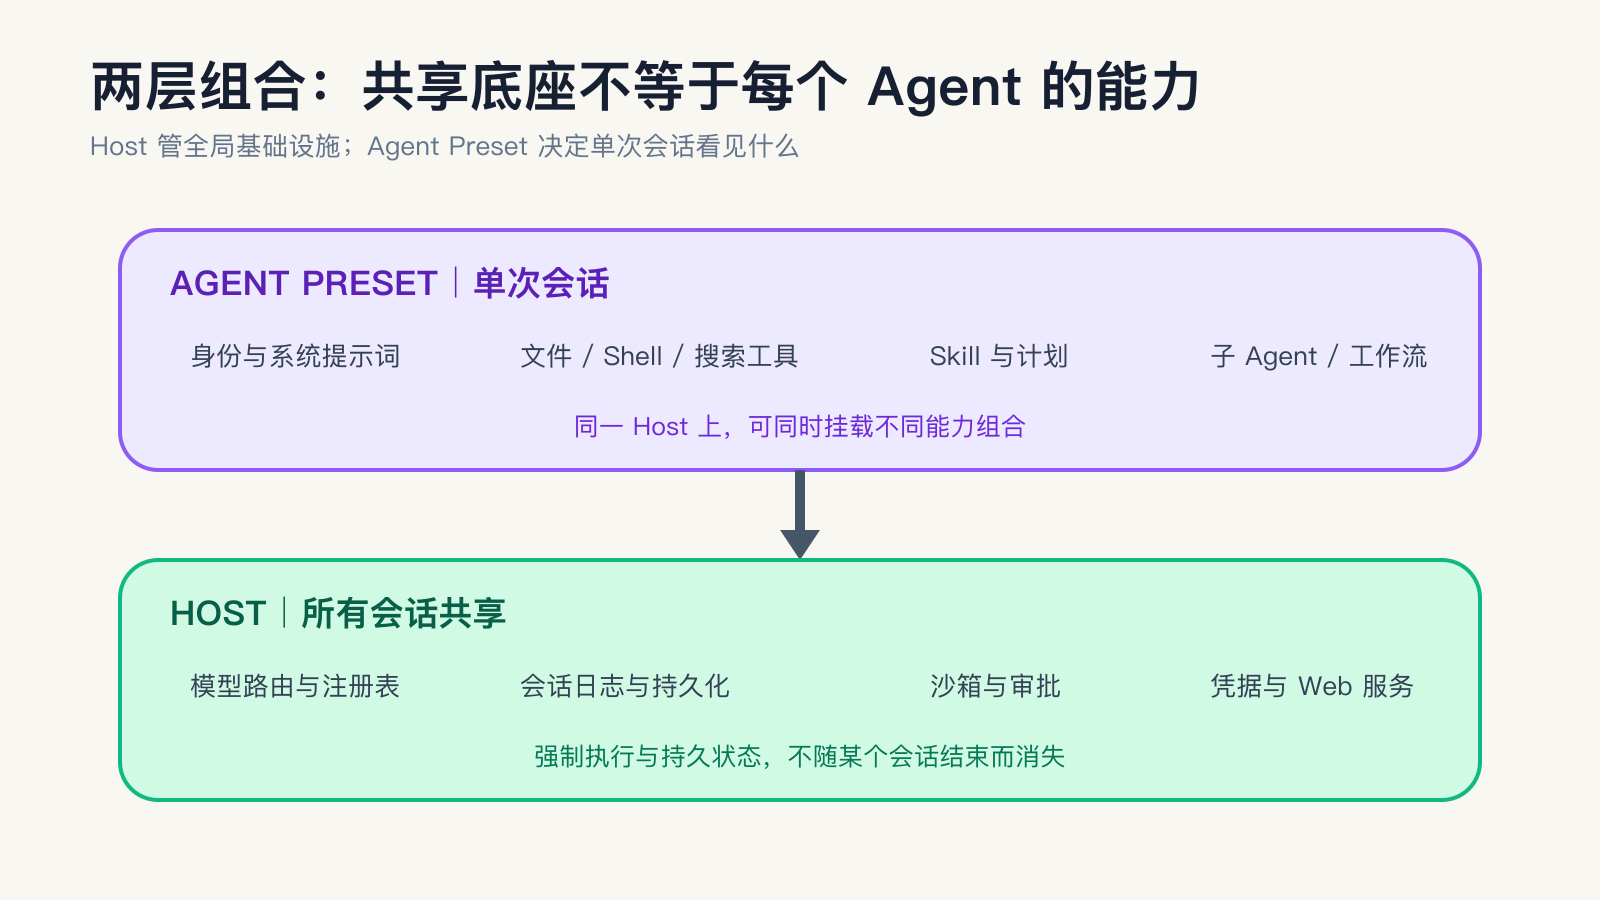
下面这张图表达的是关键关系:下层是所有会话共享的 Host,上层是某个会话选择的 Agent Preset,中间通过事件和服务接口连接。
Host 平面:负责所有会话共享的基础设施
Host 里放的是进程级或跨会话能力,例如:
- 模型路由与适配器;
- 会话存储和持久化;
- 工具、Skill 与子 Agent 注册表;
- 沙箱和审批策略;
- 凭据、设置与遥测;
- Web 服务和客户端连接。
这些能力不能因为某个会话结束就消失,也不能被第二个会话重复注册后发生冲突。
Agent Preset 平面:决定这次会话“是什么 Agent”
Preset 决定单个 Agent 能看到和使用什么,例如:
- 它的身份说明与系统提示词;
- 暴露哪些文件、Shell 和搜索工具;
- 是否加载 Skills;
- 是否支持计划、目标和上下文压缩;
- 是否允许创建子 Agent 或运行工作流;
- 工具以普通调用还是 Code Mode 呈现。
这让“产品功能”和“某个 Agent 的能力集合”分开了。
还是回到 CSV 导出任务。公司可以在 Host 层统一规定:所有命令都经过工作区沙箱,高风险操作必须审批,会话日志写入指定存储。与此同时,可以给开发 Agent 装完整工具,给代码评测 Agent 只装两个固定工具。
两者使用同一套运行底座,却不需要看到同一份能力目录。
这比在系统提示词里写“评测时请不要使用网络”更可靠,因为能力是否存在,最终由运行时组合决定,而不是依赖模型自觉遵守。
四、一次执行为什么要写成事件日志
DeepSeek Harness 里,Session Event Log 是模型上下文的事实来源。
一次任务不会只保存最终答案,而是把过程记录成一系列持久事件,包括:
turn/start与turn/end;step/start与step/end;- 用户消息;
- 模型的流式输出与完整消息;
- 工具调用与工具结果;
- 当前模型、推理配置、系统提示词和工具 schema 的请求快照。
官方给出的核心约束可以概括成一句话:
模型看见过的内容,必须能够从日志里重建。
为什么要这么严格?
假设 CSV 导出任务进行到一半,Agent 已经修改了后端接口,并运行过一次失败测试。此时用户刷新页面,或者系统需要从旧会话恢复。
如果历史只是一段拼接后的聊天文本,运行时很难准确回答:
- 当时模型拿到的是哪套工具;
- 哪个工具调用对应哪个结果;
- 哪条消息是用户输入,哪条是系统注入的文件变化;
- 请求发出前的沙箱与审批策略是什么;
- 失败发生在模型请求、流式传输还是工具执行阶段。
事件日志把这些状态拆成可区分的事实。Web UI 回放、会话恢复、分叉、遥测和持久化,都从同一条事件流派生。
这不意味着 Event Sourcing 自动解决了一切。日志结构一旦成为事实源,事件兼容、存储体积、敏感信息和迁移成本都会变成长期责任。
但对于长时间运行、可以中途接管、需要审计的 Agent,这种责任通常比“无法重建当时发生了什么”更可控。
五、Agent Loop 很薄,能力从 seam 接进来
很多 Agent 框架的主循环会不断膨胀:先接 Tool Calling,再加记忆、子 Agent、审批、重试、定时任务、代码执行和各种模型特例,最后谁都不敢动。
DeepSeek Harness 的 Agent Loop 主要负责推进 Turn 和 Step:领取输入、组装请求、调用模型、执行工具,再判断是否需要进入下一步。前面那张任务链路图中的“Runtime 把关”和“写入日志”,就是这个循环每一步都会经过的固定边界。
DeepSeek Harness 没有把文件操作、代码执行、任务委派等能力直接写进 Agent Loop,而是为每类能力预留一个统一的接入口。官方把这个接入口称为 seam。
一种能力接入 Harness,通常要经过三层:
- 先规定能力怎样调用:例如,任务委派能力需要接收什么信息、返回什么结果;
- 再接入一个具体执行者:例如,在当前程序中启动本地子 Agent,或者调用 Codex、Claude Code;
- 最后把能力提供给模型:工具插件把它包装成模型可以调用的“委派任务”工具。
实际执行过程是:
模型调用“委派任务”工具
        ↓
工具把任务交给统一的子 Agent 接口
        ↓
当前配置的执行者完成任务
        ↓
结果通过工具返回给模型
在这个过程中,Agent Loop 不需要知道任务最终由谁完成。它只负责接收模型的工具调用并推进下一步。至于是启动本地子 Agent,还是调用外部 Agent,由接在这个能力接口后面的插件决定。
这样设计的好处是:如果以后想把本地子 Agent 换成 Codex,只需要替换提供任务委派能力的插件,不必修改模型使用的工具,也不必重写 Agent Loop。
文件系统、模型调用、会话存储、审批、沙箱、代码运行时和 LSP 采用的也是相同思路:先规定统一的使用方式,再接入不同实现,最后由工具或其他插件调用。
这里需要一个边界判断:seam 不是越多越好。
如果一个能力只有接口,没有第二种实现,也没有真实消费者,抽象层只会增加理解成本。DeepSeek Harness 值得学习的不是 package 数量,而是它尝试把每个变化点的定义、提供方与消费者写清楚。
六、四种 Preset,其实是四个 Harness 实验
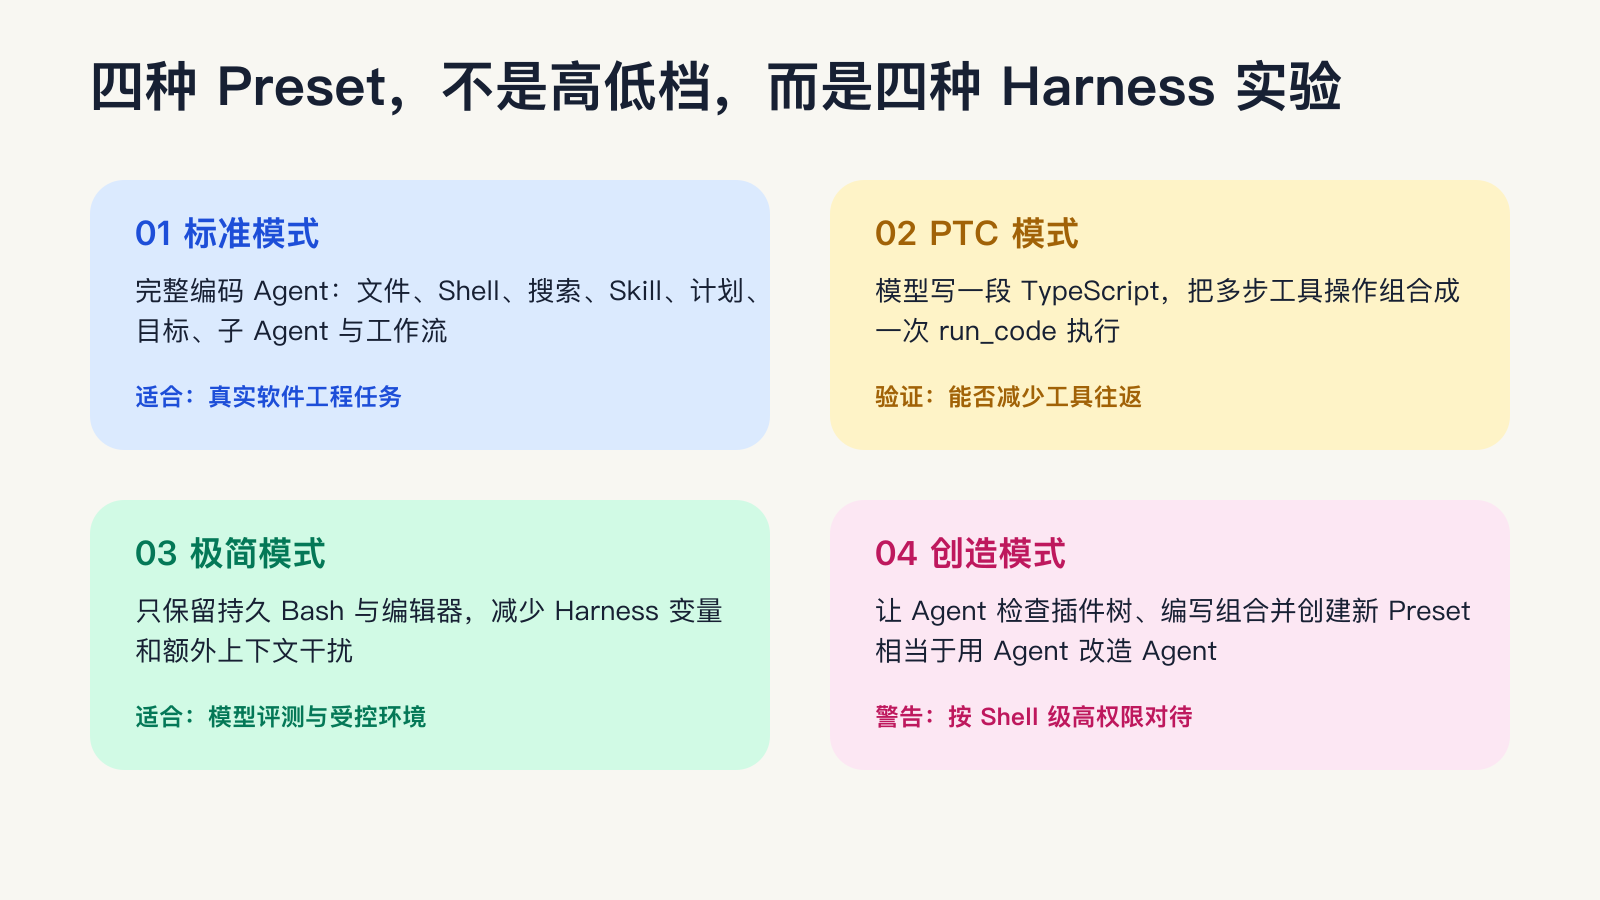
当前 Web 版本内置四种 Agent Preset。它们不是简单的“能力高、中、低”档位,而是在验证四种不同的 Agent 组织方式。
1. 标准模式:完整的编码 Agent
标准模式提供文件编辑、Shell、文件与网页检索、Skills、计划、目标、子 Agent 和工作流。
它适合真实的软件工程任务,也是观察 DeepSeek Harness 全部组件如何协作的默认入口。
在 CSV 导出任务里,标准模式可以搜索代码、维护计划、修改文件、启动后台测试,再把一部分检查交给子 Agent。
2. PTC 模式:把多次工具调用编译成一段程序
官方配置中把它称为 PTC 模式。它保留标准模式的能力,但改变了工具呈现方式:模型不再为每个动作单独发起一次 Tool Call,而是针对生成的 SDK 写一段 TypeScript 程序,再由 run_code 执行。
例如,普通模式可能需要五轮往返:
搜索文件 → 读取文件 → 搜索符号 → 读取测试 → 汇总结果
PTC 模式可以把这组操作写成一个程序,在一次运行里调用多个宿主工具,再返回结构化结果。
它的潜在收益是减少模型与工具之间的往返,并让循环、筛选、并发和错误处理直接写进代码。
但这里不能简单得出“Code Mode 一定更快、更省 Token”。最终效果取决于模型是否擅长生成可靠程序、工具返回大小、失败后的修复成本,以及执行环境的限制。官方当前也没有在仓库中给出足以支持普遍性能结论的完整基准。
还有一个很重要的安全细节:代码运行时文档明确写着,worker-thread、process、container 这些 isolation 标签只是执行基底描述,本身不构成安全承诺。真正的权限边界仍要看宿主暴露了什么 binding、沙箱怎样限制进程,以及审批策略是否生效。
3. 极简模式:只留下持久 Bash 和编辑器
极简模式只有两个工具:持久 Bash 与 str_replace_editor。它关闭了运行时上下文快照,也不提供上下文压缩。
这看起来像“功能缩水版”,其实很适合做模型和 Harness 对比。
如果我们想测试一个模型在固定工具条件下的代码能力,完整模式里的搜索、Skill、子 Agent 和工作流都会成为额外变量。极简模式用更小的工具面减少干扰,也更接近很多编码基准采用的受控环境。
4. 创造模式:让 Agent 修改自己运行的 Harness
创造模式最有实验性。它在标准模式之上增加 Cordis 运行时检查、插件实验和 Preset 创作能力,让用户可以要求 Agent 设计另一个 Agent。
例如:
帮我创建一个只允许读取仓库、运行测试,
但不能修改源文件的代码审查 Preset。
Agent 可以检查当前插件树,编写新的组合配置,并把它安装成可选 Preset。
这已经接近“用 Agent 改造 Agent Harness”。但官方配置里的警告也非常直接:创造模式可以执行模型生成的 JavaScript,并修改其他会话将要加载的组合,应当把它视为 Shell 访问级别 的高权限能力。
因此,它适合受控环境里的探索,不适合在不可信仓库、不可信 Prompt 或开放用户场景中默认启用。
七、权限不是一句“请小心”,而是两个独立旋钮
DeepSeek Harness 把权限拆成两个相互独立的运行时状态:
- Sandbox Mode:操作能够触达哪些文件、进程和外部环境;
- Approval Policy:执行某类操作前,是否需要用户确认。
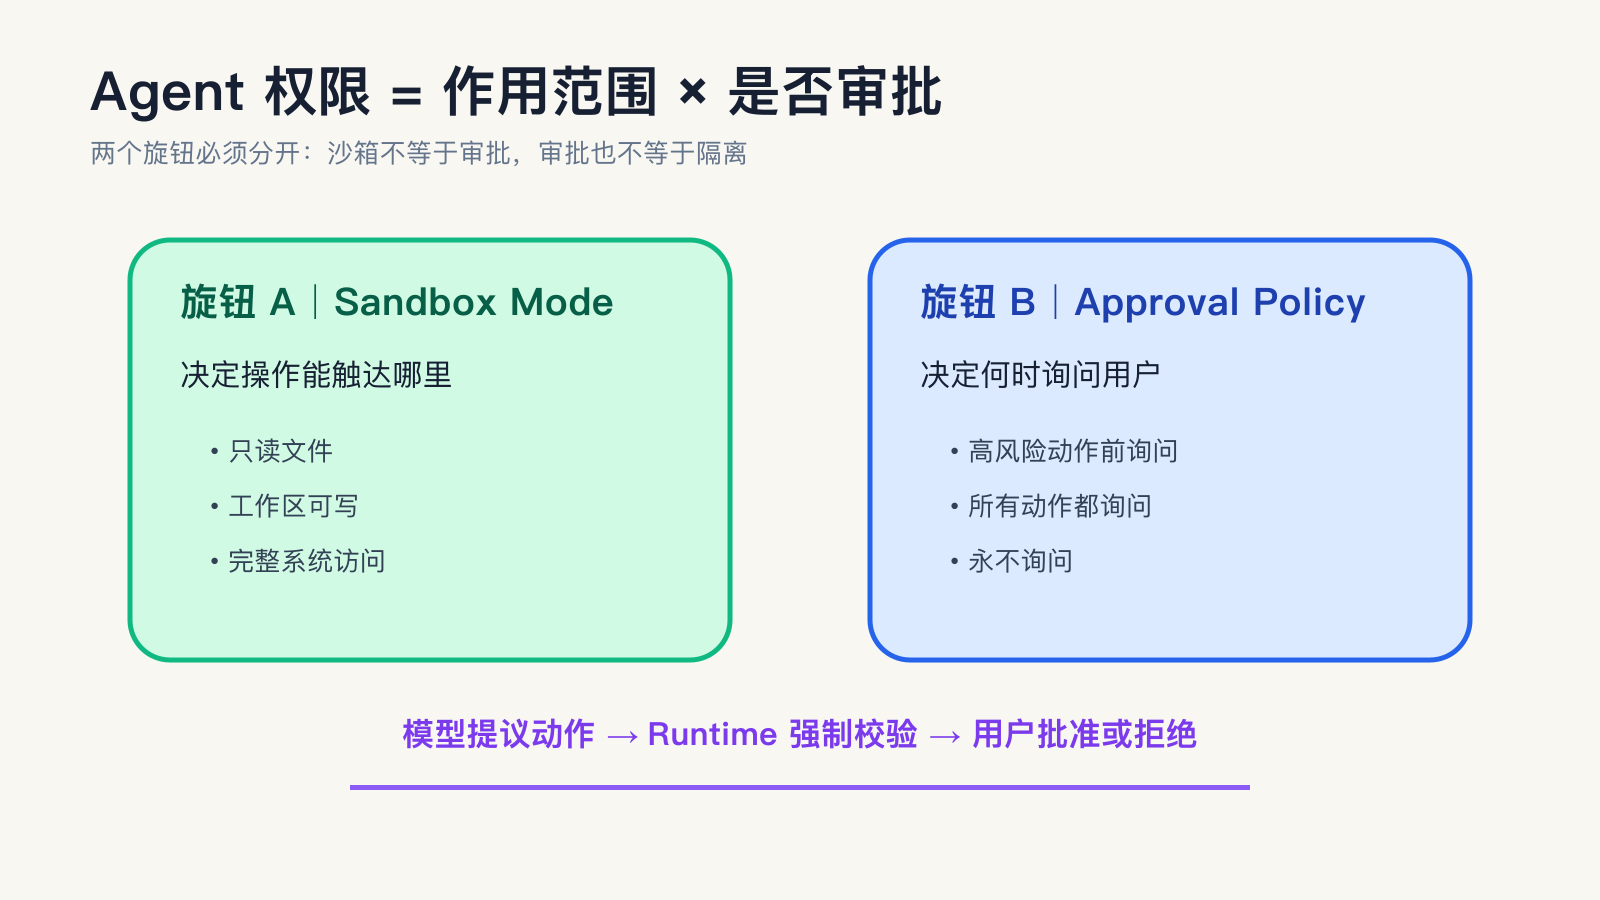
默认权限预设包含:
workspace-write:允许在工作区写入,同时需要按策略询问;danger-full-access:放开隔离,并且不再询问。
这两项必须分开理解。
“需要审批”不代表操作一定被沙箱隔离,“处于沙箱”也不代表所有动作都不需要确认。Preset 只负责把两个旋钮组合成一个方便用户选择的名称,真正执行限制的仍然是各自的沙箱和审批组件。
放到 CSV 导出任务里,模型可以提出运行数据库迁移或安装新依赖,但是否真的执行,不由模型最后一句自然语言决定。工具执行管线会读取当前权限状态,在需要时请求用户确认,并把请求与决定写入审计事件。
这是 Agent 产品里一个经常被混淆的职责边界:
- 模型负责提出动作;
- Runtime 负责校验、限制和执行;
- 用户负责批准或拒绝高风险动作。
任何把这三件事都交给 Prompt 的设计,都很难形成可靠的安全边界。
八、它最值得 Agent 开发者学习的三个判断
判断一:同一个模型,应该允许拥有不同的 Harness
标准模式适合完整开发,极简模式适合受控评测,PTC 模式适合尝试代码化编排,创造模式适合设计新 Agent。
这说明“这个模型强不强”并不是一个脱离运行环境就能回答的问题。工具目录、上下文结构、权限边界和任务推进方式变化以后,同一个模型会表现成不同的产品。
判断二:可观测性要从事实日志开始
如果 Agent 的恢复、回放、审计和调试分别维护四套状态,它们迟早会互相矛盾。
DeepSeek Harness 让 Web UI、模型历史、会话恢复、分叉与遥测都从事件流派生。这个实现还需要经受真实规模的检验,但方向值得借鉴:先明确哪些是持久事实,再决定界面怎样展示。
判断三:插件化的最终目标是可替换,而不是可安装
真正成熟的插件架构,不只允许“再加一个工具”,还要允许替换模型适配、文件系统、沙箱、持久化和子 Agent 提供方,并在卸载时撤回插件造成的副作用。
这比做一个插件商店困难得多,也更接近企业 Agent 的真实需求。
九、现在不该被忽略的限制
DeepSeek 官方已经明确标注:项目目前处于 Developer Preview,正在快速迭代,未来会出现破坏兼容性的变更。
因此,现阶段更合理的使用方式是:
- 用它研究 Agent Runtime 与插件架构;
- 在隔离环境里尝试四种 Preset;
- 用自己的任务比较普通 Tool Calling 与 PTC;
- 验证事件日志、恢复、权限和子 Agent 是否符合需求;
- 暂时不要把第三方插件兼容性和配置格式当成稳定承诺。
另外,模块化并不会自动带来简单性。
DeepSeek Harness 的仓库已经包含大量 package、配置层、事件类型和生成文档。对于只想做一个固定工作流的小团队,这套架构可能明显过重。只有当模型、执行环境、权限、客户端和 Agent 形态确实需要频繁替换时,它的组合成本才更容易得到回报。
最强的替代解释也值得保留:DeepSeek Harness 现在展示出的很多价值,来自架构完整度和设计 ambition,而不是已经被大规模生产负载验证的结果。开发者预览阶段,我们可以评价它的边界是否清楚,却不应该提前替它证明稳定性、性能或生态成熟度。
结语
过去一年,大家讨论 Agent 时经常把注意力放在模型更新上:上下文更长、推理更强、Tool Calling 更稳定。
DeepSeek Harness 把视线往外移了一层。
模型提出动作以后,谁来组装上下文?谁来执行工具?谁来限制文件和进程?谁来记录事实?谁来恢复会话?谁来决定一个子 Agent 是本地创建,还是委派给另一个产品?
这些问题的答案共同构成 Harness。
DeepSeek 这次开源的价值,不是宣布了一套唯一正确的 Agent 架构,而是把这些原本藏在产品内部的工程决策拆出来,做成了可以阅读、运行和替换的组件。
如果你正在开发 Agent,不必马上采用它的全部设计。更实际的下一步,是拿自己的一条真实工作流做一次拆解:
哪些能力属于所有会话共享的 Host?
哪些能力只属于某个 Agent?
模型看见的内容能否从日志重建?
高风险动作由哪一层强制拦截?
替换模型、沙箱或子 Agent 时,需要改多少地方?
能回答清楚这五个问题,通常比再加一个“万能工具”更接近可靠的 Agent 系统。
参考资料
-
DeepSeek Harness 官方仓库
https://github.com/deepseek-ai/deepseek-harness -
DeepSeek Harness 架构文档
https://github.com/deepseek-ai/deepseek-harness/blob/master/docs/architecture.md -
DeepSeek Harness Web UI 使用指南
https://github.com/deepseek-ai/deepseek-harness/blob/master/docs/user/guide/index.md -
DeepSeek Harness 代码运行时文档
https://github.com/deepseek-ai/deepseek-harness/blob/master/docs/subsystems/code-runtime.md -
DeepSeek Harness 权限预设文档
https://github.com/deepseek-ai/deepseek-harness/blob/master/docs/subsystems/permission-presets.md -
Cordis 论文:A Programming Paradigm for Spatiotemporal Composability
https://github.com/cordiverse/paper