模型为什么要有推理强度?一文看懂 OpenAI、Claude、Kimi 与 DeepSeek 的档位设计
同一个模型为什么既能秒回,也能持续分析?本文从模型选择与推理强度的区别讲起,对照四家官方文档,梳理不同模型支持的档位、默认值,以及质量、延迟和成本之间真正该怎样取舍。
文章目录
- 导语
- 一、先分清两个问题:选什么模型,和让它想多久
- 二、推理强度到底控制什么
- 1. 推理强度不是严格的 Token 配额
- 2. 更高档位不保证答案一定更好
- 三、怎样理解常见的推理档位
- none 或 minimal:不推理或极少推理
- low:轻量推理
- medium:平衡档
- high:高强度推理
- xhigh 或 max:超高与最大推理
- 四、四家厂商的模型分别支持哪些档位
- 1. OpenAI GPT-5.6:从关闭推理到最大推理
- 2. Claude:effort 不只影响内部思考
- 3. Kimi K3:始终推理,默认就是 max
- 4. DeepSeek V4:真正有效的是 high 与 max
- 五、为什么不同厂商的同名档位不能直接比较
- 六、实际使用时,应该从哪一档开始
- 七、推理强度最终应该成为路由策略的一部分
- 结语
- 参考资料
导语
最近用 Codex、Claude Code 或各家模型 API 时,你大概率见过这些选项:
low、medium、high、xhigh、max
它们通常被叫作 推理强度(reasoning effort)。
同一个模型,把档位从 low 调到 high,回答可能会更慢,工具调用可能会更多,代码检查也可能更完整。于是一个很自然的理解是:
推理档位越高,模型就越聪明。
但这个理解只对了一半。
推理强度确实会影响模型愿意为当前任务投入多少计算和推理资源,但它不是“智商滑块”,也不是越高越好。更重要的是,不同厂商虽然都在使用 high、max 这些名字,背后的默认值、可选档位和控制范围并不相同。
这篇文章会解决三个问题:
- 推理强度究竟控制什么;
- OpenAI、Claude、Kimi 与 DeepSeek 的最新知名模型分别支持哪些档位;
- 实际做产品或 Agent 时,怎样找到质量、延迟和成本之间更合适的档位。
本文所有档位信息均来自截至 2026 年 8 月 1 日 可查到的厂商官方文档。没有官方依据的档位,不纳入比较。
一、先分清两个问题:选什么模型,和让它想多久
使用大模型完成任务时,我们实际上在做两个不同的决定。
第一个决定是 选什么模型。
更强的模型通常适合复杂、开放式任务;更轻量的模型适合分类、抽取和高并发服务。比如 OpenAI 将 GPT-5.6 Sol 定位为前沿能力模型,Terra 用于平衡能力与成本,Luna 则面向成本敏感的高吞吐任务。
第二个决定是 给选定模型设置多高的推理强度。
它决定这个模型处理当前请求时,倾向于投入多少推理资源。两者的关系可以画成这样:
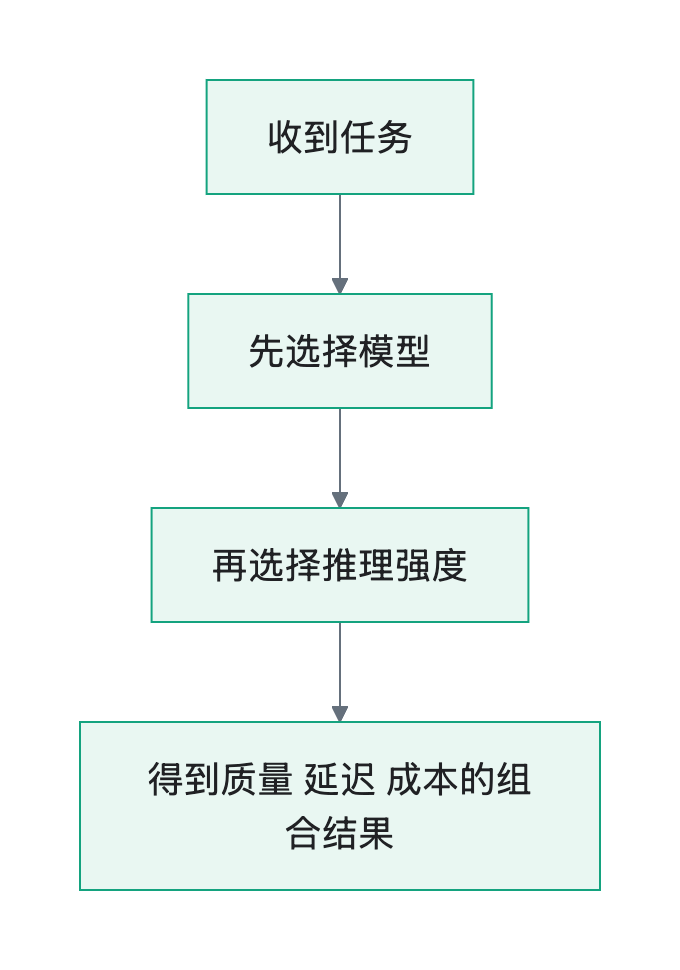
可以把它类比为选人和安排工作时间:
- 模型决定由谁来做;
- 推理强度决定允许他在这件事上投入多少精力。
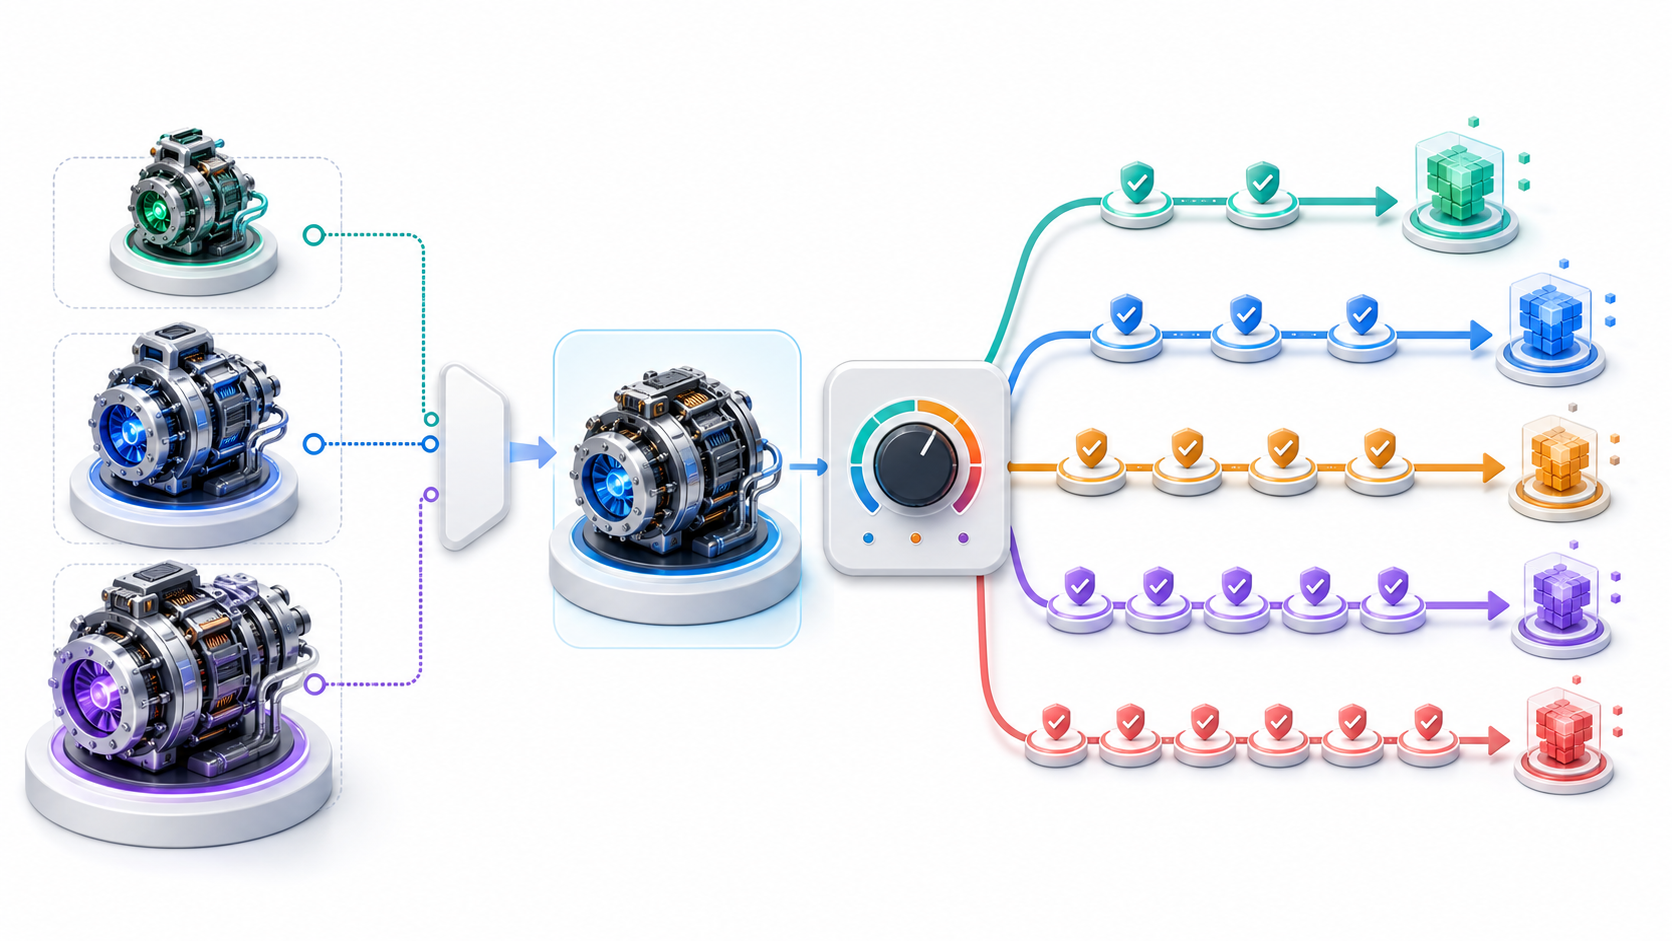
这两个旋钮彼此独立。下面这张图要表达的,正是先选合适的计算引擎,再决定让它走多深的推理路径。
这一区分非常重要。因为当结果不理想时,你需要先判断:问题到底是模型能力不足,还是现有模型没有投入足够推理;反过来,如果任务只是提取三个字段,换最强模型并打开最高档位,也可能只是把简单工作做得更贵。
二、推理强度到底控制什么
推理模型在给出最终答案前,会使用一部分推理 Token 规划步骤、比较方案、处理歧义和检查结果。
以 OpenAI 的官方解释为例,推理 Token 通常不会把完整内部推理直接展示给用户,但仍会占用上下文空间,并按输出 Token 计费。
提高推理强度后,模型可能出现这些变化:
- 在行动前进行更完整的规划;
- 检查更多候选方案和边界情况;
- 在 Agent 任务中调用更多工具;
- 在代码任务中增加验证和调试步骤;
- 使用更多推理 Token,带来更高延迟和成本。
这里有两个容易误解的地方。
1. 推理强度不是严格的 Token 配额
它更像一个行为信号。模型仍会根据任务难度自适应:简单问题即使设置较高档位,也未必消耗大量推理资源;困难问题在较低档位下,也不代表完全不思考。
Anthropic 的文档就明确提醒,effort 是行为信号,不是严格的 Token 预算。OpenAI 也说明模型会在同一推理档位下,根据问题复杂度自适应使用推理 Token。
2. 更高档位不保证答案一定更好
如果任务失败是因为缺少资料、工具返回错误、上下文被截断,或者工作流没有验证环节,多增加推理 Token 未必能解决问题。
例如,一个报告 Agent 没有拿到真实指标文件。即使把推理档位从 medium 调到 max,它也不能凭空知道正确数据。这时需要修复的是信息输入和核对流程,而不是继续增加思考量。
三、怎样理解常见的推理档位
不同厂商没有共享一套统一标准。不过,从官方文档对各档位的用途描述来看,可以先建立一个粗略的任务梯度。
none 或 minimal:不推理或极少推理
适合分类、抽取、路由、简单改写和快速查询。任务规则清楚,不需要多步规划。
优势是响应快、资源消耗低;面对隐含约束、复杂工具调用或多步推导时,则更容易漏掉问题。
low:轻量推理
适合资料整理、普通写作、客服问答、简单数据分析,以及目标明确的代码修改。
它通常比完全关闭推理更稳,同时仍然优先考虑速度和成本。很多日常 Agent 请求都可以从这一档起步。
medium:平衡档
适合需要规划、判断和多步骤执行的任务,例如研究资料、分析表格、编写方案、排查代码问题,或者完成一段有限长度的工具调用流程。
它常被用作质量、延迟和成本之间的基线,但并不是所有厂商都提供这一档,也不是所有模型都默认使用它。
high:高强度推理
适合复杂调试、技术方案设计、困难推导、重要决策分析和长流程 Agent。模型通常会投入更多资源规划和检查,因此延迟与成本也可能增加。
xhigh 或 max:超高与最大推理
主要面向长时间运行的编程 Agent、深入研究、安全审查,以及质量优先的高价值任务。
这两档最需要用评测来决定。把所有请求一律设为最高档,通常不会让所有结果等比例变好,却很容易让整个系统变慢、变贵。
四、四家厂商的模型分别支持哪些档位
下面这张表只保留官方文档明确公布的信息。
| 厂商与模型 | 官方支持档位 | 官方默认值 |
|---|---|---|
| OpenAI GPT-5.6 Sol、Terra、Luna | none、low、medium、high、xhigh、max |
medium |
| Claude Opus 5、Sonnet 5 | low、medium、high、xhigh、max |
high |
| Kimi K3 | low、high、max |
max |
| DeepSeek V4-Pro、V4-Flash | high、max |
普通请求为 high |
把它们放在一起后,会看到一个很有意思的差异:有的厂商允许完全关闭推理,有的模型始终推理;有的从中档起步,有的默认就使用最高档。
接下来逐个看。
1. OpenAI GPT-5.6:从关闭推理到最大推理
GPT-5.6 系列支持六档:
none → low → medium → high → xhigh → max
默认值为 medium。
OpenAI 官方建议:抽取、分类和简单改写可以优先尝试 low;诊断问题、比较方案、编写计划和代码推理可使用 medium 或 high;xhigh 与 max 应在代表性评测证明有效后再启用。
需要注意,Sol、Terra 和 Luna 的模型能力定位不同。相同的 medium,只表示它们各自在本模型内部使用同名配置,并不意味着三者会得到同样的结果。
OpenAI 还提供独立于 effort 的 Pro mode。它会让系统在返回单个最终答案前投入更多模型工作,但这不是 max 之上的第七个推理档位,不能和 effort 混成一条刻度。
2. Claude:effort 不只影响内部思考
Claude 通过 output_config.effort 控制强度。Claude Opus 5 和 Sonnet 5 支持五档:
low → medium → high → xhigh → max
默认值为 high。
Anthropic 特别强调,effort 会影响整个回答过程,包括可见文本、工具调用、函数参数,以及启用 thinking 后的思考过程。
在工具任务里,较低 effort 往往会减少工具调用、压缩说明并更直接地行动;较高 effort 则可能增加探索、检查和总结。xhigh 主要面向长时间运行的编程与 Agent 任务,max 面向不限制 Token 投入、追求最高能力的场景。
这意味着 Claude 的 effort 不是单纯调节“回答前想多久”,它还可能改变 Agent 完成整个任务的工作方式。
3. Kimi K3:始终推理,默认就是 max
Kimi K3 始终启用思考模式,不能完全关闭推理。它通过顶层字段 reasoning_effort 提供三档:
low → high → max
默认值为 max。
如果推理时间过长,Kimi 官方建议把强度降低到 low。因此,Kimi K3 的最低档不是“不推理”,而是减少推理投入。
这也说明了为什么不能只看档位名称:OpenAI 有 none,Kimi K3 则没有对应选项。两家的最低档不是同一种行为。
4. DeepSeek V4:真正有效的是 high 与 max
DeepSeek V4-Pro 和 V4-Flash 同时支持思考与非思考模式。开启思考后,官方提供两个实际档位:
high → max
普通请求默认使用 high;部分复杂 Agent 请求会自动设置为 max。
为了兼容已有客户端,传入 low、medium 时会映射到 high,传入 xhigh 时会映射到 max。也就是说,这些兼容名称不会形成额外的实际档位。
因此,在 DeepSeek V4 中,最重要的是先决定是否启用思考,再决定使用 high 还是 max。
五、为什么不同厂商的同名档位不能直接比较
看到两款模型都支持 high,很容易把它们理解为相同的推理预算。
但目前这些名称只是厂商内部的控制接口,不是一套行业统一标准。不同模型在以下方面都可能不同:
- 推理 Token 的计算与计费方式;
- 是否允许关闭推理;
- 是否展示独立的 reasoning 内容;
- 推理强度是否影响工具调用;
- 模型是否自动调整思考量;
- 默认档位如何设置。
所以,不能因为 Claude 和 OpenAI 都提供 high,就认为它们会使用相同 Token、产生相同延迟或达到相同质量。
真正可以比较的单位不是档位名称,而是:
完成一类真实任务时,
成功率、延迟、Token 和成本的组合结果。
六、实际使用时,应该从哪一档开始
一个更可靠的方法,是先按任务复杂度选择起点,再通过真实任务逐档评测。
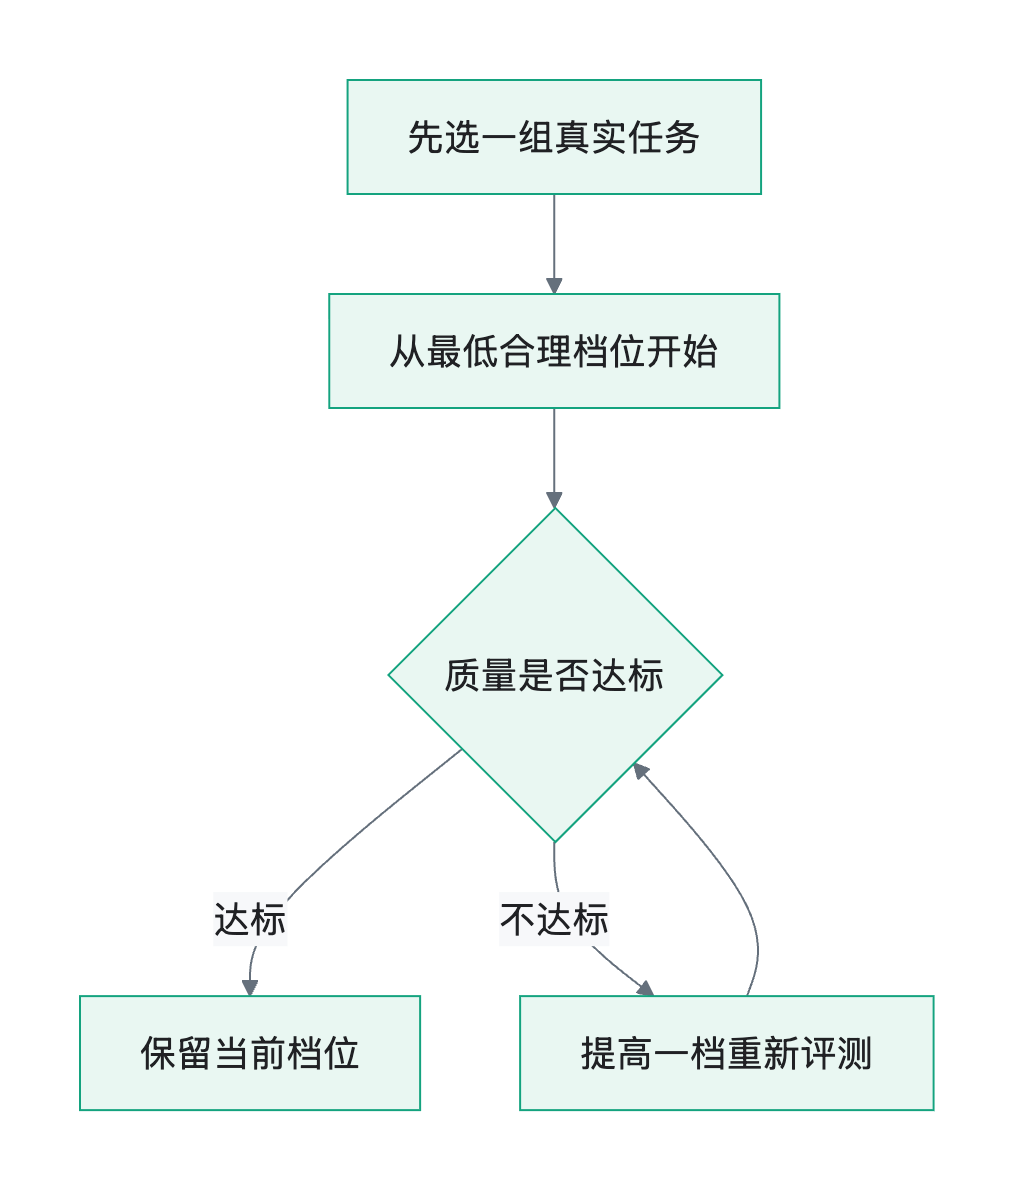
可以先用下面这套经验建立基线:
- 抽取、分类、格式转换和简单改写:从最低有效档开始;
- 写作、资料整理和明确的代码修改:从
low或medium开始; - 复杂调试、研究分析和多工具 Agent:从
medium或high开始; - 安全审查、长时间编程和质量优先任务:评测
xhigh或max。
只有出现下面几类证据时,才值得继续提高档位:
- 当前档位经常漏掉关键约束;
- 失败主要来自规划或检查不足;
- 错误结果的代价明显高于额外调用成本;
- 任务可以异步运行,对延迟不敏感;
- 实际评测证明更高档位提高了成功率。
评测时不要只看单次回答是不是更长、更像“认真思考过”。至少应该记录:
- 任务是否真正完成;
- 关键事实或计算是否正确;
- 工具调用是否有效;
- 首次响应与总完成时间;
- 输入、输出和推理 Token;
- 每个成功任务的平均成本。
如果从 medium 提升到 high 后,答案只是变长,却没有提高任务成功率,那么更高档位并没有带来实际价值。
七、推理强度最终应该成为路由策略的一部分
在真实系统里,推理强度不必是一个永远不变的全局配置。
一个更成熟的 Agent,可以根据任务类型选择模型与档位:
- 简单请求交给轻量模型和低档位;
- 普通知识工作使用平衡档;
- 检测到复杂代码、长链路工具调用或高风险操作时,提高强度;
- 如果高档位仍失败,再考虑换模型、补上下文或调整工作流。
这比“所有请求都用最强模型、最高推理强度”更接近真实工程需要。因为我们最终优化的不是某一次回答看起来有多聪明,而是系统能否在可接受的时间和成本内稳定完成任务。
结语
推理强度的价值,是让同一个模型能够适应不同工作负载。
简单任务需要快速、稳定和低成本;复杂任务需要规划、探索与检查。最佳档位通常不是最高档,而是能够稳定完成任务的最低档。
因此,一个更实用的原则是:
先选择适合任务的模型,再从中低推理强度建立基线;只有当真实评测证明质量不足时,才逐级提高档位。
当推理强度从一个固定开关变成可评测、可路由的工程参数,模型的能力、延迟和成本才真正开始变得可控。
参考资料
-
OpenAI,Reasoning models:
https://developers.openai.com/api/docs/guides/reasoning -
OpenAI,API deployment checklist:
https://developers.openai.com/api/docs/guides/deployment-checklist -
OpenAI,Model guidance:
https://developers.openai.com/api/docs/guides/latest-model -
Anthropic,Effort:
https://platform.claude.com/docs/en/build-with-claude/effort -
Kimi API Platform,Reasoning Effort:
https://platform.kimi.ai/docs/guide/use-reasoning-effort -
Kimi API Platform,Kimi K3:
https://platform.kimi.ai/docs/guide/kimi-k3-quickstart -
DeepSeek API Docs,思考模式:
https://api-docs.deepseek.com/zh-cn/guides/thinking_mode