Agent 变强,不一定要换模型:RHI 如何让工作流自己进化
Sakana AI 与 UC Berkeley 提出的 RHI,不修改模型权重,而是让 Agent 根据前后两次任务结果,持续改写多 Agent 的分工、交接和复查流程。它真正优化的不是一句 Prompt,而是信息如何在 Agent 之间流动。
文章目录
- 导语
- 一、这篇论文先改变了一个观察角度:Agent 不只等于模型
- 二、为什么不能只把推理档位调高
- 三、RHI 的核心方法:每次只和上一个版本比
- 四、RHI 修改的不是一句 Prompt,而是一套多 Agent 协议
- 五、作者如何验证 RHI
- 六、论文最重要的三个实验结果
- 1. 少量 RHI 迭代,确实抬高了同系列模型的表现
- 2. 提升不只是因为输出变长
- 3. 最终执行阶段的缓存读写和成本下降
- 七、RHI 到底学会了什么
- 八、60% 成本下降,不能理解成整个优化过程便宜了 60%
- 九、这篇论文还没有证明什么
- RHI 不能替代更强模型
- 任务是合成的
- 评审仍然依赖 LLM
- 相邻版本比较会混入随机性
- 它优化的是当前任务
- 十、对 Agent 开发真正有用的启发
- 多 Agent 的问题,常常先出在交接,而不是角色数量
- 评估 Harness,要比较交付物
- 优化记录要能保留过去的教训
- 先算清楚 Harness 会复用多少次
- 结语
- 参考资料
导语
最近读到 Sakana AI 与 UC Berkeley 的一篇新论文,标题叫 《Recursive Harness Self-Improvement》。
论文开头就给出了一个很容易传播的结果:
在 30 个合成的机器学习研究任务上,较低推理档位的 Agent 经过少量 RHI 迭代后,可以超过同系列更高推理档位的基线;在其中一组对比里,最终执行成本最多降低 60%。
第一眼看,这很像又一个“让 Agent 自己改 Prompt”的方法。
但读完论文正文和近 60 页附录后,我觉得它真正想讨论的不是 Prompt 怎么写,而是一个更接近软件工程的问题:
当模型能力暂时不变时,
能不能通过改进分工、交接和返工流程,
让同一个 Agent 系统做出更好的结果?
RHI 给出的答案是:可以,而且最值得优化的可能不是“安排几个专家角色”,而是 Agent 之间到底传什么信息、谁来核对、发现冲突后任务回到哪里。
这篇文章会沿着论文自己的问题意识来讲:
- 为什么作者认为只增加推理强度不够;
- RHI 到底改了 Harness 的什么;
- 实验结果支持了哪些结论;
- 60% 成本下降应该怎样理解;
- 这套方法距离真实生产系统还有多远。
一、这篇论文先改变了一个观察角度:Agent 不只等于模型
我们评价一个 Agent 时,经常直接看它用了什么模型。
模型当然重要,但一个真实运行的 Agent,通常还包含很多模型之外的东西:
- 系统指令;
- 能调用的工具;
- 上下文怎样挑选和压缩;
- 任务怎样拆给子 Agent;
- 子 Agent 返回什么;
- 什么时候继续、停止或返工。
论文把包在模型外面的这一整套运行结构称为 Harness。
如果觉得“脚手架”这个翻译仍然抽象,可以把 Harness 理解成:
Agent 的工作说明书,加上执行它的流程控制器。
同一个开发团队,换一套代码评审、测试和发布流程,交付质量可能完全不同。Agent 也一样:模型没有变化,不代表它接收的信息和完成任务的方式不能变化。
论文由此提出 model–harness co-evolution,也就是模型与 Harness 共进化:
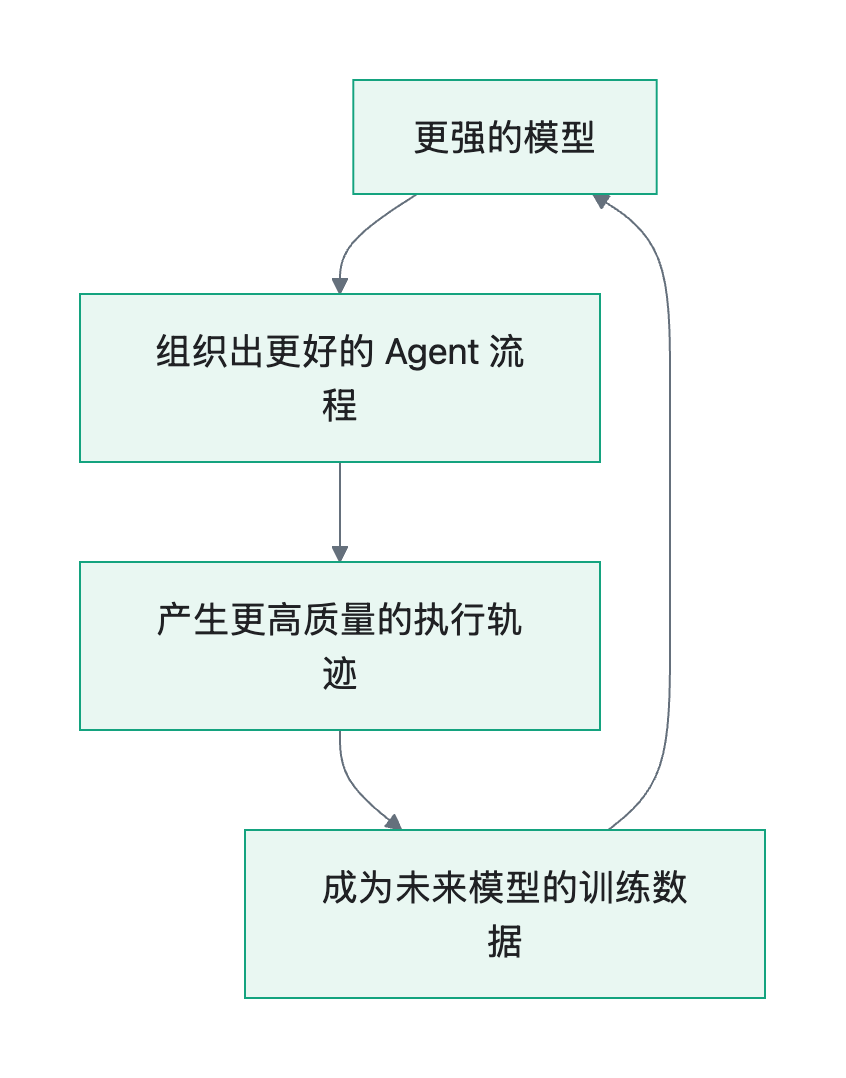
这里的“执行轨迹”,可以理解为 Agent 完成任务时留下的指令、工具调用、文件修改、检查结果和中间决策。
更好的 Harness 如果能产生更可靠的轨迹,这些轨迹未来又可能用于训练新模型,于是形成循环。
不过,这篇论文只研究了循环的前半段:固定模型,怎样改进 Harness。 它没有实际训练下一代模型,这一点后面还会再说。
二、为什么不能只把推理档位调高
今天很多模型提供不同的推理档位,例如 high、xhigh、max。
档位越高,可以粗略理解为模型在回答前投入更多计算。它通常能改善结果,但不是无限有效:到了一定程度,成本继续上升,质量却可能进入平台期。
这就是论文所说的 test-time scaling plateau。不需要记住英文,它描述的就是:
同一个模型继续“多想一会儿”,
收益开始变小。
作者认为,到了这个阶段,问题可能已经不只是某个 Agent 想得不够深,而是整个系统怎样组织计算。
举个最简单的例子:
- 数据 Agent 做出一份指标文件;
- 报告 Agent 没读这份文件,凭摘要写结论;
- 审查 Agent 只检查文章是否完整,没有核对数字;
- 最终报告与真实指标互相冲突。
这时给报告 Agent 更多思考 Token,未必能解决问题。它缺少的不是思考时间,而是一个明确的输入接口和核对步骤。
这正是 RHI 想调整的地方。
三、RHI 的核心方法:每次只和上一个版本比
自动优化 Prompt 和工作流并不是新方向。
已有方法往往一次生成多个候选版本,让它们运行同一个任务,再通过分数或评审挑选更好的版本。
问题是,每个候选 Harness 都要完整运行一次 Agent。候选越多,执行和两两比较的成本越高。对于本来就很耗时的代码或研究任务,这种搜索很难频繁使用。
RHI 做了一个很激进的简化:
不维护一群候选方案,当前版本只和它的上一个版本比较。
完整过程可以拆成五步:
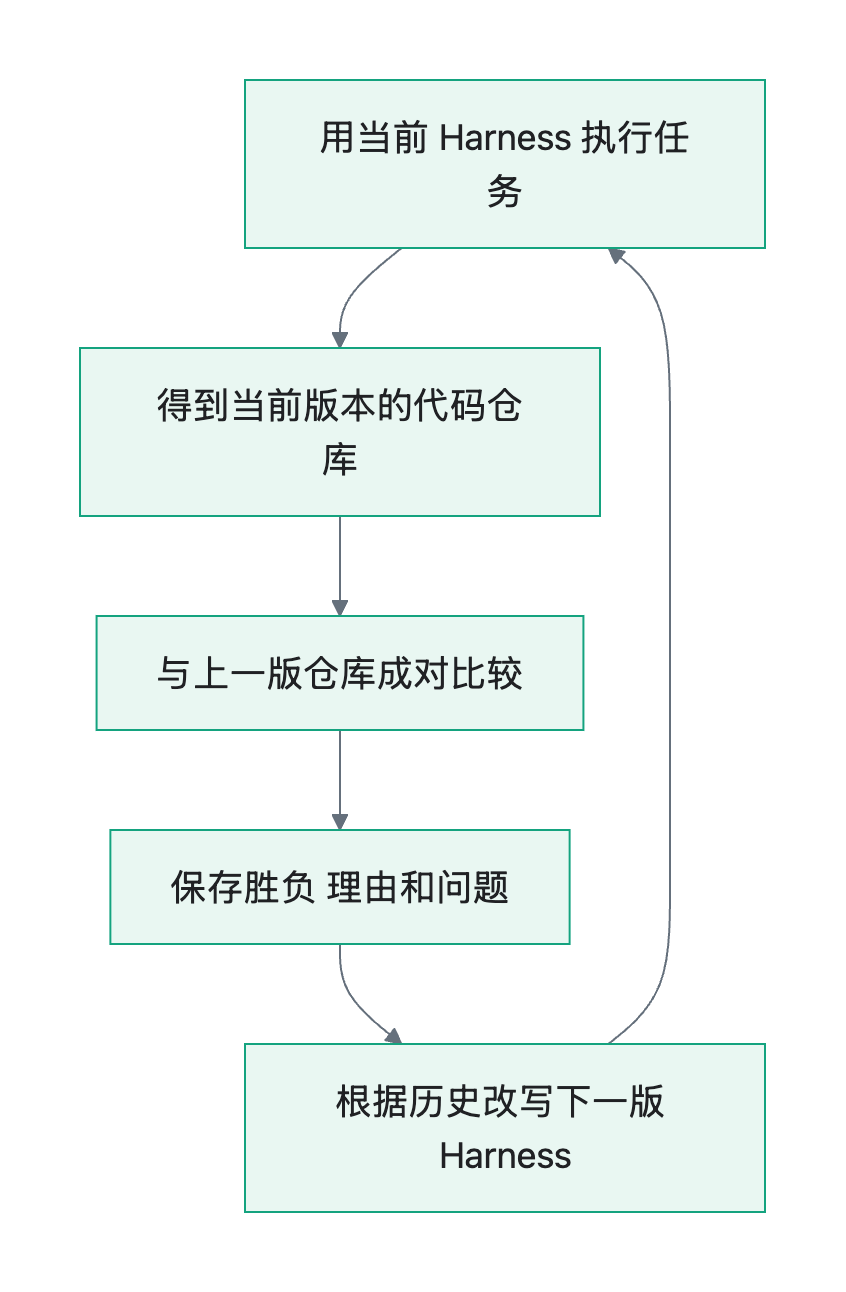
上一个版本的仓库已经存在,所以每轮只需要新增一次任务执行和一次成对评审。
这种方法更像局部爬山:它不保证找到所有可能方案里的最好一个,只判断眼前这一步是否比上一步好。
单次评审可能出错,因此 RHI 不会只看最新一次胜负。它会保存整个版本历史,包括每轮谁更好、评审理由是什么、哪些问题反复出现。Harness 优化器根据这段历史生成下一版。
论文把历史带来的作用称为一种“语义动量”。它不是数学上的梯度,更接近我们做项目复盘时维护的问题清单:新一轮既要修复最新缺陷,也不能把以前已经解决的问题重新引入。
四、RHI 修改的不是一句 Prompt,而是一套多 Agent 协议
为了让 Harness 可以被语言模型直接修改,作者没有把它表示成复杂代码,而是写成一份结构化文本。
这份 Harness 主要包含四类信息:
- Role:有哪些 Agent,各自扮演什么角色;
- Instruction:每个 Agent 负责完成什么;
- Contract:子 Agent 必须以什么内容和格式向协调者交付;
- Hop:协调者何时派发、回收、复查和再次委派任务。
前两项决定“谁做什么”,后两项决定“信息怎样流动”。
RHI 的优化器被明确要求优先调整后两项,也就是通信契约和多轮交互步骤。
论文附录给出的一个真实优化记录,很适合说明为什么。
在一次量化研究任务中,评审器发现当前仓库存在这些问题:
- 报告把 GBM 写成主模型,但
metrics.json记录的主模型是 ElasticNet; - 报告说某个结果“统计显著”,对应的
p值却是 0.122; - 任务要求比较 2020 年前后的稳定性,但相关字段为空;
- JSON 中出现了不标准的
NaN; - 某些特征可能使用了预测时不应该知道的未来信息。
如果只是增加一句“请保证报告准确”,下一轮仍可能发生同类问题。
RHI 的做法是把失败转成更具体的协作要求,例如:
- 指标 Agent 必须声明哪份 JSON 是数字事实源;
- 报告 Agent 的每个量化结论必须指向对应字段;
- 独立审查 Agent 检查报告与指标文件是否一致;
- 稳定性数据缺失或 JSON 非法时,不允许进入最终报告阶段;
- 发现潜在数据泄漏后,重新召回数据和评测 Agent 处理。
这里最关键的变化,不是多创造了一个听起来厉害的专家,而是让每个 Agent 的输出变成下游可以检查的交付物。
比如,测试 Agent 如果只返回“测试通过”,协调者仍然不知道它测了什么。一个更有用的 Contract 应该要求它返回:
执行的命令
退出状态
覆盖的场景
未覆盖的场景
日志文件路径
是否允许进入下一阶段
当这些字段稳定下来,协调者不必重复读取所有对话,也能判断任务接下来该继续、停止还是返工。
五、作者如何验证 RHI
论文准备了 30 个开放式机器学习研究任务,覆盖三个领域:
- 量化金融 10 个;
- 机器人 10 个;
- 制药机器学习 10 个。
这些任务由 LLM 根据相关岗位的招聘描述生成。每个任务都要求 Agent 创建完整代码仓库,通常包括研究报告、代码、图表、结构化指标和文件清单。
这不是普通问答。一个结果要同时满足:代码能运行、实验设计合理、数字前后一致、文件齐全、报告清楚。
由于很难用单一分数评价整个仓库,论文采用 LLM-as-a-judge:让评审模型成对比较两个仓库,主要检查六件事:
- 交付物是否齐全;
- 实验和数字是否严谨;
- 是否能够复现;
- 报告是否清楚;
- 工程结构是否合理;
- 有没有偏离任务要求。
作者使用不同模型作为评审器,并以多个随机种子重复评测,尽量降低单一 Judge 的偏好。
被测试的基础模型是 Sonnet 4.6、Opus 4.7 和 Opus 4.8。
RHI 一侧使用 high 推理档位,加上逐轮改进的任务专用 Harness;对照侧使用同系列的 xhigh、max 或 ultracode,但不使用 RHI 生成的 Harness。
因此主实验实际在比较两种扩展路线:
路线 A:让同一个模型普遍投入更多推理计算
路线 B:保持较低推理档位,针对任务优化外部工作流
六、论文最重要的三个实验结果
1. 少量 RHI 迭代,确实抬高了同系列模型的表现
在 Sonnet 4.6 上,经过两轮 RHI,high + H[2] 在 30 个任务中有 20 个结果胜过 max 基线。
在 Opus 4.7 上,一轮 RHI 后,high + H[1] 超过了 xhigh 和 max。
在 Opus 4.8 上,两轮 RHI 后,high + H[2] 超过了论文评测的 xhigh、max 和 ultracode 基线。
ultracode 本身已经带有可以动态创建子 Agent 的系统级工作流。任务专用 Harness 仍然取得优势,说明“支持多 Agent”与“多 Agent 被正确组织”不是一回事。
不过,这个结论有严格范围:它成立于论文的 30 个任务、模型版本和评审方法,不是所有 Agent 任务的普遍定律。
2. 提升不只是因为输出变长
一个自然的怀疑是:RHI 会不会只是让 Agent 生成了更多 Token,所以结果更好?
在 Sonnet 4.6 和 Opus 4.8 上,RHI 各轮的输出 Token 大致保持稳定,但结果继续改善。这说明在这两个模型上,“写得更多”不能完整解释提升。
Opus 4.7 的证据没有这么干净:它从初始 Harness 到第一轮 RHI 时,输出 Token 与性能同时上升。论文也明确说,这组实验无法把两种解释分开。
因此准确的结论不是“RHI 与 Token 无关”,而是:三个模型中有两个支持性能提升主要来自工作流变化,而不是输出长度增加。
3. 最终执行阶段的缓存读写和成本下降
在论文报告的三组关键对比中:
- Sonnet 4.6 的 RHI 版本相比
max,成本低 7%,缓存读写低 33%; - Opus 4.7 的 RHI 版本相比
max,成本低 18%,缓存读写低 37%; - Opus 4.8 的 RHI 版本相比
ultracode,成本低 60%,缓存读写低 64%。
作者把它归因于更有效的上下文管理。
如果每个子 Agent 都接收完整历史,系统会反复传递大量无关内容。任务专用 Contract 则像一份精简交接单,只把下游真正需要的结论、证据和未决问题传下去。
这里可以借用论文自己的类比:这有点像给 Agent 之间的信息流增加“稀疏连接”。它不是数学上真的实现了稀疏注意力,而是同样避免所有节点读取全部信息。
七、RHI 到底学会了什么
为了理解 Harness 在几轮迭代里发生了什么,作者把 Role、Instruction、Contract 和 Hop 分别转成文本向量,观察它们如何变化。
结果最明显的是 Contract:不同任务的通信契约逐渐表现出更清晰的任务差异,而且相邻版本的 Contract 很快趋于稳定。
Role 的区分反而不明显。原因并不难理解:这 30 个机器学习任务普遍都需要数据处理、模型训练、评测和报告写作,高层角色本来就很相似。真正随任务变化的,是每个角色具体要交什么数据、用什么格式交、下游怎样验收。
作者进一步提出一个信息论假说:RHI 似乎在同时做两件事。
- 让 Contract 和 Hop 包含更多当前任务需要的信息;
- 减少 Role、Instruction、Contract 和 Hop 之间的重复,让它们各自承担不同功能。
用更直白的话说:
该放进交接单的信息,逐渐放进交接单;
不需要每个角色都重复一遍的内容,逐渐被删掉。
论文用嵌入向量上的互信息和总相关性指标,为这个解释提供了相关性证据。
但作者也很谨慎:这些指标只能观察 Harness 文本在语义上怎样变化,看不到黑盒模型内部究竟怎样使用它们。因此,这部分是一个可检验的机制假说,不是已经证明的因果结论。
八、60% 成本下降,不能理解成整个优化过程便宜了 60%
这是我认为整篇论文最需要单独提醒的地方。
Opus 4.8 上的 60%,比较的是改进后的 high + H[2] 与 ultracode 在最终执行一次任务时的成本。
但为了找到 H[2],系统已经运行过初始版本和第一版,做过成对评审,也调用过 Harness 优化器。
论文证明的是:
- RHI 每轮搜索只需要一个新执行结果和一次新旧比较;
- 得到改进后的 Harness 后,单次运行可以更便宜。
它没有证明把所有历史搜索费用加起来,仍然一定节省 60%。
这会直接影响实际决策。
如果一个 Harness 将被反复用于相似任务,早期搜索成本可以被多次执行摊薄。比如每天都运行的代码审查、报告生成或数据处理 Agent,就可能值得优化。
如果任务只执行一次,那么先跑几轮 RHI 再交付,未必比直接提高推理档位更省。
九、这篇论文还没有证明什么
除了成本口径,还有几个边界不能省略。
RHI 不能替代更强模型
作者用经过 RHI 的 Sonnet 4.6 对比更强的 Opus 4.7。Sonnet 的结果明显改善,但没有稳定追平 Opus。
Harness 能让模型更好地发挥已有能力,却不会凭空创造基础模型没有的能力。
任务是合成的
30 个任务由 LLM 根据招聘信息生成,不是真实软件团队长期积累的需求,也没有覆盖大型旧代码库、线上故障和多人协作中的全部复杂性。
评审仍然依赖 LLM
评审器只读取任务要求的主要交付物;文件过长时还会截断。它没有完整运行每个仓库,因此可能错过隐藏的运行错误,也可能受到表达方式影响。
相邻版本比较会混入随机性
每轮只生成一个新仓库。新版获胜,既可能来自 Harness 变好,也可能因为模型这次随机生成得更好。
多个 Judge 和随机种子提高了最终评测的稳健性,但生产系统仍应对重要版本重复运行,并加入旧任务回归测试。
它优化的是当前任务
RHI 在同一个任务上不断调整任务专用 Harness。论文没有充分证明,在任务 A 上得到的 Harness 可以直接迁移到任务 B。
这既是它快速生效的来源,也是过拟合风险所在。
十、对 Agent 开发真正有用的启发
如果暂时不考虑自动优化算法,这篇论文仍然给出了几条很实用的判断。
多 Agent 的问题,常常先出在交接,而不是角色数量
“再增加一个专家”很容易,“让这个专家交出下游能验证的结果”更重要。
设计子 Agent 时,除了 Role 和 Instruction,至少还应该明确:
- 输出字段;
- 证据文件;
- 未完成事项;
- 验证命令;
- 触发返工的条件。
评估 Harness,要比较交付物
Prompt 变长、流程变复杂,并不代表系统更好。
应该比较真实结果:功能是否正确、文件是否齐全、结论能否找到证据、旧任务有没有退化,以及总费用是否仍在预算内。
优化记录要能保留过去的教训
如果每次只根据最新一次失败修改,Harness 很容易来回摇摆。
版本记录至少应保留:新版相对旧版的胜负、评审理由、必须保留的优点、重复问题和下一轮验证方法。
先算清楚 Harness 会复用多少次
真实总成本应该写成:
总成本 = 寻找 Harness 的成本 + 后续重复执行成本
高频、结构相似、结果可比较的任务,更适合做 Harness 优化。一次性任务、目标持续变化或难以评估的任务,则要谨慎。
结语
RHI 最吸引人的地方,不是它让低推理档位赢过了几个高推理档位,而是它把 Agent 性能问题从“模型够不够强”扩展到了“计算是否被正确组织”。
过去我们经常把 Harness 当成模型外面的一层固定工程代码。论文则把它变成了一个可以运行、比较、记录失败并继续修改的对象。
在这套方法里,真正快速变化的不是那些听起来专业的角色名称,而是 Agent 之间的通信契约和返工路径。
这与日常软件工程的经验其实很接近:一个团队交付不稳定,原因未必是成员能力不够,也可能是输入含糊、交接缺证据、验收没有事实源、失败后没人负责回收。
当然,论文还没有完成模型与 Harness 的完整共进化,也没有证明结果能够普遍迁移到真实生产任务。
但它已经把一个值得重视的方向说得很清楚:
当 Agent 继续增加思考成本却没有明显变好时,下一步不一定是换模型,也可能是重新设计信息怎样流过整个工作流。
这或许才是 RHI 对普通开发者最重要的启发。
参考资料
- Hyunin Lee, Jinglue Xu, Jeffrey Seely, Donghyun Lee, Matei Zaharia, Yujin Tang:Recursive Harness Self-Improvement
https://arxiv.org/abs/2607.15524 - Yoonho Lee et al.:Meta-Harness: End-to-End Optimization of Model Harnesses
https://arxiv.org/abs/2603.28052 - Hangfan Zhang et al.:Self-Harness: Harnesses That Improve Themselves
https://arxiv.org/abs/2606.09498 - Chengrun Yang et al.:Large Language Models as Optimizers
https://arxiv.org/abs/2309.03409 - Lakshya A. Agrawal et al.:GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning
https://arxiv.org/abs/2507.19457