从 GPT-2 到 Kimi K3:一篇长文讲透大模型架构到底进化了什么
这篇刷屏长文最有价值的,不是再讲一遍“大模型参数变多了”,而是把过去几年真正推动大模型向前的三条主线串了起来:序列长度、模型深度,以及稀疏 MoE 的系统化落地。
文章目录
- 导语
- 一、先说结论:这篇长文真正讲清的是三条演进主线
- 二、为什么 GPT-2 这一代架构会先撞上“序列长度”的墙
- 1. 注意力计算会随着序列增长变贵
- 2. KV Cache 会变成推理阶段的重要瓶颈
- 三、线性注意力的核心,不是“更便宜”,而是“把历史改写成状态”
- 四、DeltaNet 为什么重要:它开始让“有限状态”具备可编辑能力
- 1. 问题已经不再只是“能不能做线性注意力”
- 2. Gating 是线性记忆真正变实用的关键
- 3. KDA 代表的是“混合路线”,不是纯粹宗教式替换
- 五、AttnRes 处理的是另一条轴:不是序列,而是深度
- 六、Kimi K3 真正代表的,不是单一技巧,而是三个方向一起收敛
- 1. 在序列维度上,用 KDA 解决超长上下文的经济性
- 2. 在深度维度上,用 AttnRes 解决信息稀释
- 3. 在宽度维度上,用 Stable LatentMoE 把超大规模稀疏模型真正做稳
- 七、这篇 X 长文对开发者最有价值的启发是什么
- 1. 不要再把“大模型升级”理解成单纯参数竞赛
- 2. Agent 时代会更偏爱“长链路经济性”更好的架构
- 3. 未来的大模型架构,会越来越像“问题分轴治理”
- 结语
- 参考资料
导语
最近 X 上有一篇很火的长文,标题叫 《22580: From GPT2 to Kimi3, Explained》。
它为什么能刷屏,不只是因为它把 GPT-2 和 Kimi K3 摆在了一起,也不只是因为“2.8T 参数约等于 22580 个 GPT-2”这个数字很夸张。
更重要的是,这篇文章把一个经常被误解的问题讲清楚了:
今天的大模型,真的只是把 Transformer 一路堆大吗?
我的结论是:
不是。 从 GPT-2 到 Kimi K3,参数规模当然很重要,但真正决定上限的,是模型如何处理更长序列、如何在更深网络里保留有效信息,以及如何把超大规模稀疏结构稳定训练和稳定服务起来。
原帖最值得看的地方,不在于它给出了一堆公式,而在于它把这几年的架构演进整理成了一条连续主线:
- GPT-2 代表的是经典 decoder-only Transformer;
- 线性注意力在解决长序列成本问题;
- DeltaNet 在解决线性状态容量与覆盖问题;
- Kimi Linear / KDA 在把这条路线真正推到可用的工程规模;
- AttnRes 和稀疏 MoE,则把问题从“怎么处理更长”扩展到“怎么处理更深、更宽、更像完整系统”。
这篇解读,不是逐段翻译原帖,而是把它拆成更适合开发者理解的三个问题:
- 序列为什么会成为 Transformer 的第一堵墙?
- 线性注意力和 DeltaNet 到底解决了什么,又牺牲了什么?
- Kimi K3 真正代表的,是一种什么样的“大模型系统形态”?
一、先说结论:这篇长文真正讲清的是三条演进主线
很多人看“大模型架构演进”时,会下意识只盯着一个坐标轴:
参数越来越多
但这条 X 长文给出的其实是三条并行主线:

也就是说,Kimi K3 不是“更大的 GPT-2”,而是多个子问题逐步被工程化后的汇合点。
从官方资料来看,Kimi K3 的关键公开信息包括:
- 2.8T 参数;
- 1M token 上下文;
- 基于 Kimi Delta Attention 与 Attention Residuals;
- 稀疏 MoE 中单 token 有效激活 16 / 896 个专家;
- 相比 Kimi K2,整体 scaling efficiency 约提升 2.5 倍。
这些信息本身已经说明,它不是只沿着“把层数、参数、数据继续加大”的老路前进,而是在序列、深度、宽度三个方向一起做结构性改造。
二、为什么 GPT-2 这一代架构会先撞上“序列长度”的墙
如果回到 GPT-2 的经典 Transformer 结构,它的优点非常清楚:
- 训练时并行性强;
- 自注意力表达能力强;
- 用统一的 decoder-only 结构就能做语言建模。
但它也天然带着两个长期矛盾。
1. 注意力计算会随着序列增长变贵
标准 softmax attention 需要让每个 query 去和所有 key 做匹配。训练时,这意味着你往往会显式或隐式承担全局两两关系的代价;推理时,虽然不会每一步都完整重算整张注意力矩阵,但上下文越长,读取和维护历史信息的成本还是会持续上升。
2. KV Cache 会变成推理阶段的重要瓶颈
原帖有一段解释很重要:KV Cache 的出现,本质上是在避免模型每生成一个 token 时,都把前面所有 token 的 key/value 投影重新算一遍。
这确实省掉了大量重复算力,但代价也很直观:
- 历史 token 越多,缓存越大;
- 缓存越大,显存和带宽压力越高;
- 一旦你开始追求超长上下文,瓶颈不只是算力,还会转向内存访问。
所以,GPT-2 时代的 Transformer 虽然奠定了主框架,但当行业开始追求:
- 更长上下文;
- 更长链路 Agent 执行;
- 更复杂的 test-time scaling;
大家很快就会发现,单靠 KV Cache 续命,不足以支撑百万级上下文的经济性。
这也是为什么后面的路线不再只是“怎么把 attention 做得更快”,而是转向另一个问题:
能不能不要把过去所有 token 都逐个保存下来,而是用一个有限状态来压缩历史?
三、线性注意力的核心,不是“更便宜”,而是“把历史改写成状态”
这一步是很多人第一次看会看懵的地方。
标准 attention 的心智模型是:
我保留很多历史键值对
当前 query 来时,再去所有历史里查找最相关的信息
线性注意力想做的事情,是把这个过程改写成:
历史信息不再以完整 KV 列表保存
而是逐步折叠进一个有限大小的状态里
从工程视角看,它真正想解决的是:
- 状态大小不要再随序列长度线性膨胀;
- 每次解码时,不要越来越依赖大规模历史缓存读写;
- 长序列推理要更接近固定状态更新,而不是无限扩容的历史回放。
这就是原帖为什么会不断强调“有限状态”。
但这里有一个经常被忽略的 trade-off:
你把历史压缩成有限状态,当然更省;可一旦压缩,就意味着你未必还能像 softmax attention 一样,精确地把某个历史 token 单独、锐利地捞出来。
也就是说,线性注意力解决的是扩展性问题,同时也引入了记忆容量与检索精度问题。
四、DeltaNet 为什么重要:它开始让“有限状态”具备可编辑能力
线性注意力最直白的问题是:
如果状态只是不断累加,
那旧信息会不会越来越混?
新信息要怎么覆盖旧信息?
这正是 DeltaNet 这条路线的价值。
2021 年那篇著名论文 《Linear Transformers Are Secretly Fast Weight Programmers》 已经指出,线性化 attention 可以被理解成一种 fast weight memory,而且纯加法式写入会遭遇容量限制与相互干扰问题。它提出了带有 delta rule 风格的更新方式,让模型不只是“继续往里加”,而是尝试“读取当前已有内容,再决定应该补什么、改什么、替换什么”。
原帖里对这件事的解释,我觉得可以翻成一句更好懂的话:
DeltaNet 的关键,不是让线性注意力更抽象,而是让有限状态从“只会追加的记事板”变成“可以局部改写的记忆板”。
下图来自原帖,展示了从并行化 DeltaNet 到 Gated Delta Networks,再到 Kimi Linear 中 KDA 的连续演进:
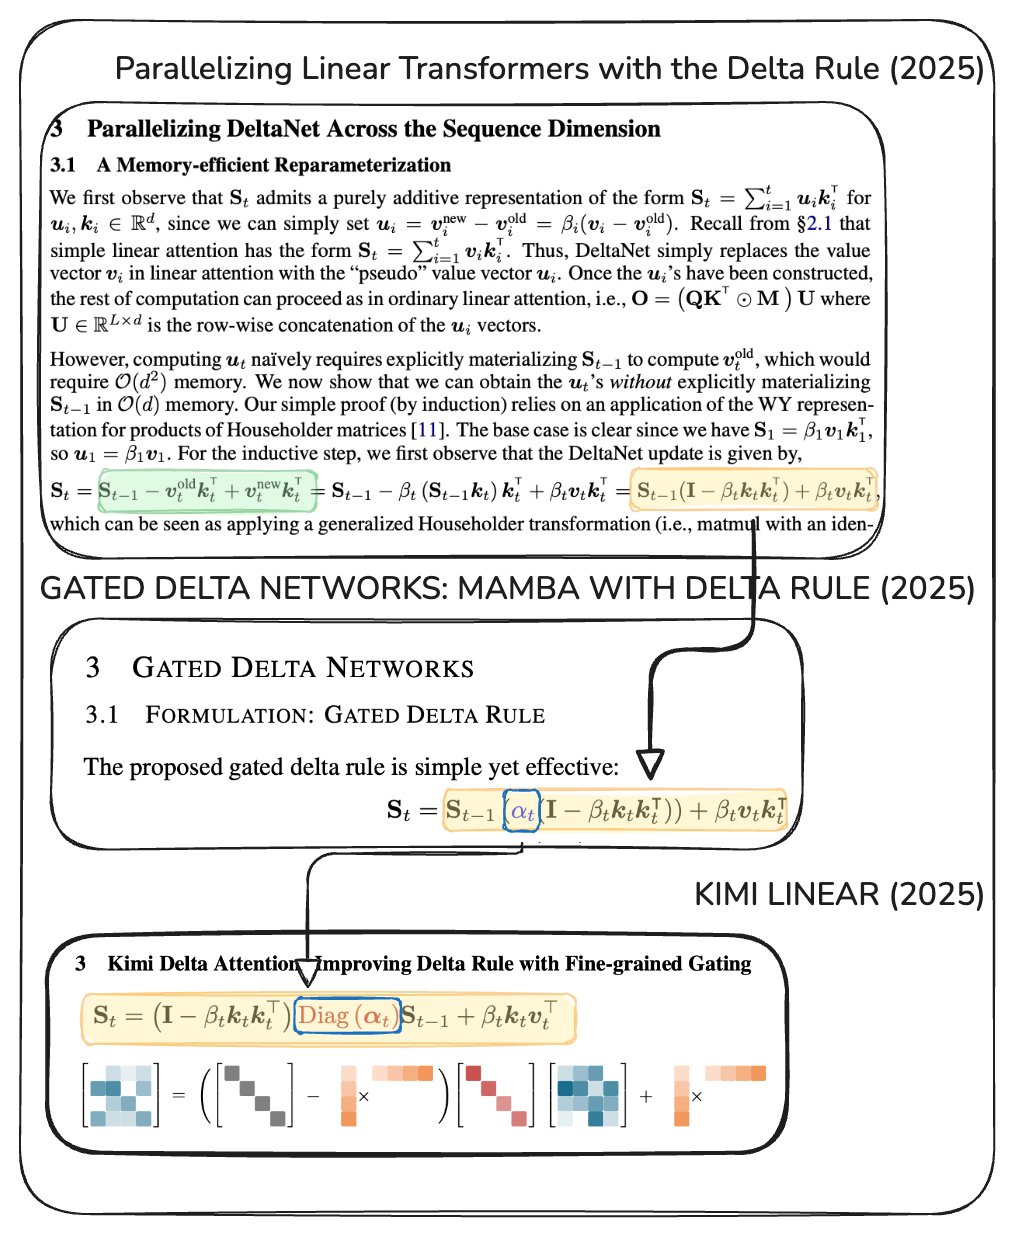
这条演进链至少说明了三件事。
1. 问题已经不再只是“能不能做线性注意力”
而是:
- 能不能保留足够表达能力;
- 能不能稳定训练;
- 能不能在现代硬件上高效并行;
- 能不能和更大的模型骨架共存。
2. Gating 是线性记忆真正变实用的关键
如果状态只有统一的遗忘或统一的累加,它就太粗糙了。更细粒度的 gating,让不同通道、不同信息有机会以不同速度保留或衰减,这是线性状态从“理论上能跑”走向“实际更好用”的关键步骤。
3. KDA 代表的是“混合路线”,不是纯粹宗教式替换
官方的 Kimi Linear 技术报告讲得很明确:它不是简单宣布“softmax attention 过时了”,而是采用混合架构,把 KDA 和全局注意力结合起来,在公平对比下争取更好的性能与效率平衡。
这一点很重要,因为很多架构争论最后都会落回现实:
不是谁在理论上最优,
而是谁能在真实训练和真实推理里更稳、更快、还不掉质。
五、AttnRes 处理的是另一条轴:不是序列,而是深度
很多讨论长上下文的人,容易只盯 sequence 维度,但原帖后半段把另一件事也点出来了:
模型变深之后,问题不只是“算得动算不动”,还有“前面层的信息还能不能以合适方式传上来”。
传统 residual connection 的好处大家都知道,它给梯度开了高速公路。但从信息聚合角度看,标准残差还有一个隐患:
- 所有历史层输出都被固定权重地一路相加;
- 随着层数加深,隐藏状态幅度会持续累积;
- 更早层的重要信息,可能被越来越多后续层“淹没”。
Moonshot 在 2026 年提出的 Attention Residuals,就是在处理这个问题。
官方论文给出的思路很直白:
把“前面层全部等权相加”
改成“当前层按内容相关性去选择前面哪些层的信息”
这件事很像把 sequence 维度上“固定累积”向“注意力选择”升级的过程,再沿着 depth 维度重做一遍。
原帖中的简图很适合帮助理解这一点:
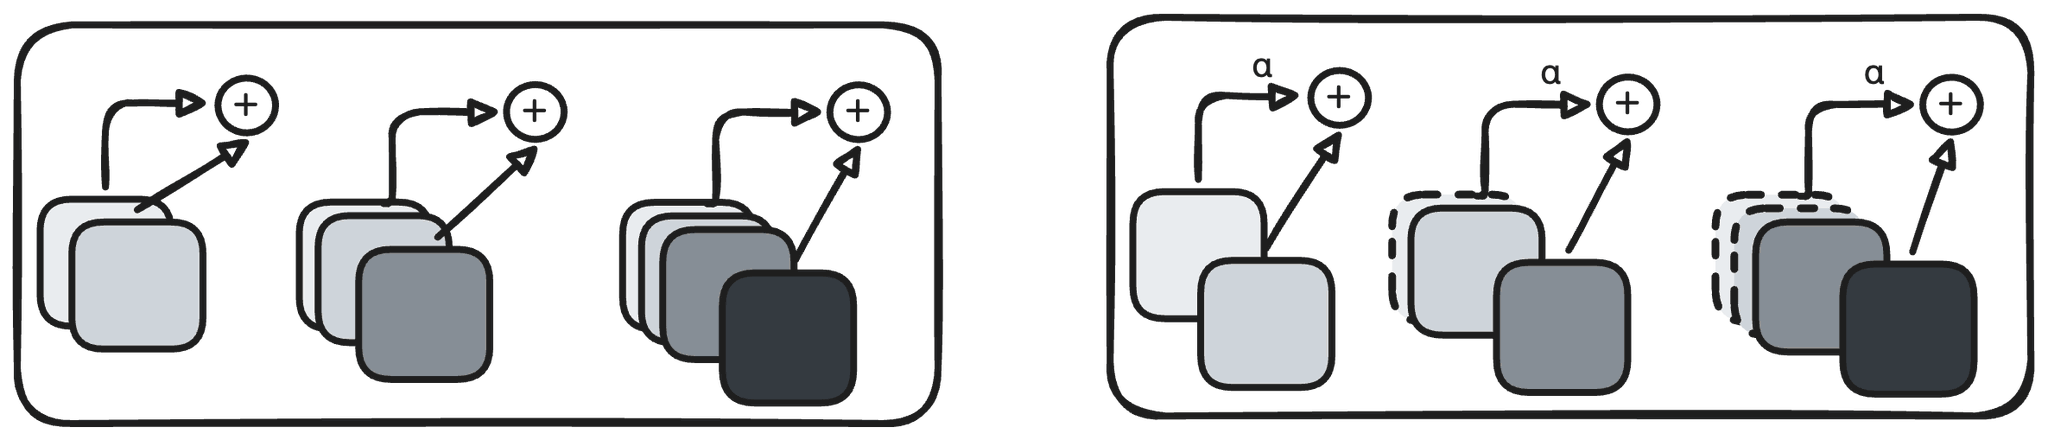
左边更接近传统残差的直觉:一路加上去。
右边更接近 AttnRes 的直觉:虽然仍然沿着深度传递,但每一层会更有选择地决定该从前面拿什么。
这背后其实是一个很重要的架构视角变化:
过去:残差主要被当作训练稳定器
现在:残差本身也被重新设计成信息选择机制
所以从 GPT-2 到 Kimi K3,改变的不只是 attention,本质上连“层与层之间怎么传信息”也在被重写。
六、Kimi K3 真正代表的,不是单一技巧,而是三个方向一起收敛
如果把前面的内容合在一起看,Kimi K3 的意义就不只是“Moonshot 出了一个更大的开源模型”,而是它把三条路线同时收拢到一个系统里:
1. 在序列维度上,用 KDA 解决超长上下文的经济性
这条线回答的是:
历史越来越长时,
模型还能不能继续推理,而不是被 KV Cache 拖死?
2. 在深度维度上,用 AttnRes 解决信息稀释
这条线回答的是:
模型越来越深时,
早期层和中间层的信息还能不能被有效取用?
3. 在宽度维度上,用 Stable LatentMoE 把超大规模稀疏模型真正做稳
Kimi K3 官方资料披露,单 token 有效激活 16 / 896 个专家。这说明它不是简单把所有参数都 dense 地全量运行,而是通过稀疏专家路由控制计算成本。
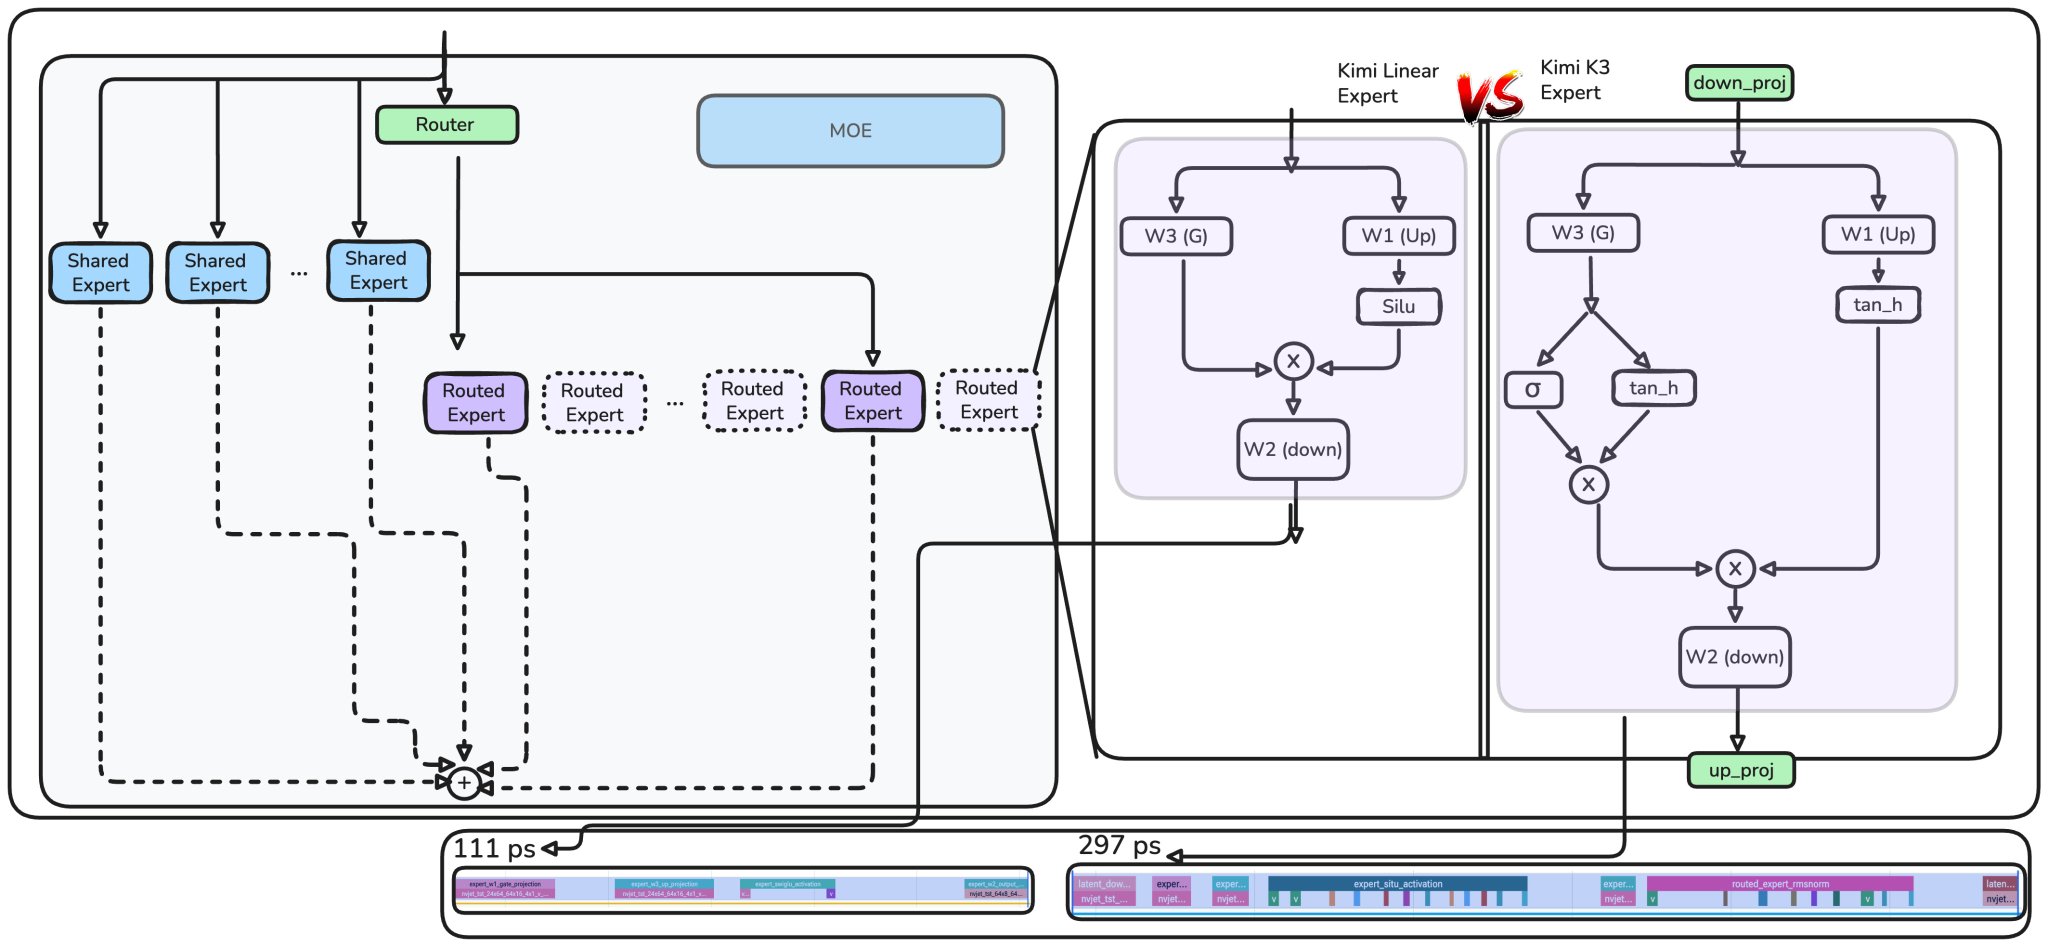
而原帖封面图恰好也对应了这一点:从 Kimi Linear Expert 到 Kimi K3 Expert,专家结构和激活函数设计都在变,说明架构优化已经深入到 MoE 专家本身。
这意味着,Kimi K3 更像下面这样的组合体:
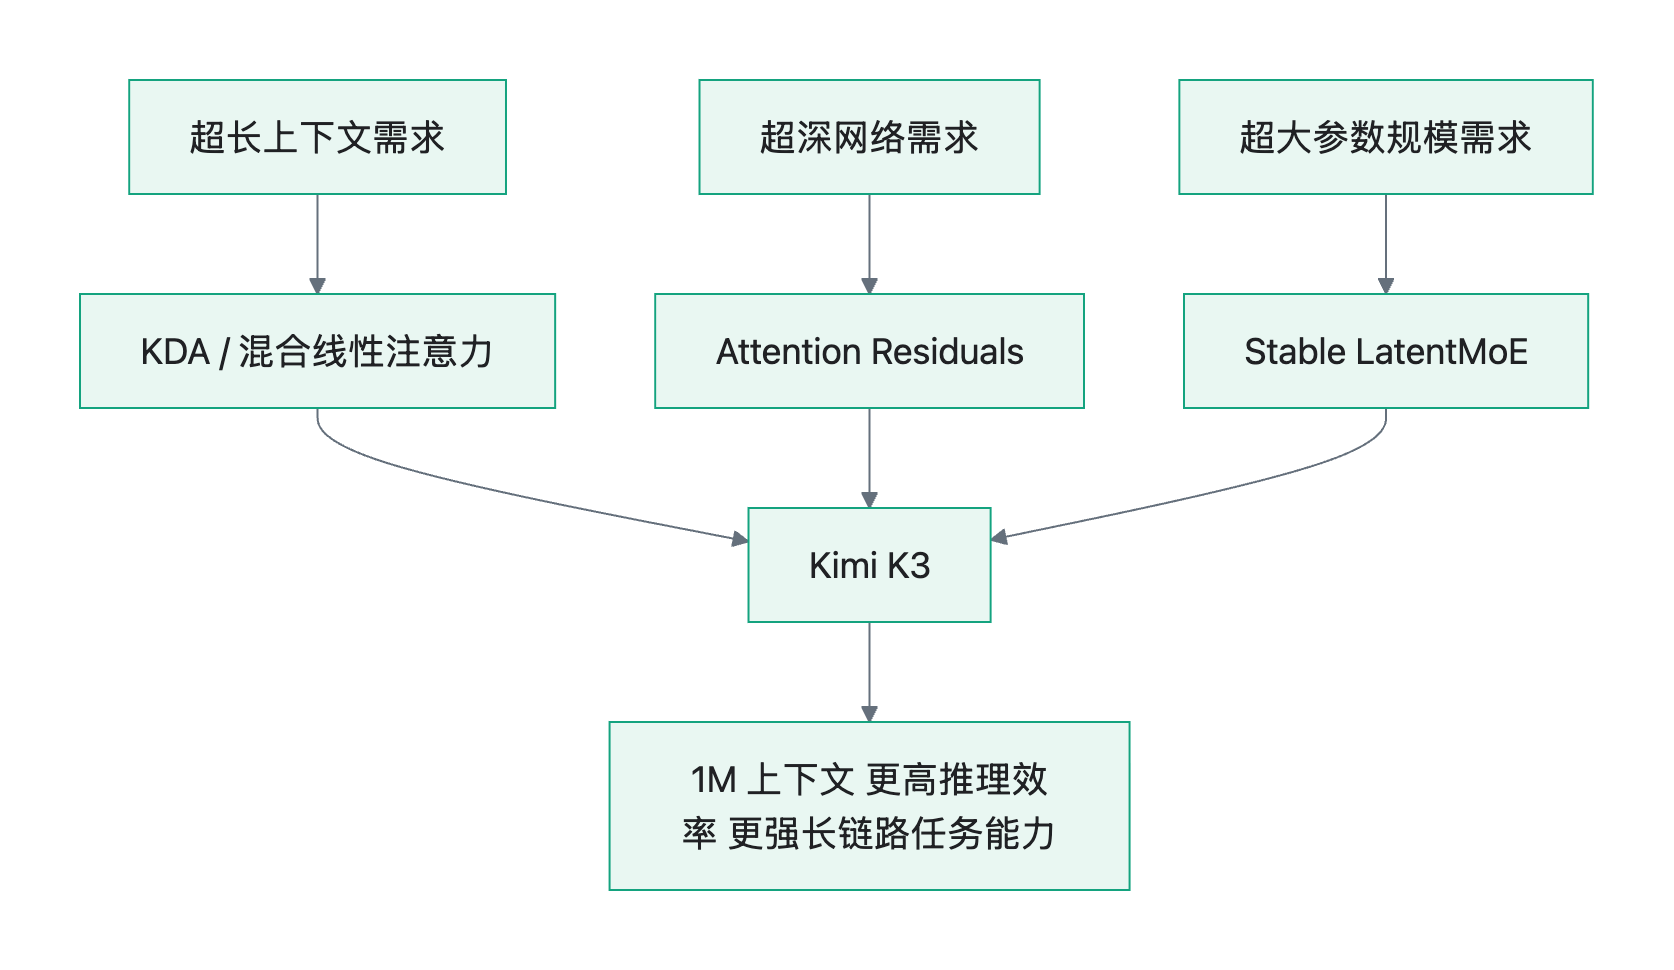
所以,K3 的价值不是单点技巧,而是:
它在尝试回答一个越来越现实的问题: 当模型既要长、又要深、还要宽时,架构到底该怎么协同演化,而不是在某一个维度上单独暴力堆料。
七、这篇 X 长文对开发者最有价值的启发是什么
我觉得有三点。
1. 不要再把“大模型升级”理解成单纯参数竞赛
今天模型的竞争,已经不再只是“谁参数更大”。很多时候,真正决定体验的,是:
- 长上下文推理是否还能保持吞吐;
- 复杂多步任务中状态是否容易退化;
- 深层网络里信息是否被稀释;
- 稀疏 MoE 是否足够稳定;
- 推理系统是否能把这些结构吃下来。
如果只盯参数量,很容易错过真正决定产品可用性的变量。
2. Agent 时代会更偏爱“长链路经济性”更好的架构
Kimi Linear 论文里反复强调长上下文和 RL / agentic intelligence 场景,这不是偶然。
Agent 与普通单轮问答最大的差别之一,就是:
它会持续读上下文
持续调用工具
持续生成中间状态
持续把历史带到下一步
这会让上下文长度、缓存压力和推理吞吐变得比以前更重要。
所以这条从线性注意力到 KDA 的路线,本质上是在服务一种新的工作负载,而不只是做论文指标。
3. 未来的大模型架构,会越来越像“问题分轴治理”
原帖最让我认同的一点,是它没有把所有进步都归结为某个神奇模块。
更合理的理解方式是:
- 序列长度问题,用更好的记忆与状态更新机制处理;
- 深度问题,用更好的层间选择机制处理;
- 稀疏宽模型问题,用更好的路由与训练稳定性处理;
- 系统问题,再由 serving、缓存和 kernel 一起兜底。
这其实也是工程世界最常见的进化方式:不是一个技巧解决一切,而是把一个大问题拆成多个轴,再逐个修正。
结语
回到最开始那个问题:
从 GPT-2 到 Kimi K3,真的只是 scale up 吗?
答案当然包含 scale up,但远远不止 scale up。
这篇 X 长文真正值得看的地方,在于它把过去几年大模型架构演进中最关键的变化串起来了:
- 序列不再只靠越来越大的 KV Cache 硬扛;
- 深度不再默认靠固定残差一路累加;
- 稀疏大模型也不再只是“多加专家”这么简单。
换句话说,今天的大模型已经不只是一个“更大的 Transformer”,而是在 Transformer 主骨架上,逐步长出了:
- 更高效的状态机制;
- 更聪明的深度选择;
- 更可扩展的稀疏结构;
- 更贴近真实工作负载的系统设计。
如果你关心的不只是“哪个模型榜单更高”,而是:
为什么这些模型开始能处理更长的任务、
更复杂的代码工作流、
更像 Agent 的执行链路,
那这条从 GPT-2 到 Kimi K3 的主线,确实值得认真看一遍。
参考资料
- ali:22580: From GPT2 to Kimi3, Explained
https://x.com/waterloo_intern/status/2081762065392541951?s=46 - Kimi Team:Kimi K3: Open Frontier Intelligence
https://www.kimi.com/blog/kimi-k3 - Kimi Team:Kimi Linear: An Expressive, Efficient Attention Architecture
https://arxiv.org/abs/2510.26692 - Kimi Team:Attention Residuals
https://arxiv.org/abs/2603.15031 - Imanol Schlag, Kazuki Irie, Jürgen Schmidhuber:Linear Transformers Are Secretly Fast Weight Programmers
https://arxiv.org/abs/2102.11174