Code Agent:一个代码任务是怎样跑起来的
用一个真实的小项目,拆开 Code Agent 的组成,并走完从理解任务、定位代码到修改、测试和交付的完整运行过程。
Code Agent 不是“会写代码的聊天机器人”,而是一套能反复读取项目、调用工具并检查结果的运行系统。
模型负责判断下一步,Runtime 负责执行,Workspace 提供代码和命令环境,AgentRun 则记录任务走到了哪里。四者不断交换信息,直到任务完成、失败或需要用户决定。
这一篇先看完整运行过程。后面的 Sandbox、Artifact 和 Shell Runtime,都是在这套结构上继续展开。
下面仍用一个很小的任务贯穿全文:修复 slugify,让连续空格只生成一个连字符。
一个 Code Agent 由什么组成
先看最小结构:
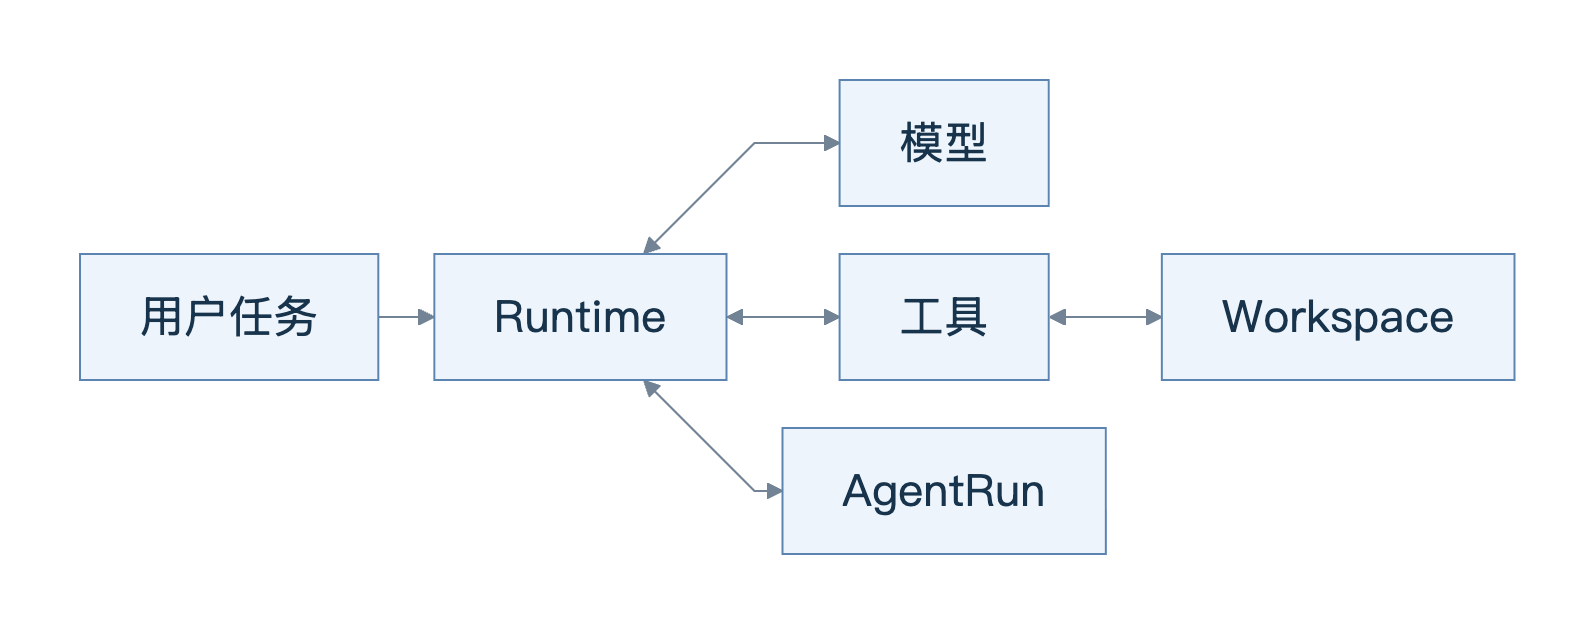
这几个部分各有一件明确的事:
- 模型读取当前上下文,决定下一步是搜索、读文件、改代码、跑命令,还是结束任务。
- Runtime组织循环、校验工具请求,并把执行结果送回模型。
- 工具把模型的意图变成可执行操作,例如 Search、Read、Edit 和 Command。
- Workspace是这次任务实际面对的项目。它可以是当前目录、Git worktree,也可以是云端隔离环境。
- AgentRun保存任务、步骤、工具结果和当前状态,避免一次长任务只靠聊天记录维持。
模型本身不会碰文件。它只能请求工具,真正的读写和命令都由 Runtime 执行。
一次任务怎样开始
用户给出任务后,Runtime 先创建一次 AgentRun,并确定它在哪个 Workspace 中工作。
这个案例可以写成:
任务:修复连续空格生成多个连字符的问题
工作区:当前项目
允许修改:src/slugify.js
验证命令:npm test

完成条件:
- npm test 退出码为 0
- 最终只有 src/slugify.js 发生变化
这些信息不是长提示词,而是运行边界。没有“验证命令”和“完成条件”,模型即使改出一段看似正确的代码,也不知道什么时候才算做完。
任务开始前,Runtime 还会读取工作区的初始状态。例如项目原本就有未提交修改,后面检查 Diff 时就不能把它们算到 Agent 头上。
核心是一个“观察—行动”循环
Code Agent 不是一次生成完整答案,而是每获得一个新结果,再决定下一步。
它的核心循环可以简化成:
while (run.status === "running") {
  const context = buildContext(run);
  const response = await model.next(context, toolSchemas);

  if (!response.toolCall) {
    run.output = response.text;
    run.status = "completed";
    break;
  }

  const result = await runtime.execute(response.toolCall);
  run.record(response.toolCall, result);
}
模型请求工具时,Runtime 执行工具,并把结果放进下一轮上下文;模型返回最终答复时,Runtime 保存答复、结束循环,并把这次 AgentRun 记为 completed。
如果工具需要用户确认,Runtime 会把状态改成 waiting_for_user;如果命令失败,失败信息也会成为下一轮观察,而不是被藏起来。
用 slugify 跑完一轮
现在把这套循环放进真实案例。
第一步,Agent 查看 package.json,知道测试命令是 npm test。随后搜索 slugify,读到源码和测试:
export function slugify(input) {
  return input
    .trim()
    .toLowerCase()
    .replace(/[^a-z0-9 ]/g, "")
    .replace(/ /g, "-");
}
assert.equal(slugify("Code Agent"), "code-agent");
assert.equal(slugify("Code   Agent"), "code-agent");
第二步,Agent 运行测试。普通标题通过,连续空格用例失败,实际值是 code---agent。
有了这个结果,模型才进入下一轮判断:/ /g 每次只匹配一个空格,应该改成 / +/g,让一段连续空格只替换一次。
第三步,Edit 工具修改这一行。Runtime 返回真实 Diff,模型因此知道改动是否已经落盘、落在哪个文件。
第四步,Agent 再次运行 npm test。两项测试都通过后,它继续读取最终 Diff,确认没有改到其他文件。
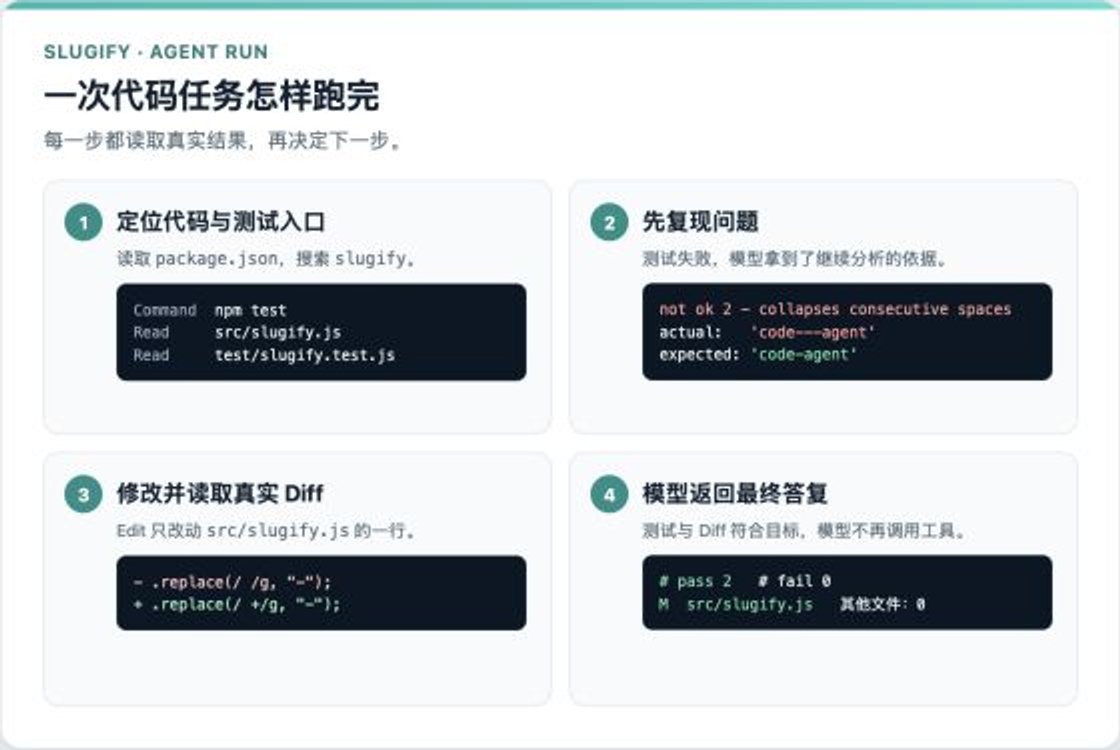
这就是一次完整的 Code Agent 运行:每一步都由上一步的真实结果触发,而不是模型先编好一条固定流程。
四类工具怎样配合
这个案例只需要四类工具:
- Search 找到
slugify在哪里定义、在哪里被测试。 - Read 读取源码、测试和
package.json的必要片段。 - Edit 修改文件,并返回实际 Diff。
- Command 运行
npm test、git status等项目命令,并返回退出码和输出。
工具描述要告诉模型“怎样请求”,Runtime 则按预先写好的规则处理请求。例如模型可以请求读取某个路径,Runtime 会检查它是否属于 Workspace;模型也可以请求运行命令,规则的匹配结果会决定直接执行、请求确认还是拒绝。
所以,提示词里的“不许改其他文件”只是一项要求;Runtime 检查每次 Edit 的目标路径,才是真正的限制。
模型什么时候结束循环
第二次测试和最终 Diff 都会作为 Tool Result 回到模型。模型看到两项结果符合任务要求,便返回最终答复,不再请求工具。
对 slugify 来说,证据只有两项:
npm test:退出码 0,2 项测试全部通过
最终 Diff:只修改 src/slugify.js 的 1 行
Runtime 不需要理解测试内容。它收到最终答复后结束循环,并把 AgentRun 记为 completed。如果工具等待确认,它会暂停循环;如果达到步骤、时间或费用上限,它会按对应原因停止。
这里的 completed 表示“这次运行正常结束”,不保证代码一定正确。测试可能漏掉边界情况,模型也可能误读结果。
到这里,一个 Code Agent 的主干已经完整了:Runtime 驱动循环,模型选择动作,工具操作 Workspace,AgentRun 保存过程;模型决定何时回答,Runtime 记录循环怎样结束。
不过,Command 工具执行 npm test 时,会启动一个系统进程。这个进程可能读取项目外的文件、访问网络,或者拿到环境中的凭证。怎样限制这些风险,是下一篇 Workspace 与 Sandbox 要解决的事。
参考资料
- OpenAI Docs — Agent approvals & security:
https://learn.chatgpt.com/codex/agent-approvals-security - OpenAI Docs — Sandbox:
https://learn.chatgpt.com/codex/sandboxing - OpenAI Docs — Worktrees:
https://learn.chatgpt.com/codex/environments/git-worktrees - Claude Code Docs — How Claude Code works:
https://code.claude.com/docs/en/how-claude-code-works - GitHub Docs — About cloud and local sandboxes for GitHub Copilot:
https://docs.github.com/en/copilot/concepts/about-cloud-and-local-sandboxes - Cursor Docs — Background Agents:
https://docs.cursor.com/background-agent - Git — git-diff Documentation:
https://git-scm.com/docs/git-diff - Node.js — Test Runner Documentation:
https://nodejs.org/api/test.html