Agent 可观测性:如何知道 Agent 为什么跑偏?
只记录最终答案无法解释 Agent。本文把一次任务还原成可关联的 Trace、Span、事件和业务结果,让跑偏位置能够被发现和复现。
文章目录
- 导语
- 一、日志、指标和 Trace 各自解决什么
- 日志:某个时刻发生了什么
- 指标:大量运行整体表现如何
- Trace:一次任务走过的完整路径
- 二、先用 Trace、Span、事件把路径连起来
- 三、一次任务应记录什么
- 模型调用
- 工具调用
- 控制与状态变化
- 最终结果
- 四、不要记录模型隐藏推理来代替证据
- 五、怎样从 Trace 找到第一次跑偏
- 六、给 Span 和事件设计稳定而安全的结构
- 七、两条落地路径:先把证据采对,再选择界面
- 路径 A:自己实现最小可观测性
- 路径 B:接入成熟平台
- 怎么选
- 八、前端与后端分别怎样使用这些数据
- 给用户看的运行时间线
- 给工程师看的调试视图
- 后端告警与分析
- 九、可观测性不等于评测
- 十、费曼式复述:一次“重复发送”怎么查
- 十一、常见误区
- 十二、本篇总结
- 参考资料
导语
一个邮件 Agent 收到“把周报发给项目组”,最后真的发了两封。用户只看到一句“发送成功”,工程师却需要判断:模型提了两次发送,负责调度模型和工具的运行时程序(Runtime)在超时后重试,还是邮件服务第一次已成功但回执丢了?
这三种原因的修法完全不同。只保存用户问题和最终答案,无法回答它。
同一个错误答案,原因可能完全不同:
- 模型误解了目标;
- 上下文缺少关键约束;
- 模型选错工具或传错参数;
- 工具返回被截断;
- 用户拒绝了关键动作,Agent 却没有改道;
- 外部系统成功执行,但回执在网络中丢失;
- 最终总结没有忠实反映前面的证据。
只保存用户问题和最终答案,就像只看一次 HTTP 请求的状态码来排查整套分布式系统。
Agent 可观测性的目标,是让工程师能够回答:一次任务经过了什么路径,第一次偏差出现在哪里,真实世界最终发生了什么?
一、日志、指标和 Trace 各自解决什么
日志:某个时刻发生了什么
{
  "event": "tool_call_finished",
  "traceId": "trace_123",
  "spanId": "span_search_01",
  "tool": "search_documents",
  "durationMs": 842,
  "status": "success"
}
结构化日志适合检索具体事件和错误。只有一句 tool failed 的纯文本日志,很难聚合,也缺少关联信息。
指标:大量运行整体表现如何
例如:
- 任务成功率和人工接管率;
- 工具错误率、超时率;
- 模型请求次数、Token 用量和成本;
- 端到端延迟及各阶段分位数;
- 循环步数、重试次数和批准等待时长。
指标适合发现“从昨天开始工具超时率升高”,却通常不能单独解释某一次任务为什么失败。
Trace:一次任务走过的完整路径
Trace 把一次任务关联起来,Span 表示其中一个有开始和结束的操作,例如一次模型请求、工具调用、策略判断或人工批准等待。
名称因框架而异,但关系可以这样理解:
Trace:完成用户的一次任务
├── Span:组装模型上下文
├── Span:模型请求
├── Span:工具调用
│   └── Event:返回结果被截断
├── Span:人工批准等待
└── Span:模型生成最终回答
日志、指标和 Trace 不是三选一。Trace 帮你还原单次路径,指标帮你发现群体异常,日志补充离散细节。
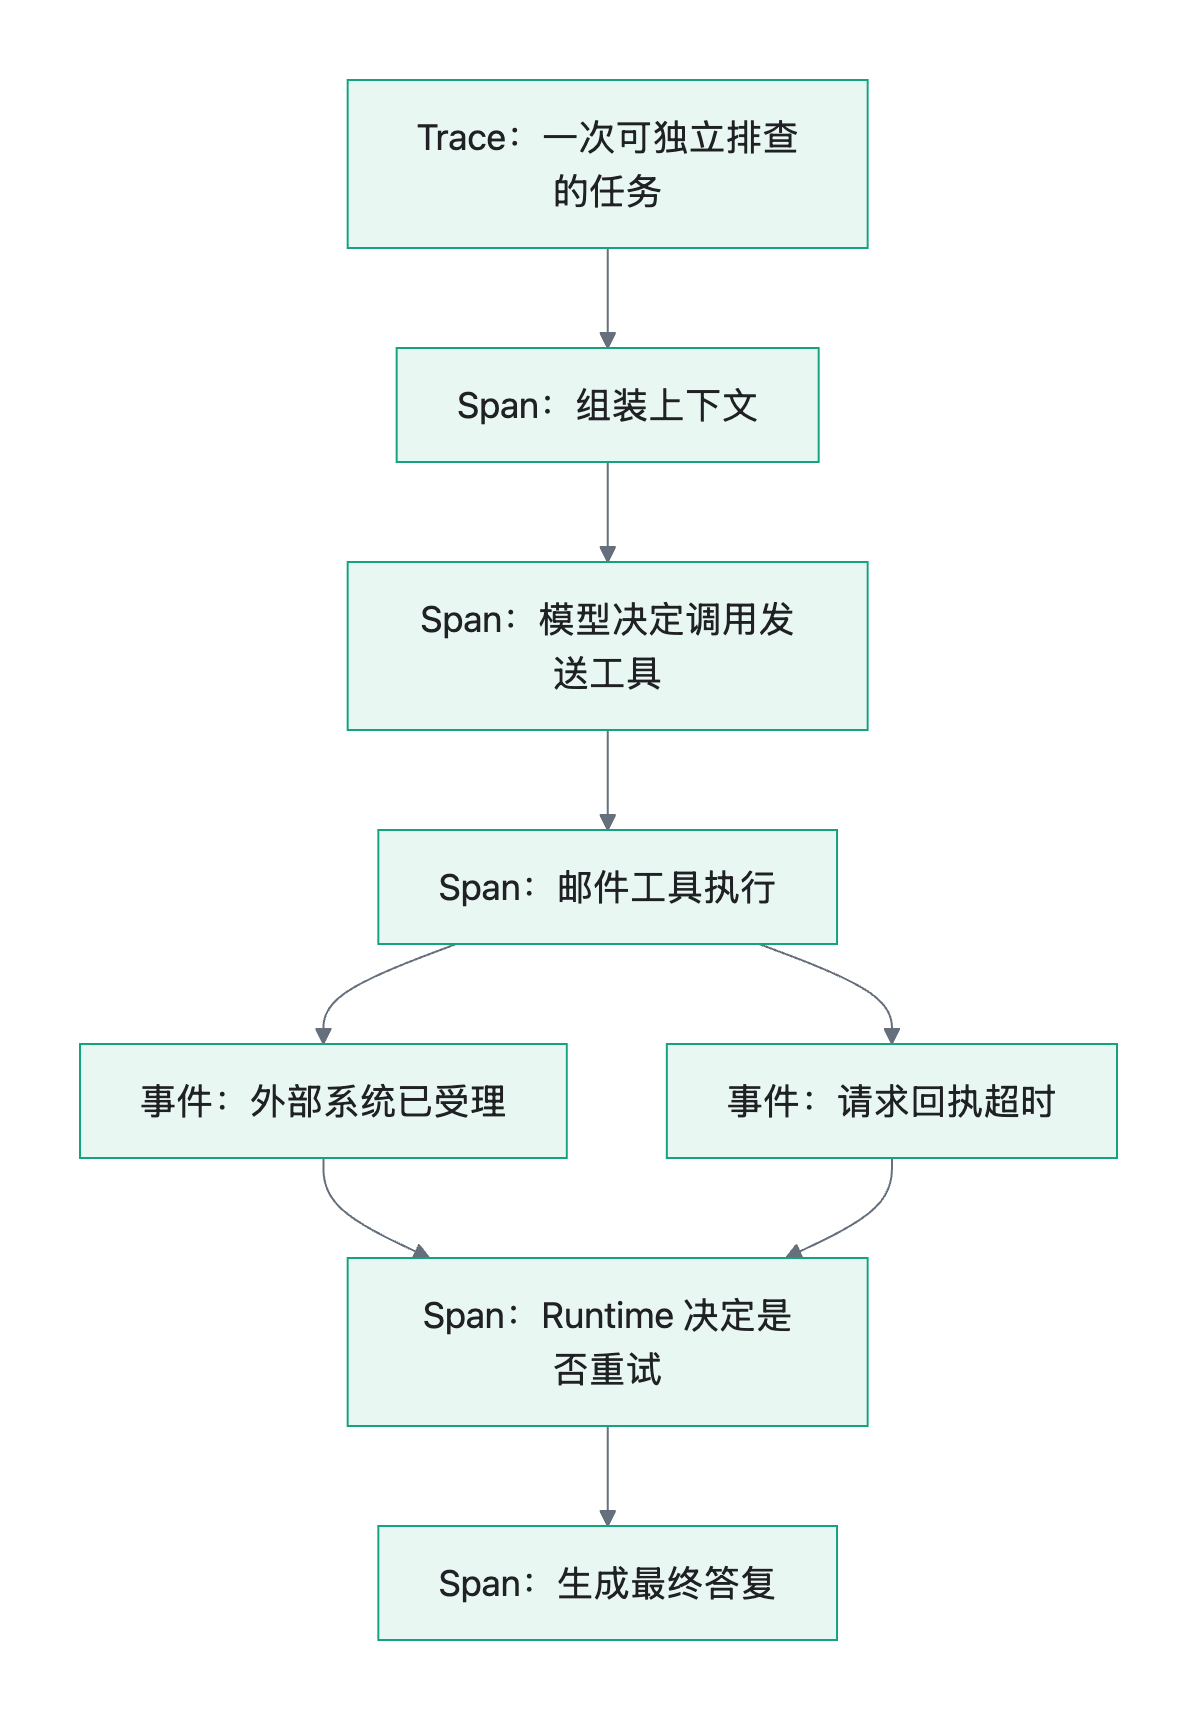
下面这张图是本文采用的朴素模型。它不要求你的数据库或平台使用同一套名称,只要求父子关系和关键事件能被还原。
二、先用 Trace、Span、事件把路径连起来
先不管平台怎样命名,可以把一次执行想成一张任务单:
- Trace 是整张任务单,覆盖从接收请求到得出结果的全过程;
- Span 是任务单中的一段工作,有开始和结束,例如一次模型请求或一次邮件发送;
- 事件(Event) 是某个瞬间发生的事实,例如“邮件服务已受理”或“等待回执超时”。事件通常挂在当时正在执行的 Span 下。
为了把这些记录重新拼成一条路径,需要的追踪标识并不多:同一任务中的记录共享一个 traceId;每个 Span 有自己的 spanId;如果一个 Span 是在另一个 Span 内发生的,它再用 parentSpanId 指向直接上级。比如“邮件工具执行”是“处理发信任务”的子操作,那么前者的 parentSpanId 就等于后者的 spanId。沿着这个指向逐层往上查,界面才能画出 Span 树。
事件不需要再参与父子排队。它用自己的 eventId 保证记录可唯一识别,再用 spanId 表明“这件事发生在哪段工作里”即可。
另一类 ID 来自业务系统,目的完全不同:
- 工具调用 ID 配对一次工具请求和对应结果;
- 审批 ID 找到用户对哪项操作作了决定;
- 外部请求 ID 对照邮件服务或支付服务的记录;
- 幂等键表示“这些重复请求其实是同一个业务动作”,让外部系统避免重复写入;
- 用户、租户或会话 ID 帮助按业务对象检索和隔离数据。
这些业务 ID 应保留为 Span 或事件的属性,因为排查时确实要用到;但它们不负责描述 Trace 的父子结构,也不能代替 traceId 或 spanId。
run、turn、step 则要看具体框架。有的平台把一次模型或工具操作叫 Run,有的把一轮对话叫 Turn,有的用 Step 表示工作流节点。若所用框架已经生成这些 ID,可以保留并注明它对应本文模型中的哪一层;如果只是为了还原执行路径,就不必同时新造 runId、turnId 和 stepId。名称越多并不会让链路更清楚。
对队列和异步任务,还要把 traceId、当前 spanId 以及必要的业务 ID 写进消息元数据。消费端读取这些值后创建子 Span,跨进程的前后两段工作才不会变成两条互不相干的记录。
三、一次任务应记录什么
可观测事件应支持重建过程,而不是无差别保存所有内部数据。
模型调用
建议记录:
- 模型和版本标识、关键推理参数;
- 输入上下文各部分的来源和长度;
- 输出类型:最终回答、工具调用或其他控制信号;
- Token 用量、延迟、错误与重试;
- Prompt、工具集合和上下文构建器的版本。
是否保存完整输入输出要根据隐私和合规决定。很多系统只保留脱敏内容、摘要、哈希或受控采样。
工具调用
建议记录工具名、参数的安全表示、开始和结束时间、结果状态、错误码、是否截断、重试次数、外部请求 ID 和幂等键。
“工具返回成功”还不够。例如查询接口可能成功返回空数组,这是合法空结果,也可能是过滤条件传错。状态和业务结果要分开。
控制与状态变化
计划创建和修改、权限决策、任务暂停恢复、人工批准拒绝、取消和超限,都应成为一等事件。
最终结果
记录最终状态、完成条件、引用证据、产物位置和未完成项。否则你只知道 Agent 说“完成了”,不知道系统如何验证。
四、不要记录模型隐藏推理来代替证据
排查 Agent 不等于要求保存或展示模型的私密思维过程。
工程上真正需要的是可验证的运行证据:
- 给模型的可见输入;
- 模型产生的结构化动作;
- 工具参数与工具结果;
- 策略决定及其规则码;
- 状态转换和最终输出;
- 应用代码确定的完成检查。
如果产品需要向用户解释,可以生成简洁的决策摘要,例如“搜索结果缺少发布日期,因此又查询了文档元数据”。这段摘要描述可观察事实,不应伪装成模型内部逐字思考。
五、怎样从 Trace 找到第一次跑偏
假设一个文档问答 Agent 给出了过期政策。
不要从最终答案开始凭感觉改 Prompt。沿 Trace 倒查:
- 最终答案引用了哪条证据?
- 证据里是否已经是旧版本?
- 检索结果是否包含新版本但排序靠后?
- 查询词是否遗漏了产品和地区?
- 上下文构建时是否丢掉了用户所在地区?
- 输入本身是否含糊,而系统没有询问?
找到第一个使正确路径不再可能的步骤,才得到可行动的故障分类。
错误答案
不是一个根因类别

它可能来自:输入理解 / 上下文 / 规划 / 工具选择 / 工具执行 / 观察处理 / 最终表达
修复也会因此不同:检索召回问题要改数据与查询,参数错误要改 Schema 或工具描述,结果截断要改 Tool Result,不能统统归因于“模型不够聪明”。
六、给 Span 和事件设计稳定而安全的结构
type AgentSpan = {
  traceId: string;
  spanId: string;
  parentSpanId?: string;
  name: string;
  startedAt: string;
  endedAt?: string;
  status?: "ok" | "error";
  attributes: Record<string, string | number | boolean>;
};

type AgentEvent = {
  eventId: string;
  traceId: string;
  spanId: string;
  type: string;
  occurredAt: string;
  attributes: Record<string, string | number | boolean>;
};
这里特意拆成两种记录。Span 有持续时间,所以保存开始、结束和状态;事件只描述一个时间点。parentSpanId 只属于 Span,用来画父子树;事件通过 spanId 挂到对应 Span。两者都保存 traceId,这样即使数据分开存储,也能查回同一次任务。
工具调用 ID、审批 ID、租户 ID、外部请求 ID 和幂等键等业务标识放进 attributes,只在确实需要关联对应对象时记录。若平台原生要求 runId、turnId 或 stepId,应记录清楚映射关系;若没有这项要求,不要为了让 Schema 看起来完整而重复制造标识。
实际事件还要考虑:
- Schema 版本,避免升级后旧数据无法读取;
- 枚举值稳定,便于查询和告警;
- 大字段放到受控对象存储,只在事件里留引用;
- 密钥、Cookie、身份证号等在采集前就清除;
- 租户隔离、访问控制、保存期限与删除策略;
- 采样不能遗漏所有失败或高风险任务。
可观测平台本身也可能成为数据泄露入口。OpenAI Agents SDK 等框架提供 Trace 与 Span 能力,同时也提供是否包含敏感输入输出的配置;接入任何框架时,都要核对其默认行为,而不是假设“日志天然安全”。
七、两条落地路径:先把证据采对,再选择界面
路径 A:自己实现最小可观测性
适合已有日志平台、合规要求特殊,或第一版只需排查少量核心流程的团队。
第一步不是做仪表盘,而是在 Agent Runtime 中放一个统一的 Tracer 接口:启动 Trace、开启/结束 Span、记录事件。模型适配层、工具适配层、权限检查和人工审批都调用它。
最小产物包括:稳定的 Span 树、脱敏后的关键输入输出、业务结果、版本与耗时。数据先写入结构化日志或 OpenTelemetry Collector,再接入已有存储和查询系统。
常见失败是每个模块各记一套 JSON,或只记录“调用成功”却不记录空结果、截断和幂等键。验证时用“重复发送”故障演练:人为制造第一次请求成功但回执超时,确认一个 Trace 能区分模型重复、Runtime 重试与外部幂等问题。
路径 B:接入成熟平台
适合需要快速获得 Trace 树、筛选、成本统计、数据集和评测联动的团队。
Langfuse 把一次任务记录为 Trace,Trace 内的各段工作统称为 Observation,其中可包含 Span、模型生成(Generation)和 Event 等类型;Session 用来把多次相关 Trace 归到一起。
LangSmith 使用另一套叫法:一次具体操作叫 Run,多个有父子关系的 Run 组成一条 Trace;多轮相关 Trace 还可以归入一个 Thread。换成本文的朴素模型,LangSmith 的 Run 更接近一个 Span,而不是整次任务。
因此接入平台时,先画出自己的“任务—操作—瞬时事实”三层关系,再映射到产品字段。不要仅凭名字相似,就把 Run、Trace、Turn、Step 当成同一层或互相复制 ID。
先选一条真实失败接入,不要一开始全量采集。确认模型调用、工具调用、检索和最终答复能正确嵌套,再添加版本、租户、环境和结果标签。随后检查平台默认采集了哪些输入输出、保存多久、如何删除和脱敏。
成熟平台也不能替你定义“任务是否真的完成”。如果 Trace 树漂亮,却没有外部写入回执、权限决定或完成检查,故障仍然无法定位。
怎么选
| 情况 | 更适合起步 |
|---|---|
| 已有 OpenTelemetry 与日志平台,数据不能外发 | 自建最小采集层 |
| 希望本周就能检索 Trace、看成本并连接 Eval | Langfuse / LangSmith 等平台 |
| 多语言、多服务且要避免厂商锁定 | 以 OpenTelemetry 为底,再接可视化平台 |
| 核心问题仍是“到底该记录什么” | 先自建一条故障演练,不急着选平台 |
八、前端与后端分别怎样使用这些数据
给用户看的运行时间线
用户通常需要:正在做什么、完成了什么、为什么暂停、哪些动作失败、最终产物在哪里。
不要把原始模型请求和海量日志直接倒进界面。可用简明事件构成时间线,并允许展开工具参数、引用和错误详情。
给工程师看的调试视图
工程师需要查看 Span 树、上下文来源、工具输入输出、重试链、模型与 Prompt 版本、成本,以及与相似失败的聚合关系。
后端告警与分析
可从事件派生告警:
- 单次任务超过最大操作次数;
- 相同工具连续失败;
- 人工批准等待超时;
- 成本或延迟突增;
- Agent 声称完成但没有完成证据。
不是每个异常都要呼叫值班人员。告警要结合用户影响和持续时间,避免噪声。
九、可观测性不等于评测
Trace 能告诉你 Agent 做了什么,却不会自动回答“做得好不好”。
一次运行调用了三次工具、耗时八秒,这是事实;这三次调用是否必要、答案是否正确,需要评价标准。
因此二者形成前后关系:
可观测性提供可检查的执行证据
→ Eval 用标准给证据和结果打分
→ 失败样本回到 Trace 定位原因
没有 Trace,Eval 失败后难以诊断;没有 Eval,海量 Trace 只能证明系统很忙。
十、费曼式复述:一次“重复发送”怎么查
用户收到两封相同邮件。请按证据排查:
- 用产品中的任务链接或业务 ID 找到完整 Trace;
- 检查模型是否提出了两次发送调用;
- 若只提出一次,检查工具 Span 是否因超时重试;
- 查看两次外部请求是否使用同一幂等键;
- 对照 Tool Result,确认第一次是否实际成功但回执丢失;
- 将根因归类为决策重复、Runtime 重试或外部服务幂等缺失。
如果只能看到最终答案“邮件已发送”,这个问题几乎无法可靠定位。
本文简化了存储和厂商实现。你可以使用 OpenTelemetry、框架自带 tracing 或自建事件系统;名称可以不同,但端到端关联、关键输入输出、隐私控制和结果证据不能缺失。
十一、常见误区
- 只记录异常,不记录成功路径,导致无法比较;
- 把自然语言日志当稳定事件 Schema;
- Trace 没有关联异步队列和外部请求;
- 默认保存完整 Prompt、工具结果和密钥;
- 只看 Token 和延迟,不看任务是否完成;
- 出现坏答案就直接修改 Prompt,没有定位首次偏差;
- 给用户展示底层噪声,却隐藏真正的动作和影响。
十二、本篇总结
Agent 可观测性的最低目标,是让一次运行可重建、可关联、可解释、可审计。
你需要同时看到:
- Trace 中发生了哪些模型、工具和控制步骤;
- 每一步的输入来源、结果状态、耗时和成本;
- 用户批准、拒绝和接管怎样改变了路径;
- 最终完成结论有什么证据;
- 敏感数据如何在采集前被保护。
有了执行证据,下一步才是用稳定标准判断新版本是否真的更好。
下一篇:Agent Eval:如何判断你的 Agent 真的变好了?
参考资料
- OpenAI Agents SDK:Tracing https://openai.github.io/openai-agents-js/guides/tracing/
- OpenTelemetry:Traces https://opentelemetry.io/docs/concepts/signals/traces/
- OpenTelemetry:Generative AI Semantic Conventions https://github.com/open-telemetry/semantic-conventions-genai/blob/main/docs/gen-ai/README.md
- Langfuse:What does a good trace look like? https://langfuse.com/docs/observability/best-practices
- LangSmith:Observability concepts https://docs.langchain.com/langsmith/observability-concepts