Agent 状态管理:多轮执行时到底要存什么?
从一次“评论已经创建,但响应丢失”的故障出发,理解 Agent 为何要保存步骤、任务状态和恢复位置。
文章目录
导语
前文已经走完一次工具往返:模型产生 Tool Call,Runtime 执行工具,再把 Tool Result 放回消息列表。
如果任务能在几秒钟内结束,把数据暂时放在内存里似乎就够了。真实系统却会遇到一个麻烦的时刻:外部动作已经发生,本地系统还没来得及记下来。
假设用户让 Agent 审查一个 Pull Request。模型生成了审查意见,用户确认发布,Runtime 随后调用 GitHub API 创建评论。
GitHub 已经成功创建评论,但响应在返回途中丢失。紧接着,Worker 重启了。
现在,新 Worker 发现一条“正在发布评论”的操作没有最终结果。它应该直接重发、当作失败,还是先去 GitHub 核对?
- 直接重发,可能出现两条相同评论;
- 当作失败,会漏掉已经发生的外部动作;
- 当作成功,又拿不出评论 ID 和可靠证据。
这一篇就跟着新 Worker 恢复这次任务。每遇到一个解决不了的问题,再引入一块必要状态。
一、重启后的第一步,不是重发
Worker 先读取保存下来的消息,看到模型曾经提出:
assistant: 调用 create_issue_comment
这条消息只能证明模型想发布评论。
它不能证明 Runtime 是否真的发出了请求,也不能证明 GitHub 是否已经创建评论。Tool Call 是一次行动提议,不是行动成功的凭证。
因此,恢复程序此时能确定的只有一件事:消息历史证明模型提出过这次调用。下面两件事仍然未知:
- Runtime 是否真的向 GitHub 发出了请求;
- GitHub 是否已经创建评论。
前一个问题要靠本地执行记录判断;后一个问题不能由本地消息或运行记录直接证明,只能向 GitHub 核对。
为了方便后文讨论,可以把这里涉及的信息分成三类:
- 模型看到的事实:消息历史中记录了哪些用户消息、Tool Call 和 Tool Result;
- Runtime 记录的事实:工具调用是否开始、执行到哪里、是否拿到结果;
- 外部世界的事实:GitHub 上是否真实存在这条评论。
此时本地可能保留了部分 Runtime 事实,例如记录显示调用已经开始,却没有最终结果;但这些记录仍不足以确认 GitHub 上的外部结果:评论究竟有没有发布成功。
如果系统只保存消息,恢复到这里就走不下去了。为了继续判断,它必须在调用 GitHub 前,给“正在发布评论”这件事留下一条执行记录。
二、先保存正在执行的这一步
这条执行记录可以叫 AgentStep。它表示一个有明确开始、结束和结果的执行单元。
在调用 GitHub 之前,Runtime 先保存:
{
  "id": "step_42",
  "type": "tool_call",
  "toolName": "create_issue_comment",
  "status": "running",
  "callId": "call_7f2",
  "safeInput": {
    "issueNumber": 128,
    "bodyRef": "agent_input_42",
    "bodyHash": "sha256:..."
  },
  "operationKey": "run_18:step_42",
  "attempt": 1
}
这里不急着保存所有字段。先看恢复程序真正需要的几个信息:
callId说明这一步对应哪次 Tool Call;safeInput保存恢复重试所需、经过脱敏的输入;如果评论正文不宜直接写入 Step,就保存一个可从受控存储中读取正文的安全引用;bodyHash只用于完整性校验或比对,不能单独用来恢复重试;attempt表示这是第几次尝试;operationKey给“发布这条评论”分配一个稳定身份;status说明本地最后确认到哪一步。
正常执行时,Step 会经历:
pending → running → succeeded / failed
但 Worker 重启后,数据库里的 running 并不表示 GitHub 请求仍在执行。它只表示本地没有写下最终结果。恢复程序可以把它视为 outcome_unknown:请求可能成功,也可能没有成功。
这里的 Step 是一条会更新状态的执行记录。如果系统还需要完整审计轨迹,可以另外追加只增不改的 Event,例如 step_started 和 step_succeeded。Step 与 Event 可以关联,但不是同一个概念。
现在,Worker 已经知道“哪一次评论发布没有最终结果”,却仍不知道 GitHub 是否完成了动作。下一步,需要拿稳定的 operationKey 去核对。
三、用 operationKey 判断该核对还是重试
为什么 operationKey 必须在调用 GitHub 前生成并保存?
因为下面这种写法有一道跨不过去的缝隙:
const result = await github.createComment(args)
await saveStepResult(result)
GitHub 和本地数据库是两个独立系统。普通数据库事务无法保证“创建评论”和“保存评论 ID”一起成功。
更稳妥的顺序是:
1. 创建 Step,并生成 operationKey
2. 把 Step 标记为 running,提交本地事务
3. 调用 GitHub 创建评论
4. 保存 comment ID
5. 把 Step 标记为 succeeded
6. 追加 Tool Result
即使故障发生在第 3 步和第 4 步之间,恢复程序也能找到同一个 operationKey。
GitHub 创建普通 Issue 或 PR 评论接口的请求体只定义了评论 body,没有提供通用的幂等键字段。应用可以把 operationKey 作为隐藏标识写入评论正文:
const marker = `<!-- agent-operation:${operationKey} -->`
const body = `${commentText}\n\n${marker}`
GitHub 支持在 Markdown 中隐藏 HTML 注释。用户看到的是正常评论,恢复程序读取原始正文时,则可以搜索这个标识。
整个故障与恢复过程现在变成了一条可以行动的路径:
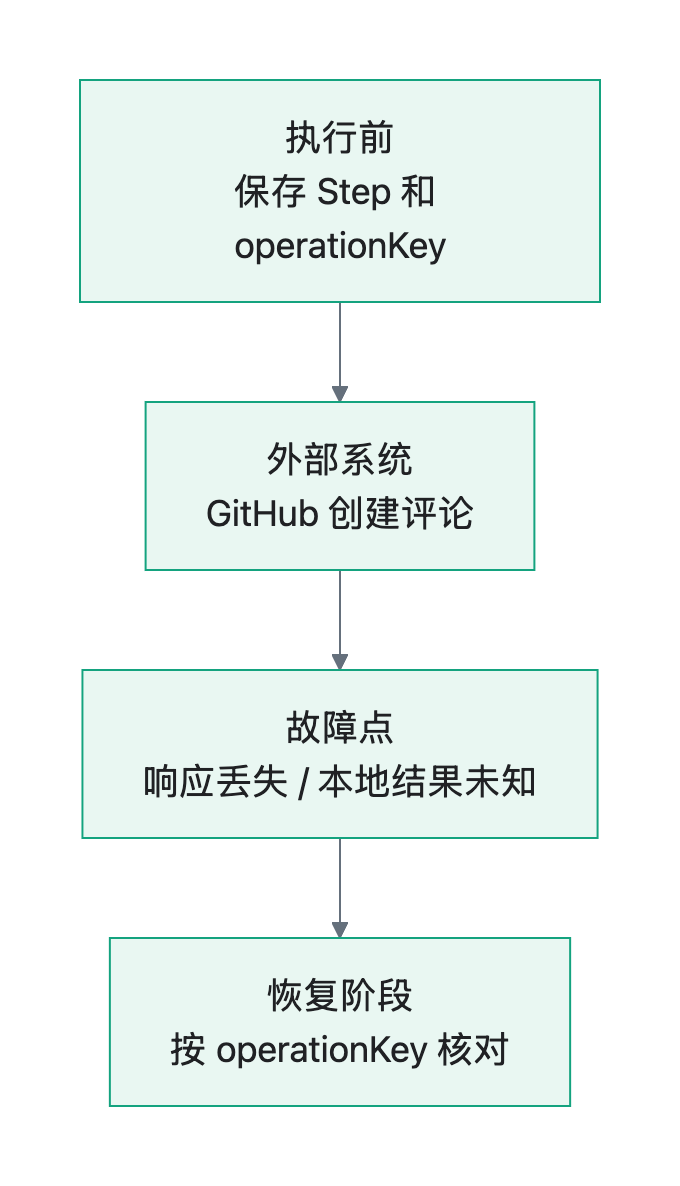
查询后有三种结果。
找到了对应评论
说明外部动作已经完成。Runtime 保存 comment ID,把原 Step 补记为 succeeded,然后追加 Tool Result。不能再次发布。
能确定评论没有创建
Runtime 可以沿用原 Step、原参数和原 operationKey 重试。不要创建一个新 Step,把同一件业务动作伪装成另一件事。
仍然无法确定
例如当前凭证没有读取评论的权限,恢复程序既不能确认成功,也不能确认失败。此时应保持“正在核对”或转人工处理,而不是盲目重放。
“查询不到”也不总能证明“从未发生”。目标系统是否支持幂等键、能否按稳定标识查询,以及查询结果是否足够可靠,都要按具体工具判断。
到这里,发布评论这一步已经可以安全收尾。但一个 Step 恢复成功,不代表整个审查任务已经完成:Runtime 还要把 Tool Result 交回模型,模型可能继续生成最终总结。于是我们需要一条更高层的任务记录。
四、一步恢复了,整个任务还没有结束
课程把一次业务任务的持久化记录称为 AgentRun。
在这个案例里,AgentRun 表示“审查这个 Pull Request 并按确认发布评论”这一整个目标。它不保存评论调用的全部细节,而是回答:任务整体正在做什么。
评论响应丢失后,状态可能这样变化:
running
  → reconciling
  → running
  → completed
running:Agent 正常执行;reconciling:正在核对结果未知的外部动作;- 再次进入
running:评论已经对账,Agent Loop 可以继续; completed:模型生成最终结果,任务结束。
如果只保存 AgentStep,系统能知道评论调用发生了什么,却不容易快速回答整个任务能否继续、是否可以取消、前端应该展示什么。
AgentRun 负责整体状态,AgentStep 负责具体执行单元。恢复程序补记评论成功后,会先推进对应 Step,再决定 AgentRun 下一步进入 running 还是 completed。
现在,正常执行和异常重启已经连起来了。接下来再看另一条分支:如果用户当时根本没有批准发布,系统应该保存什么?
五、用户暂不批准时,保存原动作和恢复位置
假设产品规定:Agent 可以自动生成审查意见,但发布到 GitHub 前必须由用户确认。
模型提出 create_issue_comment 后,Runtime 先停下来:
AgentStep.status = waiting_for_approval
AgentRun.status  = waiting_for_user
这不是失败。系统正在等待一个预期中的外部输入。
为了让用户两小时后仍能继续同一动作,Runtime 要保存一条 Pending Action,包括:
- 它属于哪个 AgentRun 和 AgentStep;
- 准备调用的工具、经过脱敏的参数,以及给用户看的预览;
- 当前是等待、批准、拒绝还是过期;
- 确认有效期和必要的权限信息。
用户点击“同意”后,系统恢复这条 Pending Action,而不是重新让模型生成一次工具调用。重新生成可能改变正文、参数甚至目标对象,那已经不是继续原来的动作。
系统还需要知道 Agent Loop 应从哪里接上。这个可恢复位置就是 Checkpoint。它通常会记录:
conversationRef:后续模型调用需要的消息历史;lastCommittedSequence:最后确认提交的 Step 顺序;runtimeStateRef:具体 Runtime 恢复中断运行所需的状态。
例如 OpenAI Agents SDK 在审批导致运行中断时,会返回 state 和 interruptions。恢复时应继续使用这份状态,而不只是把最后几条消息重新发送给模型。
至此,两条恢复路径都完整了:请求已经发出但结果未知时,用 operationKey 对账;请求还没执行、正在等待批准时,用 Pending Action 和 Checkpoint 继续原动作。
六、走完整个恢复过程后,再汇总最小状态模型
现在再看“到底要存什么”,每一项都有了明确用途。
| 记录 | 在评论案例中解决什么问题 |
|---|---|
| Conversation History | 保存用户消息、Tool Call 和 Tool Result,让模型能够继续判断 |
| AgentStep | 保存评论调用的输入、状态、尝试次数、operationKey 和外部结果 |
| AgentRun | 保存整个审查任务是在运行、等待用户、核对中还是已经结束 |
| Pending Action | 保存尚未获批的原始动作,避免批准后重新生成 |
| Checkpoint | 保存 Agent Loop 可以安全恢复的位置和 Runtime State 引用 |
对应的核心类型可以保持很小:
type AgentRun = {
  id: string
  conversationId: string
  status:
    | 'running'
    | 'waiting_for_user'
    | 'reconciling'
    | 'completed'
    | 'failed'
    | 'cancelled'
  lastCommittedSequence: number
  version: number
}

type AgentStep = {
  id: string
  runId: string
  sequence: number
  type: 'model_call' | 'tool_call' | 'human_approval'
  status:
    | 'pending'
    | 'waiting_for_approval'
    | 'running'
    | 'outcome_unknown'
    | 'succeeded'
    | 'failed'
  callId?: string
  safeInput?: unknown
  safeOutput?: unknown
  operationKey?: string
  externalResourceId?: string
  attempt: number
}
真实项目还会增加用户、租户、时间、错误码和保留策略等字段。第一版不必把所有可能性都塞进表里,先确保它能回答本文故障中的恢复问题。
术语旁注:不要把框架命名直接当成数据库层级
AgentRun 和 AgentStep 是本课程采用的应用数据模型,不是行业统一标准。
OpenAI Agents SDK 把一次 run() 视为一个应用层 Turn,内部可以继续调用模型和工具;Session 用于在多次运行之间维护对话历史。pi 的 AgentSession 也管理消息和生命周期,但它的低层 turn_start、turn_end 更接近一次模型响应及其工具结果批次。
因此,不要把 Session → Thread → Run → Turn → Step 当成所有框架共同遵守的结构,也不要因为字段名相同,就假设它们拥有相同生命周期。
七、第一版跑通后,必须补上的边界
前面的状态已经足以解释和恢复评论故障。进入生产前,再补上三个边界即可,不要让它们抢走主线。
防止两个 Worker 同时推进任务
用户可能在工具运行时点击取消,Webhook 也可能同时写入结果。可以使用版本号做乐观并发控制:
UPDATE agent_runs
SET status = :next_status,
    version = version + 1
WHERE id = :run_id
  AND version = :expected_version;
受影响行数为零,说明其他请求已经更新状态。当前 Worker 必须重新读取,不能用旧状态覆盖新结果。
不要为了排错保存所有原始数据
默认不要持久化 API Key、Cookie、OAuth Token、无限制的模型内部推理、无关的完整 API 响应,以及可以单独引用的大文件。
状态记录的目标是恢复和审计,不是复制所有经过系统的数据。
前端只消费稳定的产品状态
前端可以先读取 AgentRun 快照,再订阅按 sequence 排序的新事件。断线重连后,重复事件按序号去重。
Agent 的总步骤通常事先未知,因此不要伪造精确百分比。展示“正在调用 GitHub”“等待你的确认”“正在核对评论是否已创建”,比一个看似准确的 67% 更可信。
八、用一次故障注入验证第一版
类型定义看起来正确,不代表系统真的能恢复。可以主动制造一次与本文相同的故障:
1. 让测试工具成功创建一条评论
2. 在保存 comment ID 之前主动抛出异常
3. 重启 Worker
4. 恢复同一个 AgentRun
最终应同时满足:
- GitHub 上只有一条评论;
- 恢复程序能通过
operationKey找到它; - 原 AgentStep 保存了 comment ID,并变为
succeeded; - Tool Result 只追加一次;
- AgentRun 能继续执行并最终完成;
- 前端不会把核对阶段误显示为“再次发布中”。
如果系统只能走通正常路径,不能通过这个故障测试,状态模型还没有真正解决恢复问题。
九、这一篇真正要记住的事
只保存聊天记录,最多能让模型继续对话;要让系统安全地继续执行,还要保存业务执行状态。
这次评论故障最终依靠五部分信息恢复:
Conversation History:模型下一次需要看到什么
AgentStep:当前这一步执行到哪里
AgentRun:整个任务处于什么状态
Pending Action:还在等待用户决定什么
Checkpoint:Agent Loop 从哪里安全继续
它们不是为了完成一套设计仪式,而是分别解决一个具体问题:模型想做什么、Runtime 做到哪里、外部世界实际发生了什么,以及暂停后怎样继续原动作。
State 主要服务于当前任务的执行和恢复。至于哪些信息值得跨任务保留、什么时候应该忘记,则属于 Memory 的问题,后续会继续展开。
后续延伸
Agent Memory:什么时候该记,什么时候不该记?
参考资料
- OpenAI Agents SDK — Running agents:
https://developers.openai.com/api/docs/guides/agents/running-agents - OpenAI Agents SDK — Results and state:
https://developers.openai.com/api/docs/guides/agents/results - pi — Coding Agent SDK / AgentSession:
https://github.com/earendil-works/pi/blob/main/packages/coding-agent/docs/sdk.md - pi — Agent loop source:
https://github.com/earendil-works/pi/blob/main/packages/agent/src/agent-loop.ts - pi — Agent event types:
https://github.com/earendil-works/pi/blob/main/packages/coding-agent/src/core/extensions/types.ts - GitHub REST API — Issue comments:
https://docs.github.com/en/rest/issues/comments - GitHub Docs — Hiding content with comments:
https://docs.github.com/en/get-started/writing-on-github/getting-started-with-writing-and-formatting-on-github/basic-writing-and-formatting-syntax#hiding-content-with-comments