Tool Result 设计:Agent 如何看懂工具返回?
工具返回值不是把原始 API 响应塞回模型,而是一份能区分成功、空结果、失败与截断,并支持下一步决策的环境反馈。
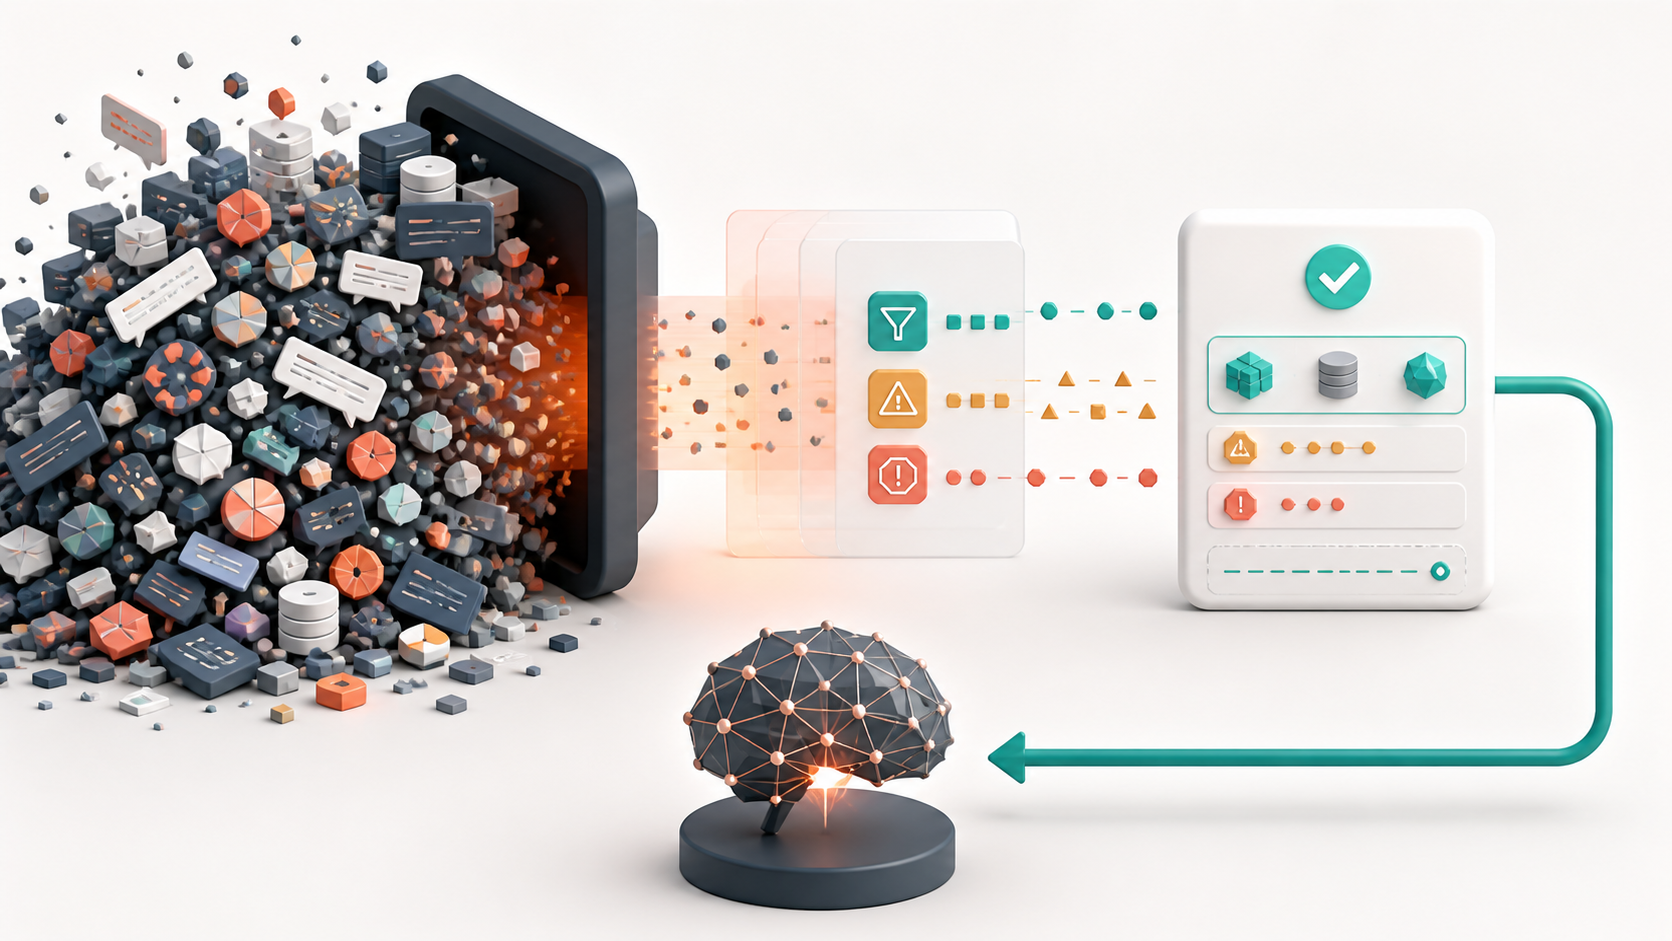
文章目录
导语
前两篇分别解决了 Tool Calling 的两端:
- 第 3 篇讲模型怎样提出一次工具请求,Runtime 怎样执行;
- 第 4 篇讲工具怎样用 Schema 描述输入与边界。
这一篇看返回方向。
假设日志 API 返回了 2 MB JSON,其中包含时间戳、主机、容器、索引、标签、原始消息和分页信息。最省事的代码是:
return JSON.stringify(apiResponse)
它确实把结果交给了模型,却把三个问题一起带了进去:
- 大量字段与当前任务无关;
- 空结果、失败和被截断容易混淆;
- 模型不知道还能不能继续、应该怎样继续。
Tool Result 不是“工具有什么就返回什么”,而是工具与 Agent Runtime 之间的输出契约。它要让下一轮准确知道:这次动作发生了什么、结果是否完整、失败能否恢复,以及哪些事实可以作为证据。
一、Observation 在代码里就是 Tool Result
第二篇把 Agent Loop 写成:
Input → Decision → Action → Observation
其中 Observation 并不是另一个模型的总结。它通常就是工具执行完成后,Runtime 放回消息列表的 Tool Result。
{
  "toolCallId": "call_7f2",
  "isError": false,
  "output": {
    "matches": 12,
    "topError": "INVALID_SIGNATURE"
  }
}
不同模型 API 或 Agent 框架的字段名会不同,但两个信息不能丢:
- 这份结果对应哪一次 Tool Call;
- 工具是成功执行,还是返回了错误。
如果同一轮并行查询三个系统,没有调用 ID,结果就很容易错配。
二、先区分四种完全不同的结果
工具返回 []、抛出异常、只返回前 100 条和成功返回完整数据,不能被压成同一个状态。
可以先建立四类基础语义:
| 状态 | 含义 | 下一步可能是什么 |
|---|---|---|
| 成功且有结果 | 调用成功,取得数据 | 分析证据或继续调用 |
| 成功但为空 | 调用成功,没有匹配项 | 修改查询或得出“未找到” |
| 成功但被截断 | 只返回部分数据 | 翻页、缩小范围或接受样本 |
| 调用失败 | 没有得到可信业务结果 | 重试、授权、修正参数或停止 |
“空结果”不是错误。
例如查询过去十分钟的错误日志返回零条,可能真的没有错误;也可能时间范围选错。这需要模型结合任务判断。但如果 HTTP 请求超时,系统根本没有完成查询,不能把它伪装成零条。
“被截断”也不是完整成功。模型如果不知道只拿到前 100 条,可能错误地说“总共只有 100 条”。
三、为同一工具设计稳定输出
以日志查询为例,可以定义统一结构:
type SearchLogsResult = {
  ok: boolean
  data?: {
    matches: Array<{
      timestamp: string
      service: string
      level: 'info' | 'warn' | 'error'
      message: string
      requestId?: string
    }>
    total?: number
  }
  page?: {
    truncated: boolean
    nextCursor?: string
  }
  error?: {
    code: string
    message: string
    retryable: boolean
    retryAfterMs?: number
  }
}
成功、有数据:
{
  "ok": true,
  "data": {
    "matches": [
      {
        "timestamp": "2026-08-13T09:10:12Z",
        "service": "auth-api",
        "level": "error",
        "message": "JWT signature verification failed",
        "requestId": "req_abc"
      }
    ],
    "total": 120
  },
  "page": {
    "truncated": true,
    "nextCursor": "cursor_02"
  }
}
调用失败:
{
  "ok": false,
  "error": {
    "code": "FORBIDDEN",
    "message": "当前账号无权查询 production 日志",
    "retryable": false
  }
}
稳定结构的价值不是让 JSON 更漂亮,而是让 Runtime、模型、前端和日志系统都能用相同语义处理结果。
四、不要把原始响应直接塞回上下文
原始 API 响应适合程序使用,不一定适合模型判断。
日志平台可能返回:
索引分片信息
查询耗时明细
内部节点 ID
完整容器标签
原始高亮片段
调试元数据
数千条重复日志
当前任务可能只需要:时间、服务、错误信息、请求 ID、匹配总数和下一页游标。
工具适配层可以通过确定性代码完成整理:
function normalizeLogResponse(
  response: RawLogResponse
): SearchLogsResult {
  return {
    ok: true,
    data: {
      matches: response.hits.slice(0, 50).map(hit => ({
        timestamp: hit.timestamp,
        service: hit.labels.service,
        level: hit.level,
        message: hit.message,
        requestId: hit.requestId
      })),
      total: response.total
    },
    page: {
      truncated: response.total > 50,
      nextCursor: response.nextCursor
    }
  }
}
这段整理没有判断“谁导致了登录失败”。它只是选择字段、限制数量、统一结构并标记截断。这些是确定性转换,适合工具适配层完成。
假设用户当前的任务是“排查最近一小时登录失败增多的原因”。整理后的结果回到 Agent Loop 后,模型能看到三项与任务直接相关的信息:日志来自 auth-api,错误内容是 JWT signature verification failed,而且结果还没有读取完整。
基于这些观察,模型可以提议按 requestId 查询关联日志,或者读取下一页,验证签名错误是否在失败请求中反复出现。但在拿到更多证据前,它不能直接把这条日志写成登录失败的根因。
五、工具可以压缩数据,但不要偷偷生成结论
并不是所有结果都能靠字段映射缩短。一份超长文档或完整代码 diff 可能需要摘要。
这里要区分两种处理:
确定性裁剪
例如只保留匹配行前后各 20 行、最多返回 50 条、删除重复记录。这些规则可复现,也容易测试。
模型摘要
例如让另一个模型把 5000 行日志整理成五类错误。它可能很有用,但摘要本身不是原始证据。
如果结果经过模型摘要,应该保留来源与范围:
{
  "summary": "主要错误为签名校验失败",
  "summaryGenerated": true,
  "source": {
    "artifactId": "logs_20260813_01",
    "recordsAnalyzed": 5000
  },
  "truncated": false
}
关键结论最好还能回到原始记录核验。
不要让摘要把“可能相关”改写成“已经证明”,也不要丢失哪些数据没有被分析。
六、错误结果要告诉系统能不能恢复
只返回:
{ "error": "请求失败" }
模型和 Runtime 都不知道该怎么办。
更有用的错误至少包含:
- 稳定错误码;
- 面向当前任务的安全说明;
- 是否适合重试;
- 必要时给出等待时间或下一步动作。
例如:
{
  "ok": false,
  "error": {
    "code": "RATE_LIMITED",
    "message": "日志服务当前限流",
    "retryable": true,
    "retryAfterMs": 5000
  }
}
Runtime 可以根据确定性策略等待后重试,而不必让模型猜。
再看权限错误:
{
  "ok": false,
  "error": {
    "code": "FORBIDDEN",
    "message": "当前账号无权查询 production 日志",
    "retryable": false
  }
}
重复调用不会改变权限,所以 Runtime 应停止自动重试,转为等待授权或向用户说明。
错误信息也不要泄露密钥、数据库连接串、内部堆栈和其他租户数据。详细技术信息可以进入受控日志,给模型和用户的内容应经过脱敏。
七、截断结果必须留下继续方法
仅仅返回:
{ "truncated": true }
模型知道数据不完整,却不知道怎样获取剩余部分。
更好的输出同时提供继续入口:
{
  "ok": true,
  "data": {
    "matches": []
  },
  "page": {
    "truncated": true,
    "nextCursor": "cursor_02"
  }
}
对于文件读取,可以返回:
{
  "path": "src/auth.ts",
  "content": "...",
  "range": { "startLine": 1, "endLine": 200 },
  "truncated": true,
  "nextStartLine": 201
}
这样模型才能明确选择继续读取、缩小范围或根据当前样本回答。
但不要让 Agent 无限制翻页。Runtime 仍要限制总条数、总字节、轮数和成本。
八、返回文本、JSON,还是文件引用
没有一种格式适合所有工具。
简短文本
适合非常简单的状态:
测试通过:42 passed,0 failed
结构化 JSON
适合模型需要按字段判断、Runtime 需要统一处理的结果:
{
  "passed": 42,
  "failed": 0,
  "durationMs": 18320
}
Artifact 引用
Artifact 是文件、报告、截图等可独立保存和访问的任务产物。结果过大或需要后续下载时,不应全部塞进消息:
{
  "artifactId": "test-report-01",
  "mediaType": "text/html",
  "summary": {
    "passed": 120,
    "failed": 3
  }
}
模型先看摘要,需要细节时再读取产物中的具体部分。Artifact 的存储、版本与权限会在第 17 篇详细讨论。
选择标准是:下一步判断需要什么粒度,以及结果是否应该独立保存。不要因为 JSON 看起来专业,就把一整份二进制文件编码进 JSON。
九、Tool Result 与最终回答不是一回事
工具返回:
{
  "status": 401,
  "errorCode": "INVALID_SIGNATURE"
}
这是环境事实。
模型最终说:
登录失败与 JWT 签名校验有关;结合配置记录,测试环境密钥与签发服务不一致。
这是结合多份证据形成的任务结论。
不要在工具适配层提前把原始数据包装成过度确定的结论:
{
  "rootCause": "JWT_SECRET 配置错误"
}
除非工具本身就是一个经过定义和验证的诊断服务,并且这个字段真由它产生。
明确事实来源后,Agent 的结论才可追踪:哪条来自日志,哪条来自代码,哪条是模型推断。
十、前端需要的是状态摘要,不是整份结果
Tool Result 进入模型上下文时,可能包含代码片段或结构化记录。前端通常只需要安全摘要:
日志查询成功:找到 12 条记录
只展示前 50 条,可继续加载
查询失败:缺少生产环境权限
测试完成:3 个用例失败
因此可以在后端同时产生两种表示:
type ToolExecutionRecord = {
  modelResult: unknown
  uiSummary: {
    title: string
    status: 'running' | 'success' | 'error' | 'waiting'
    detail?: string
  }
}
它们来自同一次执行,但服务不同读者。uiSummary 不应包含密钥、完整查询语句或敏感原始数据。
十一、怎样测试 Tool Result
不要只测试“工具函数有没有返回”。至少覆盖五类用例:
正常结果
关键字段是否存在,类型是否稳定,调用 ID 是否正确关联。
空结果
是否明确表示调用成功,而不是伪装成错误或 null。
超大结果
是否执行截断,是否提供总量、范围和继续方式。
各类失败
超时、限流、权限不足和参数错误是否有不同错误码与重试语义。
敏感信息
访问令牌、内部堆栈、用户隐私和跨租户数据是否被移除。
还要把结果真正送进下一轮模型测试。结构在 TypeScript 中合理,不代表模型就能稳定理解。最终验证问题是:模型能否根据结果选出正确的下一步,并且不会把不完整数据当成完整事实。
十二、用一个文件工具检查是否理解
设计一个 read_file 的返回结果。文件有 3000 行,本次只读取 200—400 行。
试着回答:
- 结果如何表明真实返回范围?
- 如何告诉模型文件还有后续内容?
- 文件不存在和读取权限不足是否应该使用同一个错误码?
- 如果内容太长而经过模型摘要,怎样保留原始证据入口?
- 前端应该展示完整源码,还是安全的读取状态摘要?
如果你的设计能区分事实、范围、错误和继续方法,Tool Result 就不再是一段随意字符串,而是一份能驱动下一轮的输出契约。
十三、这一篇真正要记住的事
一个好的 Tool Result 要回答五个问题:
对应哪次调用
动作是否成功
取得了哪些必要事实
结果是否完整
失败或未完成时怎样继续
工具适配层负责确定性整理、错误分类、脱敏和截断;模型负责结合任务目标解释结果。超大内容可以保存为 Artifact,只把摘要和引用放进上下文。
至此,我们已经走完 Agent Loop 最基础的消息往返:Tool Call 有输入契约,Tool Result 有输出契约。
下一阶段开始解决一个新的问题:循环跑了很多轮后,哪些信息必须保存,怎样暂停和恢复,才不会每次都从头开始?
下一篇预告
下一篇:Agent 状态管理:多轮执行时到底要存什么?
参考资料
- OpenAI API — Function calling:
https://developers.openai.com/api/docs/guides/function-calling - Model Context Protocol — Tools and Tool Result:
https://modelcontextprotocol.io/specification/2025-06-18/server/tools - pi-agent — Agent loop source:
https://github.com/earendil-works/pi/blob/main/packages/agent/src/agent-loop.ts