Tool Calling:Agent 真正开始干活的地方
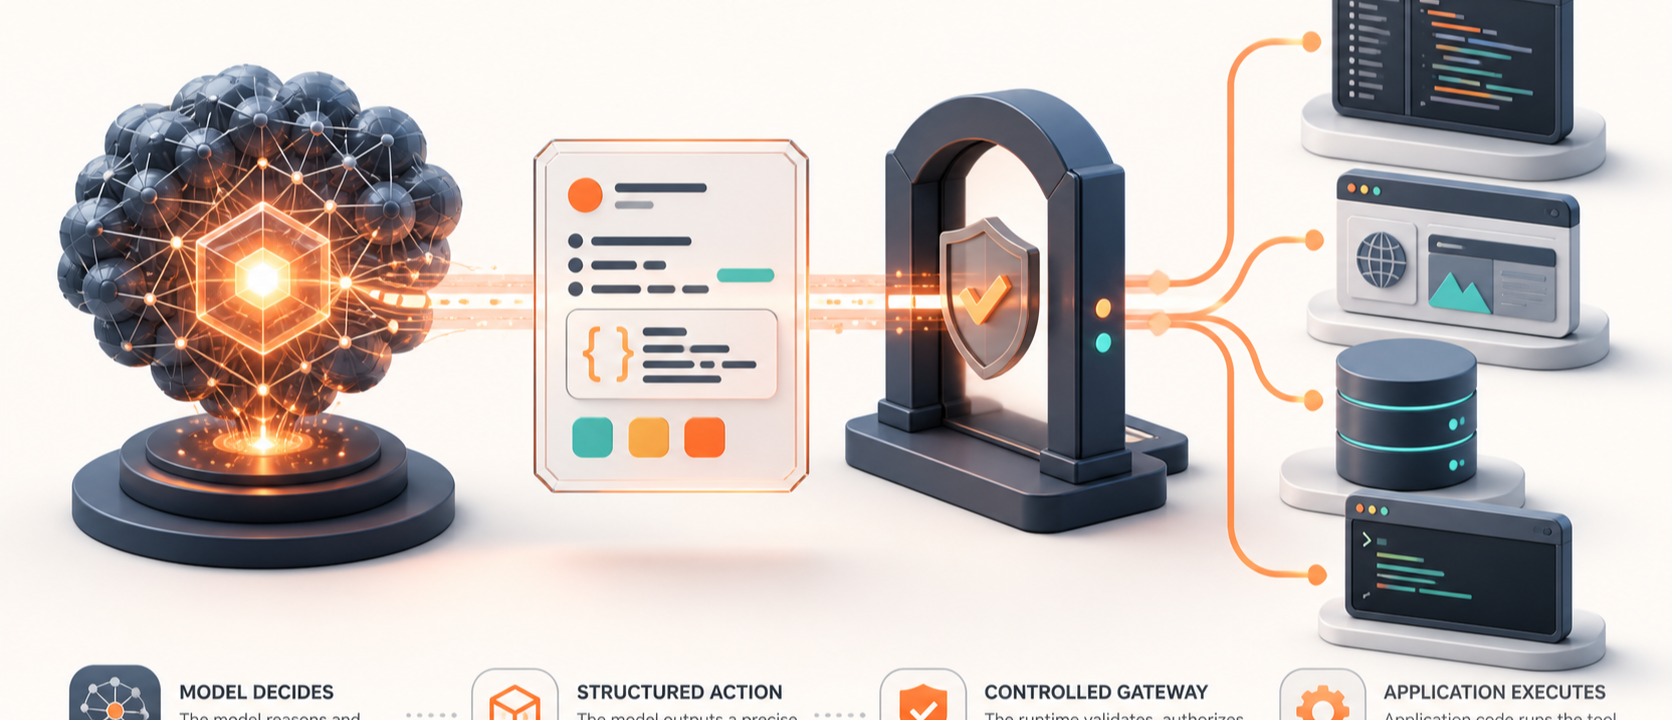
模型并不会直接执行函数。Tool Calling 是模型与应用之间的一份结构化行动请求,也是 Agent 接触外部世界的第一道接口。
文章目录
- 导语
- 一、Tool Calling 不是模型在执行函数
- 二、一次调用包含五个环节
- 1. 应用告诉模型“有哪些工具”
- 2. 模型选择回复或请求工具
- 3. Runtime 校验调用
- 4. 应用执行工具
- 5. 工具结果回到模型
- 三、一个可运行心智模型的 TypeScript 示例
- 四、Tool、Function 和 MCP 不要混为一谈
- Tool 是模型可请求的能力
- Function Calling 是一种调用表达方式
- MCP 是工具发现与调用的一种协议
- 五、读工具和写工具,风险不一样
- 六、并行调用什么时候成立
- 七、前端和后端看到的不是同一个东西
- 前端不该只显示“正在思考”
- 后端需要保留可追踪的调用记录
- 八、五个最容易犯的错误
- 把 Tool Call 当成已执行
- 只校验 JSON,不校验权限
- 让模型填写可信身份
- 失败后丢掉调用关联
- 把所有能力塞进一个万能工具
- 九、用一个新场景检查是否理解
- 十、这一篇真正要记住的事
- 下一篇预告
- 参考资料
导语
上一篇,我们写出了 Agent Loop 的最小骨架:模型提出下一步,Runtime 校验并执行工具,Tool Result 再回到下一轮。
现在把其中一次动作放大。
用户说:
查一下登录接口为什么返回 401。
模型需要查询日志。可模型既没有日志系统的账号,也不能在你的服务器里直接运行代码。它能做的,是返回一份结构化请求:
{
  "name": "search_logs",
  "arguments": {
    "query": "status:401 path:/api/login",
    "environment": "staging"
  }
}
应用收到请求后,找到对应工具,校验参数与权限,然后才真正访问日志系统。
这套“模型提出调用,应用负责执行”的接口,就是 Tool Calling,也常被称为 Function Calling。
这一篇不急着讨论怎样写出最优 Tool Schema,也不展开 Tool Result 的字段设计——它们分别属于下一篇和下下篇。本文只解决一个问题:一次工具调用从哪里开始,到哪里结束?
一、Tool Calling 不是模型在执行函数
“模型调用函数”是一种方便但不够精确的说法。
模型真正产生的只是输出数据。它可能在响应中选择某个工具,并给出一组参数。真正执行函数的,仍然是你的应用代码、Agent Runtime 或模型服务提供的托管工具环境。
以读取文件为例:
模型输出
read_file({ path: "src/pages/Login.tsx" })

Runtime
检查 read_file 是否开放、路径是否合法

工具实现
从文件系统读取内容

Runtime
把读取结果送回模型
这条边界很重要。因为模型输出可能有错,甚至可能被恶意内容诱导。只要真实动作仍经过应用控制,我们就能在执行前校验、拒绝或请求用户确认。
因此,Tool Call 更像一张“行动申请单”,不是已经发生的事实。
二、一次调用包含五个环节
OpenAI 的 Function Calling 文档把一次调用概括为五步:应用向模型提供工具,模型返回调用请求,应用执行代码,再把调用结果交给模型,模型随后回答或继续调用。
把这五步放回我们的 Agent Runtime,可以写成:
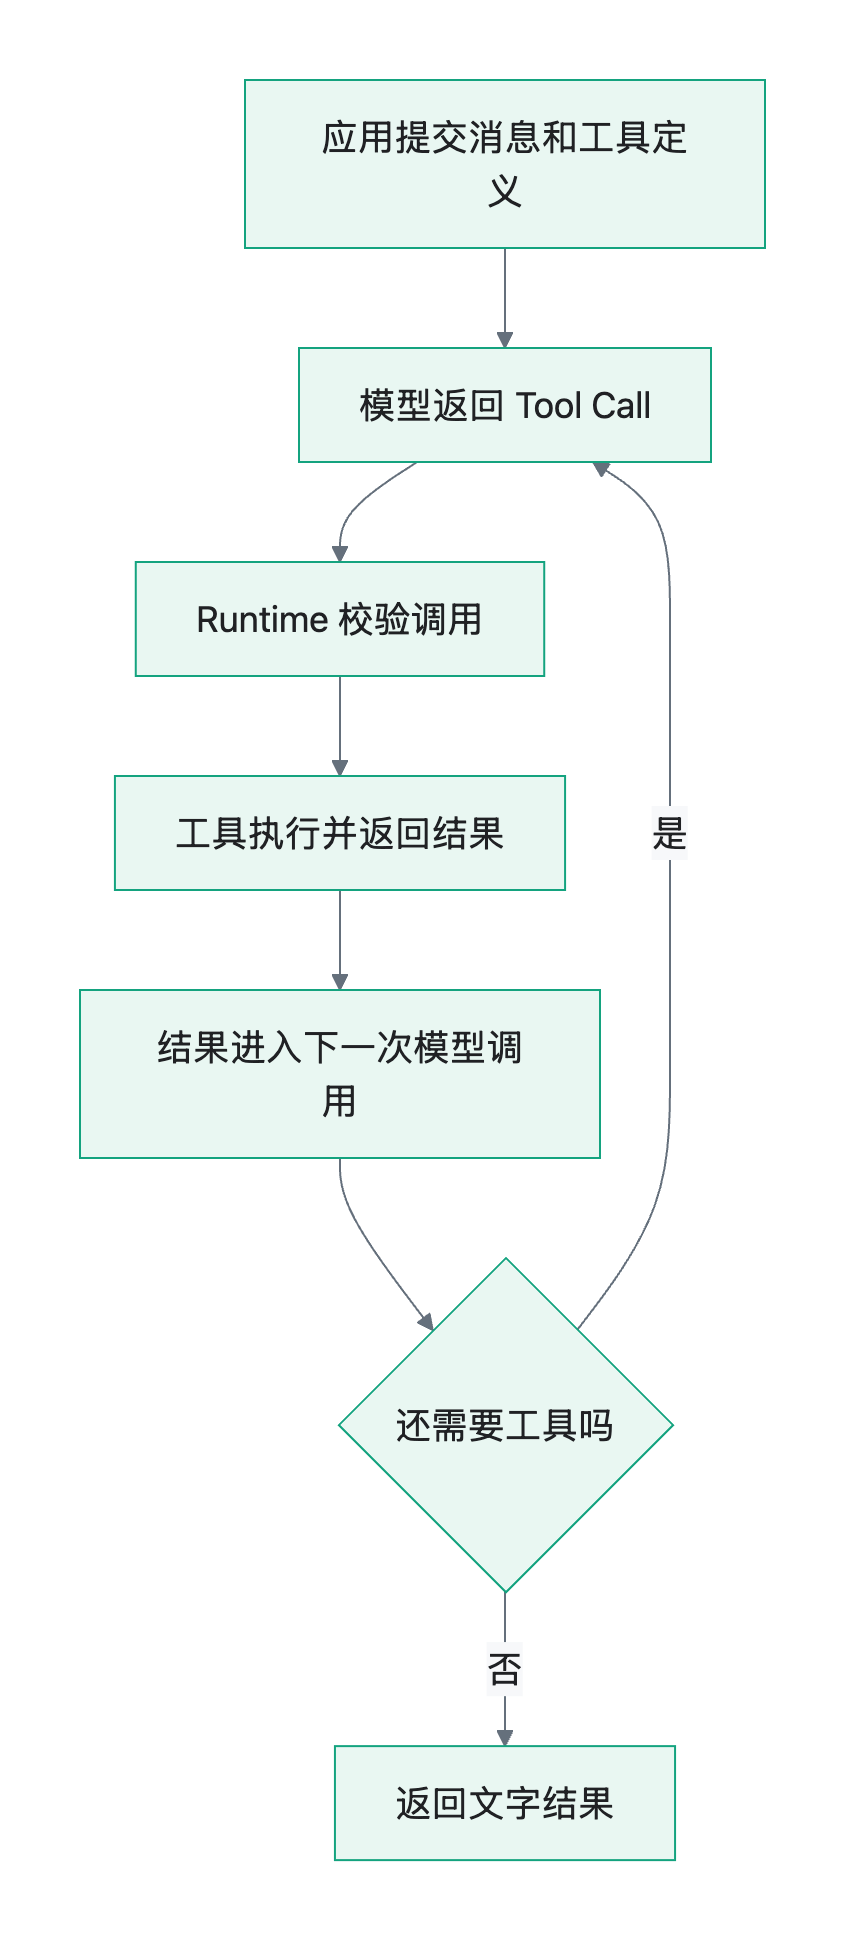
逐步看一遍。
1. 应用告诉模型“有哪些工具”
模型不会自动知道你的项目里存在 search_logs。调用模型时,应用要同时提供工具定义:
const tools = [
  {
    type: 'function',
    name: 'search_logs',
    description: '查询指定环境的应用日志',
    parameters: {
      type: 'object',
      properties: {
        query: { type: 'string' },
        environment: {
          type: 'string',
          enum: ['staging', 'production']
        }
      },
      required: ['query', 'environment'],
      additionalProperties: false
    }
  }
]
这段定义是给模型看的能力说明,不是工具实现本身。
2. 模型选择回复或请求工具
模型看到用户任务和工具定义后,可能直接回答,也可能返回 Tool Call。
{
  "type": "function_call",
  "call_id": "call_7f2",
  "name": "search_logs",
  "arguments": "{\"query\":\"status:401 path:/api/login\",\"environment\":\"staging\"}"
}
具体字段会随 SDK 和模型服务变化。上面的结构接近 OpenAI Responses API:arguments 是 JSON 编码字符串,call_id 用于把稍后的工具结果关联回这次调用。
3. Runtime 校验调用
模型生成的工具名和参数都不能直接信任。Runtime 至少检查:
- 工具是否存在并向本轮开放;
- 参数是否符合 schema;
- 当前用户能否访问目标环境;
- 这次动作是否需要用户确认。
这里的 schema 校验只能证明“参数形状正确”。它不能证明用户有权限,也不能证明动作符合业务规则。
4. 应用执行工具
检查通过后,应用把参数交给真正的工具函数:
const handlers = {
  search_logs: async (args: SearchLogsArgs, ctx: ToolContext) => {
    return logClient.search({
      tenantId: ctx.tenantId,
      environment: args.environment,
      query: args.query
    })
  }
}
登录凭证和 tenantId 来自受信任的执行上下文,不应由模型自由填写。否则模型可能通过参数访问错误账号或其他租户的数据。
5. 工具结果回到模型
工具执行完成后,Runtime 构造与原调用对应的结果:
{
  "type": "function_call_output",
  "call_id": "call_7f2",
  "output": "{\"matches\":12,\"topError\":\"INVALID_SIGNATURE\"}"
}
模型下一轮会同时看到原任务、自己的 Tool Call 和这份结果,于是可以继续查询或组织最终回答。
如果应用执行了工具,却没有把结果送回模型,Agent Loop 就断了。
三、一个可运行心智模型的 TypeScript 示例
下面的代码不绑定具体 SDK,只表达一次 Tool Call 在应用侧怎样被接住。
type ToolDefinition = {
  name: string
  description: string
  parameters: unknown
}

type ToolCall = {
  id: string
  name: string
  arguments: unknown
}

type ToolContext = {
  userId: string
  tenantId: string
  approvals: Set<string>
}

type Tool = {
  definition: ToolDefinition
  execute: (
    args: unknown,
    context: ToolContext
  ) => Promise<unknown>
}

async function handleToolCall(
  call: ToolCall,
  tools: Tool[],
  context: ToolContext
) {
  const tool = tools.find(
    item => item.definition.name === call.name
  )

  if (!tool) {
    return toolError(call, 'TOOL_NOT_ALLOWED')
  }

  try {
    const args = validate(
      tool.definition.parameters,
      call.arguments
    )

    await authorize({
      userId: context.userId,
      tenantId: context.tenantId,
      toolName: call.name,
      args
    })

    const output = await tool.execute(args, context)
    return toolSuccess(call, output)
  } catch (error) {
    return toolError(call, classifyToolError(error))
  }
}
这段代码有四个值得注意的地方。
第一,模型只提供 call.name 和 call.arguments,不能指定执行函数本身。
第二,Runtime 从本轮允许的 tools 中查找工具。即使系统注册了一百个工具,某次任务也可以只开放三个。
第三,用户和租户信息来自 ToolContext,而不是模型参数。
第四,无论成功还是失败,返回结果都保留原调用 ID。下一轮才知道哪次动作发生了什么。
这只是接口骨架。validate 怎样实现、错误怎样分类、结果怎样截断,会在后面逐篇补齐。
四、Tool、Function 和 MCP 不要混为一谈
这三个词经常一起出现,但它们不在同一层。
Tool 是模型可请求的能力
例如读取文件、查天气、搜索日志、运行测试。它是能力层的统称。
Function Calling 是一种调用表达方式
应用用结构化定义告诉模型有哪些函数工具;模型以结构化数据返回调用请求;应用再执行并回传结果。
有些模型平台还提供 Web Search、Code Interpreter 等托管工具。它们仍属于工具,但执行环境可能由平台负责,而不是你的服务器。
MCP 是工具发现与调用的一种协议
Model Context Protocol(MCP)规定客户端与服务器怎样列出工具、调用工具和返回结果。一个 MCP Server 可以向 Agent 提供多项工具。
但用了 Tool Calling,不代表一定使用 MCP。本地 TypeScript 函数、公司内部 HTTP API 或云平台托管工具,都可以通过 Tool Calling 接入 Agent。
可以这样理解:
Tool:模型能使用什么能力
Function Calling:模型怎样表达一次结构化调用请求
MCP:工具提供方和 Agent 之间怎样标准化连接
MCP 会在第 26 篇单独展开。现在不要为了调用一个本地函数,先引入一整套协议。
五、读工具和写工具,风险不一样
同样是 Tool Call,下面两个动作的副作用完全不同:
read_file({ path: "src/auth.ts" })
delete_user({ userId: "u_123" })
前者通常只读取信息;后者会改变真实业务状态,而且可能难以恢复。
第一版 Agent 可以按风险把工具粗分为:
| 类型 | 示例 | 常见处理 |
|---|---|---|
| 只读 | 查日志、读文件、列出订单 | 权限检查后可自动执行 |
| 可恢复写入 | 生成草稿、创建 Patch | 执行后保留预览或撤销路径 |
| 高副作用 | 删除数据、付款、部署生产 | 执行前要求明确确认 |
这不是通用安全标准,只是一种起步分法。真正的权限判断还要考虑用户身份、目标资源、金额、环境和组织策略。
关键结论是:模型选中了工具,不代表系统已经授权执行。
第 9、10 篇会继续设计权限控制和 Human-in-the-loop。在第三篇,我们先把检查入口留在 Runtime 中。
六、并行调用什么时候成立
模型一次响应可能返回多个 Tool Call。例如排查页面异常时,同时读取前端组件和无依赖的配置文件。
如果两个调用互不依赖、没有冲突副作用,Runtime 可以并行执行:
const results = await Promise.all(
  toolCalls.map(call =>
    handleToolCall(call, tools, context)
  )
)
但下面这种链路不能盲目并行:
先创建订单 → 再使用订单 ID 发起支付
第二个动作依赖第一个动作的输出,只能串行。
写操作之间还可能发生冲突。生产 Runtime 应允许工具声明执行模式,或由编排层判断依赖关系。并行不是越多越好,它只在结果独立且副作用可控时减少等待时间。
七、前端和后端看到的不是同一个东西
Tool Calling 是后端接口,也是产品交互事件。
前端不该只显示“正在思考”
Runtime 可以把工具事件转换成用户能理解的状态:
正在读取登录页面
正在查询测试环境日志
等待确认:是否运行集成测试
日志查询失败,可重试
不要直接把完整参数、访问令牌或内部报错堆栈展示给用户。前端需要的是动作名称、目标对象、状态、可执行操作和安全的结果摘要。
后端需要保留可追踪的调用记录
一次调用至少应能追踪:
- 调用 ID;
- 工具名;
- 脱敏后的参数;
- 发起和完成时间;
- 成功、失败或等待确认;
- 结构化错误码;
- 结果摘要或产物引用。
这些记录既用于恢复和排错,也能支持前端实时更新状态。后面的状态管理与可观测性会给出更完整的数据结构。
八、五个最容易犯的错误
把 Tool Call 当成已执行
模型只是请求动作。只有工具真正返回成功,系统才能记录 Action 已发生。
只校验 JSON,不校验权限
参数格式正确,不代表当前用户可以读取生产日志或删除订单。
让模型填写可信身份
tenantId、访问令牌和当前登录用户应来自服务端上下文,而不是模型可控参数。
失败后丢掉调用关联
错误结果也要对应原调用 ID。否则多个并行调用发生错误时,模型和日志都难以判断谁失败了。
把所有能力塞进一个万能工具
execute(action: string, payload: unknown)
这种接口把大量选择藏在字符串中,既难校验,也难做细粒度权限。工具应该怎样拆分,是下一篇 Tool Schema 的核心问题。
九、用一个新场景检查是否理解
用户说:
查出订单 20260813001 当前为什么没有发货,不要修改订单。
Agent 可以使用 get_order 和 get_fulfillment_events 两个只读工具。
试着不回看前文,回答:
- 模型返回
get_order后,订单数据已经读取了吗? orderId应该怎样校验?- 当前用户的租户身份应该从哪里来?
- 工具返回后,模型为什么能继续查询履约事件?
正确思路是:模型只提出调用;Runtime 校验工具、参数和资源权限;可信身份来自服务端执行上下文;结果带着调用关联回到下一轮,模型才获得新信息。
如果能用订单场景重新讲清这条链路,就说明你理解的是 Tool Calling 的通用机制,而不是记住了登录排障的步骤。
十、这一篇真正要记住的事
Tool Calling 给模型的不是直接执行权,而是提出结构化行动请求的能力。
一次完整调用需要:
应用提供工具定义
→ 模型返回 Tool Call
→ Runtime 校验工具、参数和权限
→ 应用执行真实代码
→ Tool Result 关联回原调用
→ 模型基于结果继续
理解这条边界后,下一篇的问题就自然出现了:模型靠什么分清两个相似工具?参数怎样写,才能既好用又不越界?
答案藏在 Tool Schema 里。
下一篇预告
下一篇:Tool Schema 设计:为什么你的 Agent 总是调用错工具?
参考资料
- OpenAI API — Function calling:
https://developers.openai.com/api/docs/guides/function-calling - Model Context Protocol — Tools:
https://modelcontextprotocol.io/specification/2025-06-18/server/tools - pi-agent — Agent loop source:
https://github.com/earendil-works/pi/blob/main/packages/agent/src/agent-loop.ts