Agent 的最小闭环:输入、思考、行动、观察
不从业务流程背概念,而是从一次真实的多步排障出发,看懂模型、Runtime 与工具如何共同形成 Agent Loop。
文章目录
- 导语
- 一、先看它实际跑一遍
- 二、一轮循环里,三方分别做了什么
- 模型负责做语义判断
- Runtime 负责驱动和约束执行
- 工具负责接触外部环境
- 三、Input、Decision、Action、Observation 到底是什么
- Input:这一轮模型能看到的信息
- Decision:模型对外给出的下一步
- Action:通过检查后真正发生的动作
- Observation:动作带回来的结果
- 四、通用 Agent 不应被一个场景绑住
- 五、最小 Agent Loop 的代码骨架
- executeChecked 为什么不能省
- 六、循环停止了,不等于任务完成了
- 七、Agent 为什么容易原地打转
- 八、ReAct 与今天的 Tool Calling 是什么关系
- 九、这个最小循环会怎样长成完整 Agent
- 十、用一个新任务检验是否真的理解
- 十一、这一篇真正要记住的事
- 下一篇预告
- 参考资料
导语
上一篇,我们用一个问题区分了 Chatbot、Workflow 和 Agent:任务执行到一半时,谁根据最新结果决定下一步?
如果答案是模型会根据中间结果继续选择动作,那么接下来的问题就是:这个过程在代码里怎么发生?
假设用户交给开发助手这样一个任务:
帮我查清登录按钮点击后没有反应的原因,先不要修改代码。
它可能先读取登录页组件,发现点击事件确实触发了;然后查看浏览器请求,发现接口返回 401;再读取服务端日志,最终定位到测试环境的签名密钥配置错误。
第二步之所以发生,是因为第一步排除了“按钮没有绑定事件”;第三步之所以发生,是因为第二步取得了 401 这个新线索。
Agent 就这样一边行动,一边获得新信息,再用新信息决定下一步。这个不断重复的过程,就是 Agent Loop。
这一篇只做一件事:建立整套课程后续章节都会复用的运行心智模型。读完后,你应该能看懂一次 Agent 运行中,模型、Runtime 和工具究竟怎样接力。
一、先看它实际跑一遍
把刚才的排障过程写成运行记录,大致是这样:
用户
查清登录按钮点击后没有反应的原因,先不要修改代码。

第 1 轮
模型 → read_file({ path: "src/pages/Login.tsx" })
工具 → 点击事件已绑定,提交时会调用 login()

第 2 轮
模型 → inspect_network({ urlPattern: "/api/login" })
工具 → POST /api/login 返回 401,错误码为 INVALID_SIGNATURE

第 3 轮
模型 → search_logs({ query: "INVALID_SIGNATURE" })
工具 → 测试环境 JWT_SECRET 与签发服务不一致

第 4 轮
模型 → 返回排查结论、证据和建议,不修改代码
如果这是固定 Workflow,开发者需要提前写死“先读组件,再看网络,再查日志”。但真实排障并不总走这条路径:第一步也可能发现按钮被遮挡,接下来应该检查页面样式;接口也可能返回 500,下一步要看的就是错误堆栈。
Agent 的价值,正是让后续动作随着观察结果变化。
不过模型并没有直接读取文件、打开浏览器或查询日志。它只是提出了结构化的工具调用,真正的动作由承载 Agent 的程序执行。这个程序通常被称为 Agent Runtime,也就是驱动模型和工具反复交互的运行时。
二、一轮循环里,三方分别做了什么
下面这张图只表达最小执行关系。先抓住主干,暂时不用考虑重试、并行工具和断点恢复。
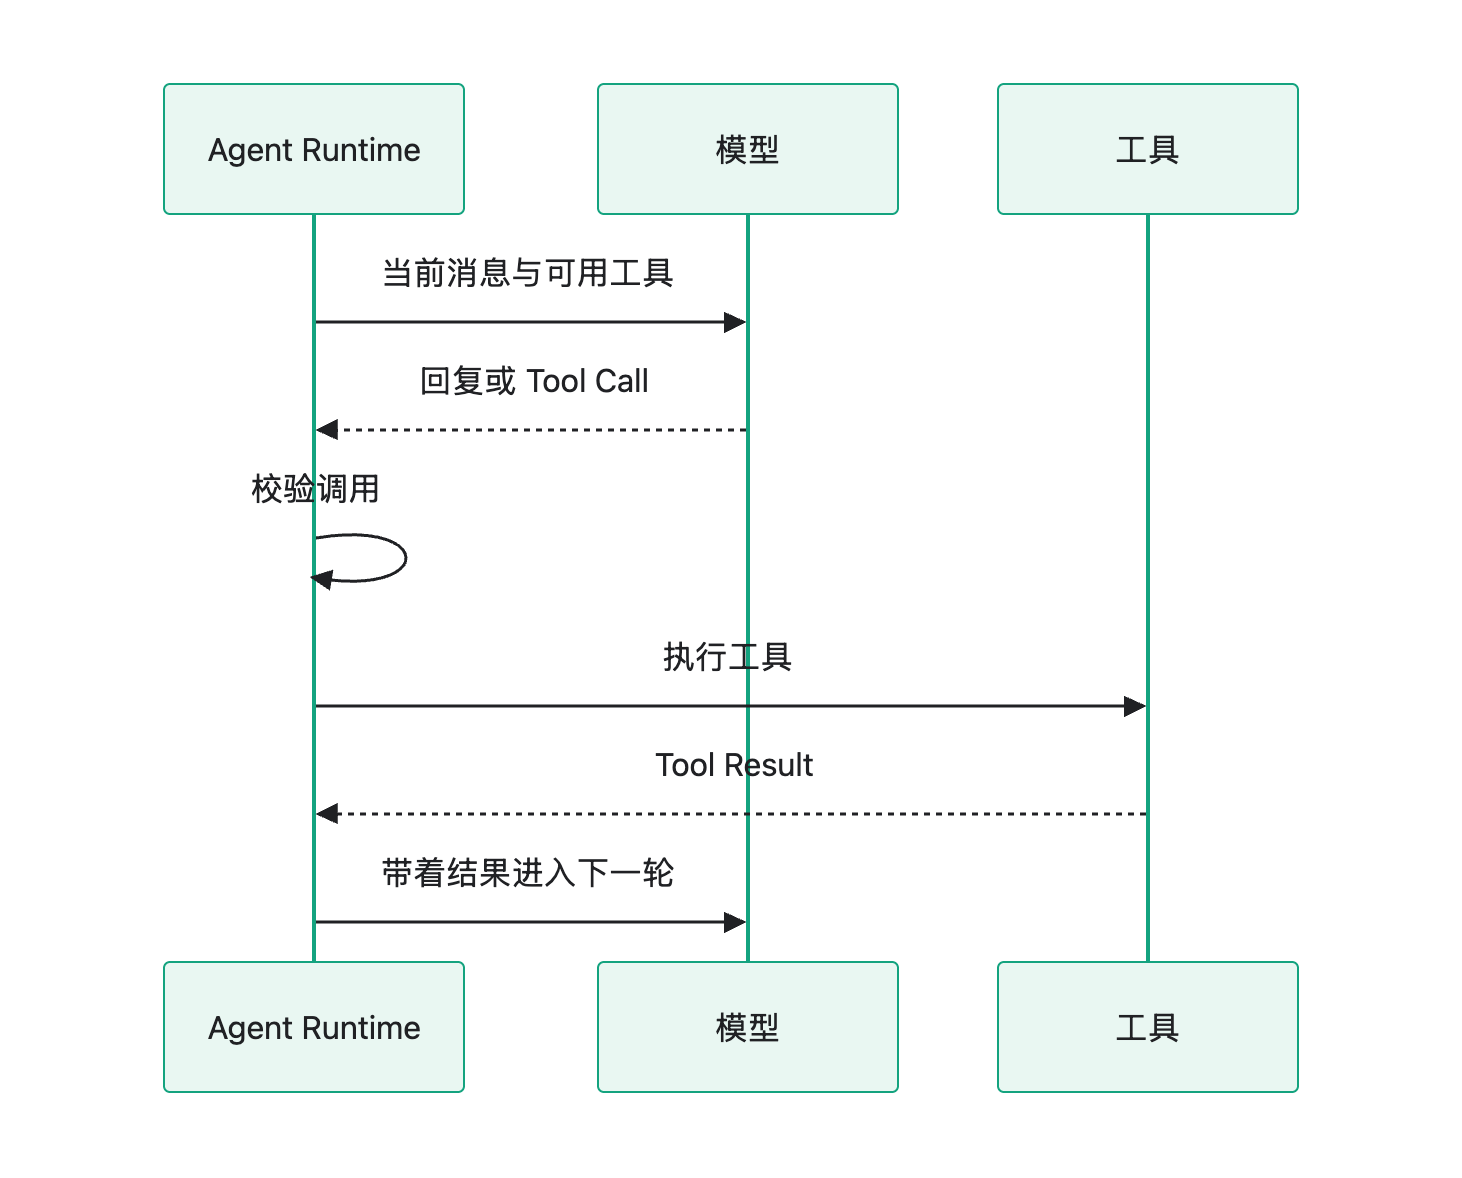
在这个最小模型里,三方各有自己的主要职责:
模型负责做语义判断
模型理解用户目标和已有结果,然后选择:
- 直接回答;
- 询问用户;
- 或提出一个 Tool Call。
例如它看到 POST /api/login 返回 401,判断接下来值得查询相关错误日志。这是语义决策,适合由模型完成。
Runtime 负责驱动和约束执行
Runtime 保存当前消息,调用模型,接收 Tool Call,检查工具与参数,再把允许的动作交给工具。
它还应负责最大轮数、超时、取消、权限拦截等确定性规则。模型可以建议调用工具,但不能绕过这些规则。
工具负责接触外部环境
工具才是真正读取文件、请求 API、查询日志或操作浏览器的代码。执行结束后,它返回成功结果或错误信息。
可以把它们的关系记成一句话:
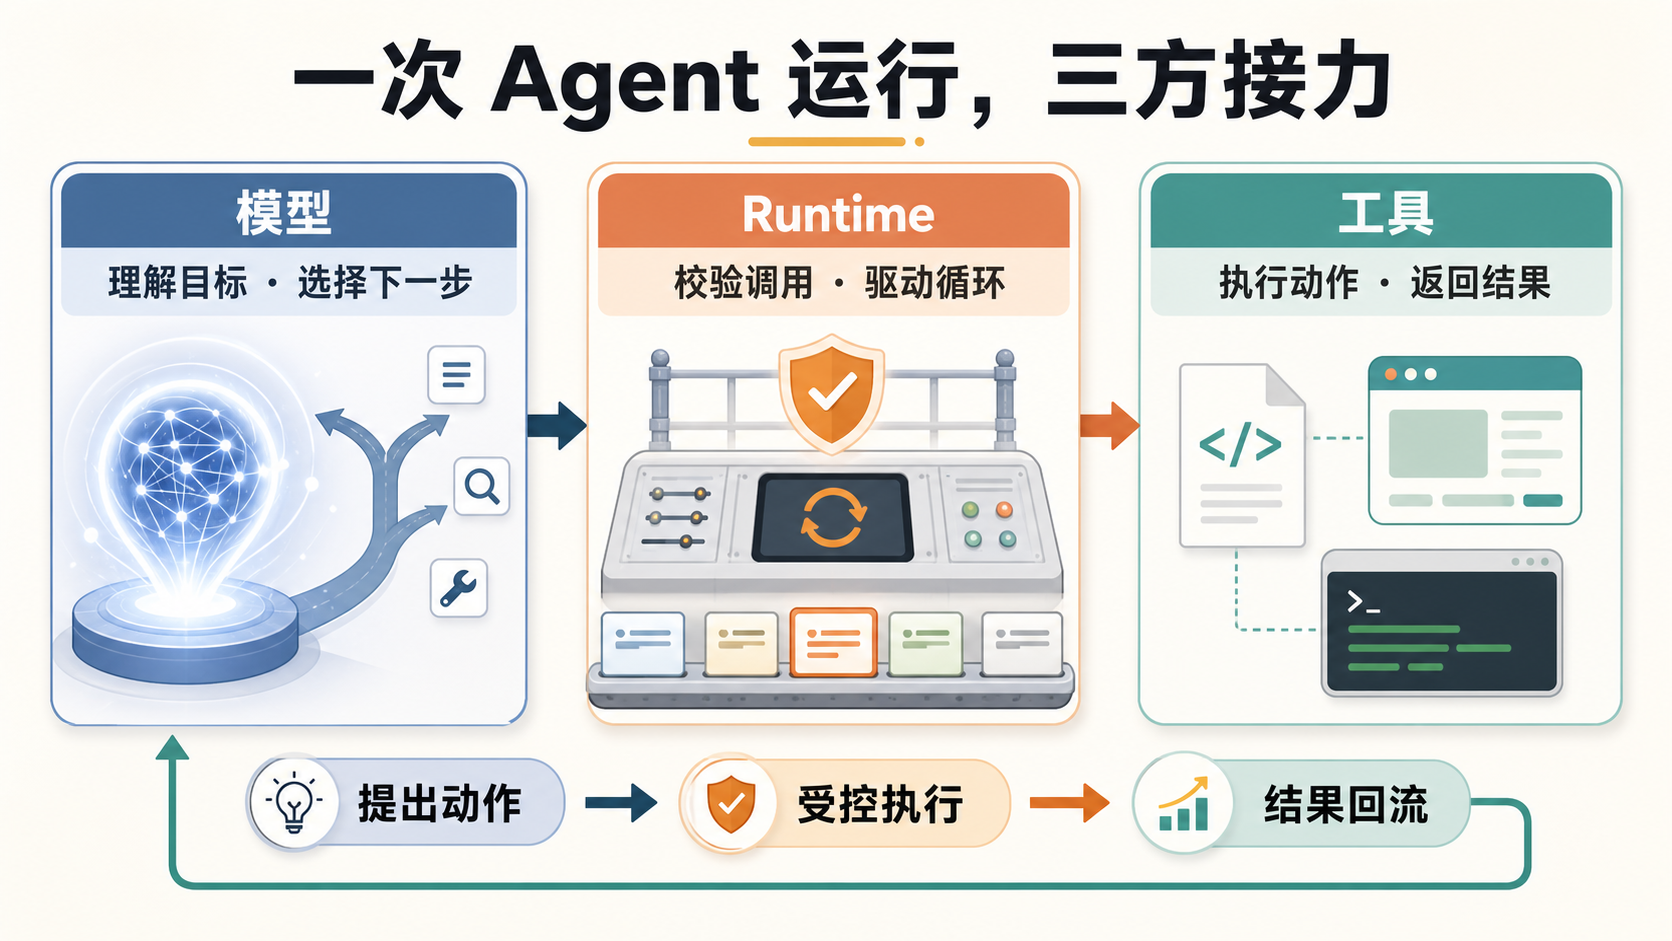
模型选择下一步,Runtime 管住执行过程,工具读取或改变环境。
这张分工图是整篇文章的核心。后面的 Tool Calling、权限、状态和可观测性,都是在这三个位置上继续增加工程能力。
三、Input、Decision、Action、Observation 到底是什么
现在再回头看标题里的四个阶段,它们就不再抽象了。
Input:这一轮模型能看到的信息
Input 不只是用户刚输入的一句话。它通常包含:
- 用户当前的任务;
- 需要保留的历史消息;
- 前几轮取得的工具结果;
- 本轮允许使用的工具说明;
- 应用提供的项目、账号或页面等运行上下文;
- Agent 的稳定行为原则。
Runtime 负责组装这些信息,再提交给模型。至于哪些历史信息应该保留、怎样压缩,是后面 Context Engineering 和状态管理要解决的问题。
Decision:模型对外给出的下一步
很多资料沿用 ReAct 中的 Thought,把这一阶段叫“思考”。这个词可以帮助入门,但工程实现真正需要处理的,是模型对外给出的结果:回答、提问或 Tool Call。
因此本文用 Decision 表示可被程序消费的决定,不要求模型暴露完整内部推理。
一个 Tool Call 可能长这样:
{
  "id": "call_02",
  "name": "inspect_network",
  "arguments": {
    "urlPattern": "/api/login"
  }
}
它表达的是“模型请求调用这个工具”,不代表动作已经成功。
Action:通过检查后真正发生的动作
Runtime 找到 inspect_network 工具,校验参数和权限,通过后才执行它。
同一个 Tool Call 可能有三种结果:
- 工具获准执行并成功;
- 参数不合法,被 Runtime 拒绝;
- 动作需要用户确认,运行暂停。
因此,模型决定调用工具和系统真正执行工具,是两个不同事件。
Observation:动作带回来的结果
工具执行后返回 Tool Result:
{
  "toolCallId": "call_02",
  "isError": false,
  "output": {
    "method": "POST",
    "path": "/api/login",
    "status": 401,
    "errorCode": "INVALID_SIGNATURE"
  }
}
这就是 Observation。Runtime 把它追加到消息中,下一次调用模型时一并提交。
toolCallId 很重要。它让系统和模型知道,这份结果对应哪一次调用。如果一轮里有多个工具调用,这种对应关系更不能丢。
Observation 也可能是错误:超时、权限不足、参数错误和空结果都应该被明确表示。模型只有看到真实结果,才能判断是重试、换方法、询问用户还是停止。
四、通用 Agent 不应被一个场景绑住
理解 Input 后,就能回答一个常见的设计问题:system prompt 到底应该放什么?
对于通用开发 Agent,下面这些属于相对稳定的行为原则:
- 根据用户目标和工具结果选择下一步。
- 需要外部事实时使用工具验证,不要猜测。
- 没有验证的工作,不要声称已经完成。
- 缺少关键信息或授权时,明确告诉用户。
它们对前端排障、后端排障、代码解释和文档维护都适用。
但本次任务要求应该随任务进入:
目标:定位登录失败的原因。
边界:只读排查,不修改代码。
交付:给出已验证的原因、对应证据和修复建议。
换成另一个任务,这部分自然会变化。
还有一些限制不能只写在 prompt 里:
只允许访问当前工作区
最多运行 10 轮
写文件前必须获得确认
Runtime 应该用路径检查、计数器和权限状态真正执行这些限制。
于是,输入相关的信息可以分成三层:
| 信息 | 生命周期 | 典型承载位置 |
|---|---|---|
| 通用行为原则 | 跨多类任务保持稳定 | system prompt |
| 当前目标与交付要求 | 随每次任务变化 | 用户消息或任务上下文 |
| 可确定执行的硬限制 | 由系统强制保证 | Runtime、权限系统或 Sandbox |
这不是某个 API 强制规定的唯一架构,而是一条避免过拟合的工程原则:不要把短期任务写成长期身份,也不要把安全边界只写成自然语言愿望。
专用 Agent 当然可以拥有领域提示和固定工具集。例如客服 Agent 可以长期了解工单规则。但即便如此,账号权限、写操作确认和资源范围仍应由系统强制执行。
五、最小 Agent Loop 的代码骨架
下面用一段与模型服务商无关的 TypeScript,把前面的接力写成代码。
type ToolCall = {
  id: string
  name: string
  arguments: unknown
}

type AssistantMessage = {
  role: 'assistant'
  text: string
  toolCalls: ToolCall[]
}

type ToolResultMessage = {
  role: 'tool'
  toolCallId: string
  name: string
  output: unknown
  isError: boolean
}

type AgentMessage =
  | { role: 'user'; content: string }
  | AssistantMessage
  | ToolResultMessage

type Tool = {
  name: string
  schema: unknown
  execute: (args: unknown) => Promise<unknown>
}

async function runAgent(
  userTask: string,
  tools: Tool[]
) {
  const messages: AgentMessage[] = [
    { role: 'user', content: userTask }
  ]

  for (let turn = 0; turn < 10; turn++) {
    const assistant = await callModel({
      systemPrompt: GENERAL_AGENT_PROMPT,
      messages,
      tools: tools.map(toToolDefinition)
    })

    messages.push(assistant)

    if (assistant.toolCalls.length === 0) {
      return {
        status: 'stopped',
        text: assistant.text,
        messages
      }
    }

    for (const toolCall of assistant.toolCalls) {
      const toolResult = await executeChecked(
        toolCall,
        tools
      )

      messages.push(toolResult)
    }
  }

  return {
    status: 'limit_reached',
    messages
  }
}
先顺着正常路径读:
- Runtime 把用户任务放进消息列表;
- Runtime 把消息和工具定义交给模型;
- 模型返回一条 assistant 消息;
- 如果消息中没有 Tool Call,本轮运行停止;
- 如果有 Tool Call,Runtime 校验并执行;
- Tool Result 被放回消息列表;
- 下一轮模型看到新结果后继续决定。
这一骨架与 pi-agent 的核心循环一致:模型产生 assistant 消息;其中有工具调用就执行工具并追加结果;没有工具调用时,循环结束。pi-agent 还处理了流式事件、并行或串行工具、用户中途追加消息、参数校验和中止等生产能力。
OpenAI 的 Function Calling 文档描述的也是同一类往返:把工具提供给模型,接收函数调用,在应用侧执行,再把带有关联 ID 的函数结果交回模型。不同 SDK 的字段名会变化,循环本身没有变。
executeChecked 为什么不能省
模型输出的参数不是可信输入。执行前至少要确认工具存在,并按 schema 校验参数:
async function executeChecked(
  call: ToolCall,
  tools: Tool[]
): Promise<ToolResultMessage> {
  const tool = tools.find(item => item.name === call.name)

  if (!tool) {
    return {
      role: 'tool',
      toolCallId: call.id,
      name: call.name,
      output: { code: 'TOOL_NOT_ALLOWED' },
      isError: true
    }
  }

  try {
    const args = validate(tool.schema, call.arguments)
    await enforcePolicy(call.name, args)
    const output = await tool.execute(args)

    return {
      role: 'tool',
      toolCallId: call.id,
      name: call.name,
      output,
      isError: false
    }
  } catch (error) {
    return {
      role: 'tool',
      toolCallId: call.id,
      name: call.name,
      output: normalizeError(error),
      isError: true
    }
  }
}
这里先展示职责,不展开 schema 怎么写、错误结果怎样设计。它们正是第三、四、五篇要继续回答的问题。
六、循环停止了,不等于任务完成了
代码里,模型没有返回 Tool Call 时,循环就停止。但产品不能因此直接显示“任务已完成”。
模型的文字可能是:
我需要知道问题出现在哪个环境。
这时状态应该是 waiting_for_user。
也可能是:
目前只能确认接口返回 401,尚未取得服务端日志。
这更接近 incomplete。
只有当当前任务要求已经满足,产品才应标记 completed。因此可以把“循环为何停下”和“任务是否成功”分开:
| 运行状态 | 含义 |
|---|---|
completed |
已交付当前任务要求的结果 |
waiting_for_user |
缺少信息、授权或确认 |
incomplete |
已有部分结果,但无法继续完成 |
limit_reached |
达到 Runtime 的时间、轮数或成本限制 |
谁来判断 completed 没有唯一答案。简单任务可以由模型输出结构化状态,再由程序校验必填结果;关键任务还可以增加专门验证步骤。这里要记住的是:“不再调用工具”只是一条停止信号,不是一张完成证明。
七、Agent 为什么容易原地打转
Agent Loop 给了模型多次尝试的机会,也带来了循环风险。
最典型的情况是:模型重复调用同一个搜索工具,工具每次都返回相同空结果,模型却没有得到足够信息改变策略。
只写一句“不要重复调用”不够。Runtime 至少要提供确定性的保护:
- 最大轮数和最长运行时间;
- 工具调用次数或成本预算;
- 相同工具与参数的重复检测;
- 用户取消信号。
工具结果也要明确区分“没有找到数据”和“查询失败”。如果所有异常都只返回 failed,模型很难知道下一步应该换关键词、稍后重试,还是请求权限。
任务本身则需要可判断的交付要求。“尽可能深入排查”没有自然终点;“输出已验证原因、证据和待验证项,不修改代码”更容易收口。
任务要求帮助模型判断何时可以交付,Runtime 限制负责在异常路径上强制止损。两者缺一不可。
八、ReAct 与今天的 Tool Calling 是什么关系
ReAct 是 Reasoning and Acting 的缩写。论文讨论的关键思想,是让推理与面向环境的行动交错发生:一次行动取得的新信息,会改变后续判断。
这正是 Agent Loop 的思想来源之一。
但生产系统不必要求模型公开输出下面这种自由文本:
Thought: 我需要查询登录请求
Action: inspect_network
Observation: 请求返回 401
现代工具调用通常把 Action 表示为结构化 Tool Call,把 Observation 表示为 Tool Result。这样更容易校验参数、关联调用、控制权限和记录运行轨迹。
所以,ReAct 帮助我们理解“判断与行动为什么要交替”;Function Calling 和 Agent Runtime 则给出了更适合工程实现的消息与执行方式。
九、这个最小循环会怎样长成完整 Agent
现在回看整套课程,后面的主题都可以挂到这个循环上:
| 后续主题 | 它在解决循环里的什么问题 |
|---|---|
| Tool Calling | 模型怎样表达一次行动请求 |
| Tool Schema | 怎样让模型选对工具、传对参数 |
| Tool Result | 怎样把真实结果清楚地送回下一轮 |
| 状态管理 | 长任务中哪些消息、步骤和状态需要保存 |
| Memory 与 Context | 哪些历史信息应该在这一轮被模型看到 |
| Planning | 什么时候先规划,什么时候根据结果即时行动 |
| 权限与 Human-in-the-loop | 哪些动作能自动执行,哪些必须停下来确认 |
| 可观测性与 Eval | 怎样复盘循环为什么成功或跑偏 |
| Sandbox 与安全 | 工具真正执行时,怎样限制影响范围 |
前端工程师也能从这条循环找到自己的位置:模型和工具产生的事件,需要被转成“正在读取文件”“等待确认”“已完成”等可理解状态;取消、重试和接管也需要明确交互。
后端工程师面对的则是一个带模型决策的任务执行器:消息要持久化,工具要受控,错误要分类,运行要能停止和恢复。
这一篇不提前解决所有问题。它的作用,是给后面每一个工程模块找到准确位置。
十、用一个新任务检验是否真的理解
不要回看前文,试着用自己的话解释下面的过程:
用户:找出首页首屏变慢的原因,先不要改代码。
然后回答四个问题:
- 模型想读取构建产物时,谁真正执行动作?
- bundle 分析结果怎样影响下一步?
- “先不要改代码”应该只靠 system prompt 保证吗?
- 模型停止调用工具时,任务一定完成了吗?
如果你能回答出下面的意思,就已经抓住了最小闭环:
- 模型提出 Tool Call,Runtime 校验后由工具执行;
- Tool Result 回到消息,成为下一轮 Input 的一部分;
- 只读限制应随任务传入,Runtime 还要真正拦截写工具;
- 停止调用只是循环结束,产品仍要判断是完成、等待用户还是未完成。
这也是一次费曼式检验:不仅记得四个名词,还能用一个全新的例子重新搭出整个过程。
十一、这一篇真正要记住的事
上一篇说明了 Agent 为什么不同于一次问答和固定工作流。这一篇把差异落到了运行时:
Runtime 把当前消息和工具交给模型;模型回复或提出 Tool Call;Runtime 校验后执行工具,并把 Tool Result 放回消息;模型根据新结果继续,直到交付、等待用户或受控停止。
模型、Runtime 和工具的边界必须清楚:
- 模型负责语义判断和动作选择;
- Runtime 负责驱动循环、执行硬限制;
- 工具负责接触真实环境并返回结果。
下一篇,我们会把其中一次 Tool Call 单独放大:模型看到的工具是什么,调用请求如何生成,应用又如何安全地接住它。
下一篇预告
下一篇:Tool Calling:Agent 真正开始干活的地方。
参考资料
- ReAct: Synergizing Reasoning and Acting in Language Models:
https://arxiv.org/abs/2210.03629 - OpenAI API — Function calling:
https://developers.openai.com/api/docs/guides/function-calling - pi-agent — Agent loop source:
https://github.com/earendil-works/pi/blob/main/packages/agent/src/agent-loop.ts