什么是 Agent?它和普通 Chatbot 到底有什么区别
用同一个代码审查任务,分清 Chatbot、Workflow 与 Agent,并判断你的场景是否真的需要 Agent。
文章目录
- 导语
- 一、先看同一个任务的三种做法
- Chatbot:根据已有上下文生成回答
- Workflow:执行预先写好的步骤
- Agent:根据中间结果选择下一步
- 二、Agent 到底是什么
- 1. 目标
- 2. 动态决策
- 3. 工具
- 4. 反馈
- 5. 边界
- 三、从代码里看“谁决定下一步”
- 四、为什么 Agent 比 Chatbot 难做
- 一次错误可能改变后续路径
- 工具会产生真实副作用
- 只看最终答案无法定位问题
- 五、什么情况下值得使用 Agent
- 更适合 Chatbot 的场景
- 更适合 Workflow 的场景
- 更适合 Agent 的场景
- 六、前端和后端工程师分别会碰到什么
- 七、三个常见误区
- “越自主越像 Agent”
- “用了 Tool Calling 就是 Agent”
- “Agent 就等于 Multi-Agent”
- 八、课后练习:先判断,再设计
- 九、这一篇真正要记住的事
- 下一篇预告
导语
用户贴来一个 GitHub PR,然后说:
帮我看看这个 PR 有没有明显问题。
有的系统会告诉他“代码审查应该关注正确性、安全性和可维护性”;有的系统会按固定规则跑 lint、测试和扫描;还有的系统会先读取变更文件,发现认证模块风险较高,再继续检查相关调用和测试,最后给出带证据的结论。
这三种系统都可能使用大模型,但只有第三种更接近我们这套课程要讨论的 Agent。
区别不在聊天界面,也不在产品名字里有没有 “Agent”,而在一个更具体的问题上:任务执行到一半时,谁根据最新结果决定下一步?
读完这一篇,你应该能够:
- 分清 Chatbot、Workflow 和 Agent;
- 判断一个需求是否值得引入 Agent;
- 理解为什么 Agent 开发会自然涉及工具、状态、权限和日志。
一、先看同一个任务的三种做法
不要急着背定义。我们先让三种系统处理同一个 PR Review 任务。
Chatbot:根据已有上下文生成回答
如果用户只贴了一段 diff,模型阅读这段文本并给出建议,这通常还是 Chatbot。
它完成的是一次上下文内的生成:
用户提供内容 → 模型处理 → 返回回答
模型可以很聪明,回答也可能很有价值,但系统没有继续读取仓库、运行测试或根据新证据改变执行路径。
Workflow:执行预先写好的步骤
如果系统收到 PR 后总是依次执行下面几步:
拉取 diff → 运行 lint → 运行单元测试 → 套用模板 → 发送报告
它更像 Workflow(工作流)。下一步早已写在代码或编排配置里。即使某个 PR 只改了文档,它也可能照常跑完所有检查。
Workflow 的优势恰恰是确定:容易预测、测试和控制。对于日报、数据同步、审批流等稳定任务,它往往比 Agent 更合适。
Agent:根据中间结果选择下一步
Agent 面对同一个 PR,执行路径可能是:
- 先读取 PR 描述和变更文件;
- 发现
src/auth.ts修改了 token 刷新逻辑; - 决定继续读取调用方和相关测试;
- 根据代码和测试结果,判断问题是否成立;
- 证据足够后停止探索,交付 Review 结论。
换一个只修改 CSS 的 PR,它可能在第二步就结束。路径不是提前完全写死的,而是由任务目标和中间结果共同决定。
下面这张图强调的不是三种产品外观,而是三种执行方式:单次生成、固定流水线,以及根据证据反馈调整动作。
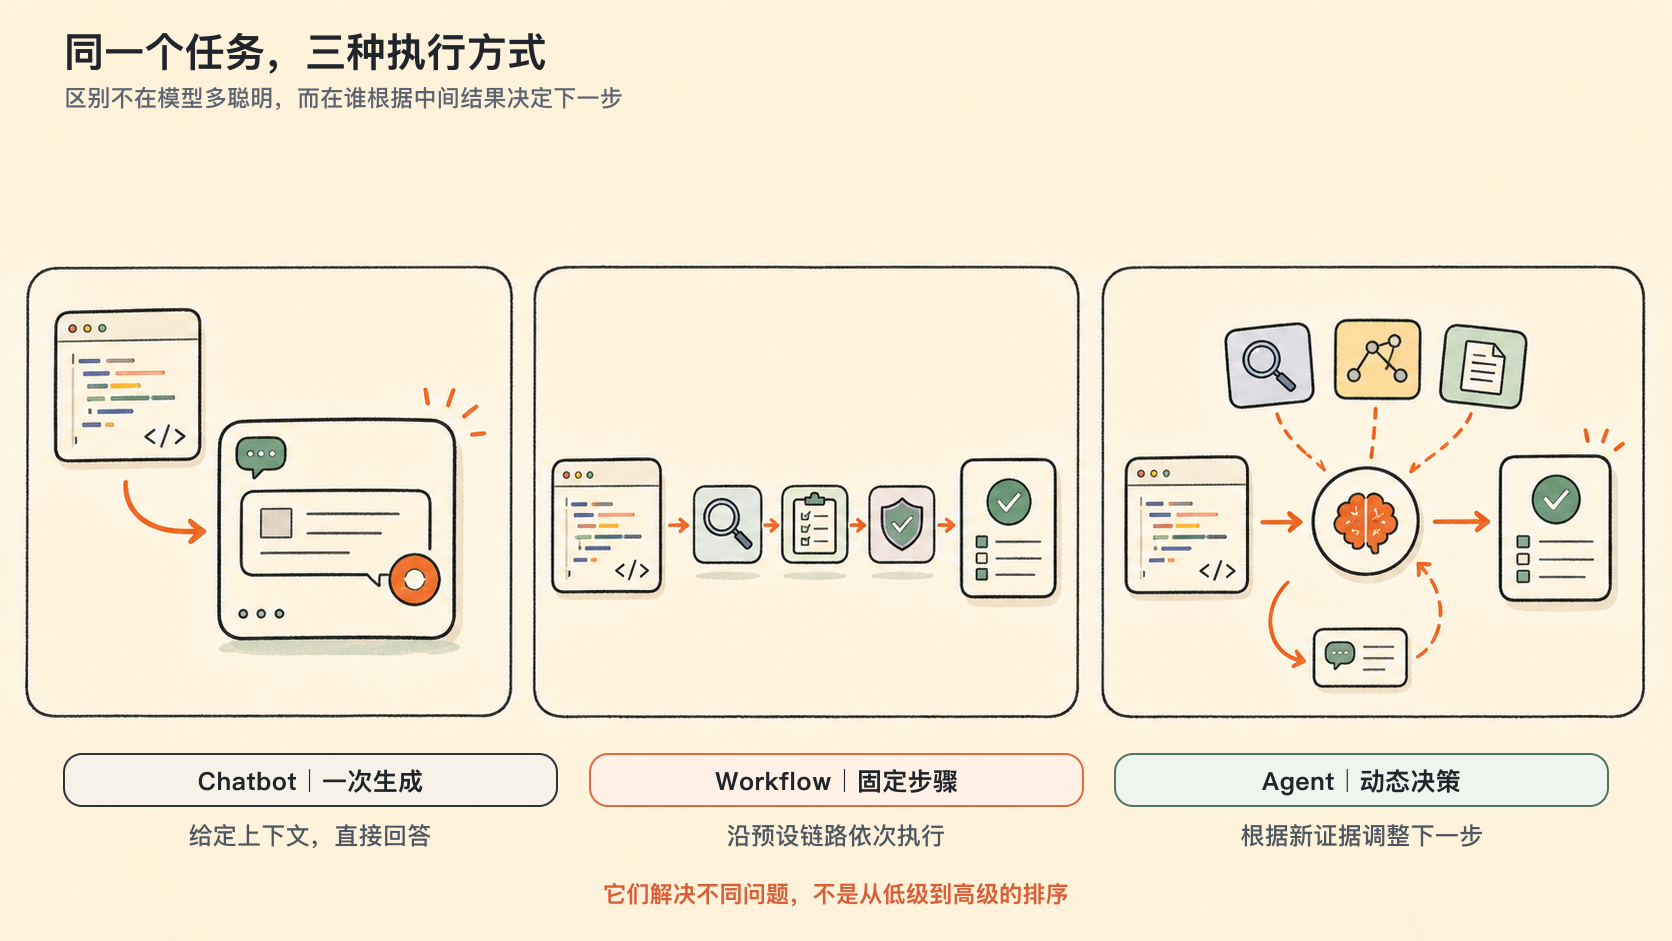
把差异压缩成一张表,会更清楚:
| 系统形态 | 下一步由谁决定 | 适合的任务 | 主要风险 |
|---|---|---|---|
| Chatbot | 一次模型响应 | 解释、总结、基于给定内容生成 | 缺少外部证据时容易凭上下文猜测 |
| Workflow | 程序员预先定义 | 步骤稳定、规则明确、需要可预测执行 | 遇到例外时不够灵活 |
| Agent | 模型在运行中提出动作,Runtime 约束并执行 | 路径不固定、需要探索和判断 | 成本、行为和副作用更难控制 |
它们不是从低级到高级的升级路线。能用 Workflow 稳定解决的问题,没有必要为了“智能”改成 Agent。
二、Agent 到底是什么
在这套课程里,我们使用下面这个工程定义:
Agent 是一个围绕用户目标运行的执行系统。它能根据当前状态选择下一步动作,通过工具读取或改变环境,再利用动作结果继续判断,直到完成、失败或需要用户接管。
这个定义包含五个不可缺少的部分。
1. 目标
Agent 接收的通常不是一个知识问题,而是一个希望被完成的任务。
解释什么是 OAuth
更像问答。
检查这个项目的 OAuth 回调是否存在安全问题,并给出证据
才像一个需要执行的目标。后者隐含了范围、完成条件和可交付结果。
2. 动态决策
Agent 要在运行中决定“现在最值得做什么”。模型可以提出下一步动作,但它不能直接获得无限权力。
例如模型可以提出“读取 src/auth.ts”,而 Agent Runtime(负责驱动循环和执行工具的运行时程序)仍要检查:这个工具是否存在、参数是否合法、文件是否在允许范围内。
3. 工具
工具把模型的意图变成真实动作,例如:
- 调用 GitHub API;
- 读取文件;
- 查询数据库;
- 操作浏览器;
- 运行测试;
- 创建评论或提交 Patch。
工具数量多,不代表系统就是 Agent。固定 Workflow 也可以调用很多 API。关键仍然是:系统会不会根据工具返回的结果调整后续动作。
4. 反馈
工具的返回值会成为新的观察结果。Agent 读取它,判断目标是否已经完成,或者还缺什么证据。
如果工具只负责执行,结果却没有回到模型和运行状态里,系统就无法形成真正的闭环。
5. 边界
Agent 的自主性必须发生在边界内。工程上至少要回答三件事:
- 它能使用哪些工具;
- 它最多运行多久、多少步、花费多少资源;
- 哪些动作可以自动执行,哪些必须由用户确认。
因此,一个可用的 Agent 不是“模型想做什么就做什么”,而是模型负责在有限选项中提出动作,软件系统负责校验、执行和兜底。
三、从代码里看“谁决定下一步”
先看一个固定 Workflow:
async function reviewPullRequest(prUrl: string) {
  const diff = await getPullRequestDiff(prUrl)
  const lintResult = await runLint()
  const testResult = await runTests()

  return buildReport({ diff, lintResult, testResult })
}
无论中间发生什么,调用顺序主要由程序员提前决定。
Agent Runtime 的骨架则不同:
type Tool = {
  name: string
  execute: (args: unknown) => Promise<unknown>
}

async function runAgent(goal: string, tools: Tool[]) {
  const state = createInitialState(goal)

  for (let step = 0; step < 8; step++) {
    const decision = await model.decide({ state, tools })

    if (decision.type === 'final') {
      return decision.answer
    }

    const result = await executeChecked(decision.toolCall, tools)
    state.observations.push(result)
  }

  return buildIncompleteResult(state)
}
这里最值得注意的不是 for 循环,而是两种职责被明确分开:
- 模型根据目标和当前观察结果提出下一步;
- Runtime 检查动作、执行工具、保存结果,并在达到限制时停止。
后面的 Tool Calling、State、Permission、Observability,本质上都在补全这段骨架。
四、为什么 Agent 比 Chatbot 难做
Chatbot 的主要不确定性集中在一次输出里。Agent 会把这份不确定性带进一个持续运行的系统。
一次错误可能改变后续路径
如果模型第一轮选错了文件,第二轮就可能基于错误上下文继续分析。错误不再只影响一句回答,而会沿执行链路传播。
所以 Agent 需要保存当前状态、限制最大步骤,并判断重复调用和无效探索。
工具会产生真实副作用
“建议修改广告预算”和“真的修改广告预算”是两件事。“生成 PR 评论草稿”和“发布评论”也是两件事。
一旦工具能写入外部系统,工程师就要区分:
只读动作:读取 PR、查询数据、检查文件
可逆写入:创建草稿、生成 Patch、暂存变更
高风险动作:发送消息、合并代码、删除数据、修改预算
不同级别需要不同的权限校验、预览和确认机制。
只看最终答案无法定位问题
当 Agent 给出一条错误结论时,原因可能完全不同:
- 选错了工具;
- 参数填错了;
- 工具返回被截断;
- 观察结果没有进入下一轮上下文;
- 模型重复探索;
- 权限不足却被误判成“数据不存在”。
因此,Agent 不只要记录最终回答,还要记录每一步的动作、脱敏参数、结果摘要、耗时和错误。这个可复盘的执行记录通常称为 Trace(追踪记录)。
五、什么情况下值得使用 Agent
可以先问下面四个问题:
- 完成任务是否需要读取或改变外部环境?
- 执行路径是否会因为中间结果而变化?
- 这种变化是否很难穷举成稳定规则?
- 任务价值是否足以覆盖更高的成本、延迟和风险?
如果前两个问题都是“否”,通常不需要 Agent。
更适合 Chatbot 的场景
- 解释一个概念;
- 总结用户已经提供的文章;
- 根据明确上下文改写文案;
- 对一小段代码给出建议。
更适合 Workflow 的场景
- 每天按固定口径生成报表;
- 在系统之间同步数据;
- 执行步骤明确的审批流程;
- 按确定规则跑 lint、测试和部署。
更适合 Agent 的场景
- 分析页面转化率下降的原因,需要按异常继续取数;
- 审查一个 PR,需要根据变更类型选择检查路径;
- 修复 GitHub Issue,需要读代码、定位、修改并验证;
- 在多个资料源中调查问题,并根据证据缺口继续搜索。
即使适合 Agent,也不意味着第一版就要完全自动。通常更稳的起点是:允许它自主读取和分析,先把写入动作做成草稿或 Patch,交给用户确认。
六、前端和后端工程师分别会碰到什么
Agent 不是只属于模型工程师。
对前端工程师来说,它更像一个“状态由后端持续推进的异步产品流程”。界面需要表达:
- 当前在做什么;
- 已经找到什么;
- 为什么需要用户确认;
- 如何取消、重试或接管;
- 最终产物和中间过程如何区分。
如果界面只放一个聊天气泡,长任务的进度、失败和权限确认就很难讲清楚。
对后端或全栈工程师来说,它更像一个“由模型参与路由的受控任务执行器”。服务端需要负责:
- 工具注册和参数校验;
- 状态持久化与恢复;
- 超时、重试和幂等;
- 用户身份与资源权限;
- 日志、Trace 和成本统计。
模型可以建议下一步,但系统正确性仍然是工程代码的责任。
七、三个常见误区
“越自主越像 Agent”
自主范围不是质量指标。好的 Agent 会在低风险、可验证的范围内自主,在高风险动作前停下来请求确认。
“用了 Tool Calling 就是 Agent”
一次模型调用也可以触发一个工具。只有当工具结果会影响下一步选择,并形成可停止的执行闭环时,系统才更接近 Agent。
“Agent 就等于 Multi-Agent”
单个 Agent 已经可以完成很多复杂任务。Multi-Agent 只是把规划、执行或审查分给多个角色的一种架构选择,会额外引入通信、状态一致性和成本问题,不是入门前提。
八、课后练习:先判断,再设计
请先判断下面的系统更像 Chatbot、Workflow 还是 Agent,并写下判断依据。
- 用户问“什么是 React Server Components”,系统直接解释。
- 每天早上自动拉取 GA4 数据并发送固定格式日报。
- 用户要求分析页面转化率下降原因,系统先查 GA4,再根据异常决定是否继续查 GSC 和广告数据。
- 用户上传 PDF,系统总结文档内容。
- 用户要求修复一个 Issue,系统读取仓库、定位问题、生成 Patch 并运行测试。
参考答案:
- 1 更像 Chatbot,因为它完成一次回答;
- 2 更像 Workflow,因为执行路径预先固定;
- 3 更像 Agent,因为后续取数由中间结果决定;
- 4 通常仍是 Chatbot,上传文件并不会自动让系统变成 Agent;
- 5 是典型 Code Agent,但写入仓库和提交 PR 前仍应设置权限边界。
真正值得练习的不是记住答案,而是每次都追问:谁决定下一步,依据是什么,动作有没有改变任务状态?
九、这一篇真正要记住的事
Agent 不是更会聊天的模型,而是一个会推进任务的系统。
判断一个系统是否接近 Agent,先看三点:
- 它有没有需要完成的目标;
- 它会不会根据中间结果选择动作;
- 它能不能通过工具读取或改变环境。
再看它是否有清晰边界:工具范围、成本限制、权限规则和停止条件。
如果任务路径稳定,优先使用 Workflow;如果一次生成就能解决,使用 Chatbot。只有当任务确实需要在不确定环境里持续取证和决策时,Agent 带来的复杂度才值得。
下一篇预告
现在我们已经知道 Agent 的关键是“根据结果决定下一步”。下一篇会把这句话落到运行时:
一次输入怎样变成决策,决策怎样触发行动,行动结果又怎样回到下一轮?
我们会实现一个最小但可停止、可检查的 Agent Loop。